10 Snakemake与可复现分析工作流
本章提要
本章把前面各章用过的分析命令组织成可复现的工作流。我们先理解为什么需要工作流管理器——以文件依赖而不是脚本顺序来组织计算——然后安装 Snakemake,掌握规则、输入输出、通配符、样本表与配置文件这些核心语法,并学会用试运行、日志和重跑机制管理一次真实的分析。随后把第 5 章的 RNA-seq 流程(FastQC、cutadapt、HISAT2、featureCounts)和第 6 章的 ATAC-seq 流程(fastp、Bowtie 2、去线粒体与去重、Tn5 偏移校正、MACS3 找峰)分别写成完整的 Snakemake 工作流,给出可以直接使用的 Snakefile、样本表、配置文件与环境定义。完成本章后,你可以把任何一章的单条命令升级为只重算必要步骤、能中断恢复、别人可以重跑的工作流。
10.1 Snakemake 的安装与基本语法
先理解工作流管理器解决什么问题,再掌握构成最小流程的核心语法。
为什么需要工作流管理器
回想第 6 章处理四个 ATAC-seq 样本的方式:把同一串命令写进 for 循环,一个样本接一个样本地跑。这在样本少、步骤短时够用,但真实项目里会遇到三个问题:
- 中途失败后,需要手工安排重跑。 循环跑到第三个样本的比对步骤失败了,前两个样本已经完成的结果还在,但你只能注释掉前两行重跑,或者手工记录”跑到哪里了”。步骤越多、样本越多,运行进度就越难记录。
- 改一个参数,下游要重算什么全靠记忆。 换了一版基因注释,哪些结果文件受了影响?哪些需要重跑、哪些可以复用?仅靠记忆维护依赖关系,容易遗漏。
- 复现依赖命令历史。 一个月后自己想重跑分析,或同学想复现时,只有一长串终端历史可翻,顺序、参数、软件版本都没有被显式记录。
Snakemake 用另一种思路组织计算:把每一步分析看成一个”规则”(rule),规则声明自己的输入文件、输出文件和执行命令;所有规则通过文件名连接起来,构成一张有向无环图(DAG)。运行时,Snakemake 从你想要的最终文件出发,沿依赖关系反推哪些规则需要执行——输出已经存在且仍然有效的步骤直接跳过,缺失或过期的才重算1。
工作流管理器的基本单位不是”命令”,而是规则:输入文件 → 规则 → 输出文件。规则之间不直接调用,而是通过输入输出文件名建立依赖,整体构成有向无环图。这带来三个直接后果:只需要声明”要哪个文件”,Snakemake 自己算出执行路径;任何一步失败,重跑时只补缺失的部分;上游文件或规则变化后,下游受影响的结果会被自动识别并重算。
同类工具还有 Nextflow、WDL 和图形界面的 Galaxy,思想都是”以依赖关系组织计算”。本书选择 Snakemake,因为它用 Python 语法描述流程、在生物信息社区使用广泛、与 conda 环境结合紧密;学习其他工作流工具时,可以沿用对依赖关系和显式声明的理解,再熟悉各自的操作细节。
安装 Snakemake
Snakemake 是一个 Python 程序,需要 Python 3.11 或更高版本(2026 年 10 月核对)。沿用第 2 章安装的 conda/mamba 体系,用 micromamba 建一个独立环境(conda 用户把命令换成 conda create 即可,参数相同):
没有 conda 时也可以用 pip 在虚拟环境里安装(python3 -m venv 建环境、pip install snakemake),官方安装说明见 Snakemake 文档。Windows 不是原生支持的平台,官方建议在 WSL 里按 Linux 方式安装。
Snakemake 的每规则独立环境功能(--use-conda,见本节末尾)要求 conda 命令与 Snakemake 安装在同一个环境或基础环境中——micromamba 默认不提供 conda 命令。本章两条实战流程采用更简单的方式:每个流程用一个环境文件装齐全部工具,不依赖 --use-conda;需要每规则环境时,在安装 Snakemake 的环境里再装上 conda 包即可。
第一个可运行的 Snakefile
新建一个练习目录 ch10-demo,手工准备一份输入数据,然后写出第一个流程文件。Snakemake 默认在当前目录寻找名为 Snakefile 的文件:
Snakefile 就是一段 Python,核心是 rule 块。我们写一条规则:统计 A.txt 的词数,结果存到 results/A.count:
一条规则由四个基本部分组成:input 声明依赖哪些文件;output 声明这条规则负责生成哪些文件;shell 是实际执行的命令;rule 后面的 wordcount 是规则名。命令里的 {input} 和 {output} 是占位符,运行前会被替换成上面声明的实际文件名——所以这条规则执行的命令是 wc -w data/A.txt > results/A.count。
无需另写调用脚本,在 ch10-demo 目录里运行 Snakemake,并告诉它最多可以用几个 CPU 核心:
试运行(-n,即 --dry-run)会列出将要执行的任务和理由;这个习惯值得保持——改完流程先 -n 看一眼依赖判断是否如你所料,再真正运行。正式运行的输出中每个任务完成后会打印进度(如 1 of 1 steps (100%) done),results/A.count 里是词数 5。results/ 目录不需要事先创建,Snakemake 会自动为输出文件建立缺失的目录。
现在再跑一次同样的命令:
Building DAG of jobs...
Nothing to be done (all requested files are present and up to date).可以看到,输出已存在且仍然有效时,什么都不做。把 data/A.txt 的内容改掉再运行,Snakemake 会重新执行这一条规则;只 touch 一下文件(修改时间变了、内容没变)则不会重跑——Snakemake 在 .snakemake/ 目录里记录了每次运行的元数据,判断”变没变”比的不是单纯的时间戳(细节见本节 表 10.1 )。
还有一个问题:Snakemake 怎么知道要生成 results/A.count?答案是默认目标 = Snakefile 里的第一条规则。因此惯例是把第一条规则写成 all,它不执行任何命令,只列出整个流程的最终交付文件:
以后无论流程长到多少条规则,snakemake -c 1 永远从 all 列出的最终文件出发倒推依赖;也可以在命令行直接指定任何中间文件作为目标(如 snakemake -c 1 results/A.count),只重算到达它的那部分。
通配符与多样本扩展
真实项目不会只有一个样本。再准备 data/B.txt 和 data/C.txt 两份输入,然后把路径里代表样本的部分换成通配符 {sample}:
两处新写法:output 里的 {sample} 是通配符占位,input 里同名占位与之对应——要生成 results/A.count,就取 sample=A,输入随之解析为 data/A.txt。expand("results/{sample}.count", sample=SAMPLES) 则把模板展开成具体文件列表:results/A.count、results/B.count、results/C.count。
运行 snakemake -n -c 2,会看到 4 个任务:三个样本各自的 wordcount,加上 all。正式运行一遍,然后删掉中间一个输出再运行——Snakemake 只补算被删的那一个任务,其余两个样本的结果原封不动:
rm results/B.count
snakemake -c 2 # 只重跑 B 的 wordcount(以及 all)这一机制也用于失败恢复:四个样本的比对跑到第三个断了,重跑时前两个直接跳过。注意通配符的取值是从输出路径推断的,所以一条规则的输出里必须真的含有 {sample} 这样的占位符;输入里可以引用同名占位符,但不能凭空引入输出里没有的通配符。
样本表与配置文件
SAMPLES = ["A", "B", "C"] 写在 Snakefile 里仍有个隐患:每加一个样本都要改代码,而规则代码的变化本身会触发下游重算(见 表 10.1 )。更好的做法是把”数据是什么”与”怎么算”分开:样本清单放进样本表,路径和参数放进配置文件。
sample  group
A   control
B   control
C treatedsamples: "samples.tsv"Snakefile 开头读入这两者(pandas 需要在环境里可用):
import pandas as pd

configfile: "config.yaml"

samples = pd.read_csv(config["samples"], sep="\t", dtype=str)
SAMPLES = samples["sample"].tolist()

rule all:
    input:
        expand("results/{sample}.count", sample=SAMPLES),
        "results/summary.txt"

rule wordcount:
    input:
        "data/{sample}.txt"
    output:
        "results/{sample}.count"
    log:
        "logs/{sample}.wc.log"
    threads: 2
    shell:
        "wc -w {input} > {output} 2> {log}"

rule summarize:
    input:
        expand("results/{sample}.count", sample=SAMPLES)
    output:
        "results/summary.txt"
    shell:
        "cat {input} > {output}"
configfile: 指令读入 YAML 配置,config[...] 取其中的键。这个例子包含了实际流程的主要组成部分:样本表提供样本与分组(group 列现在没用上,到 10.2 节它就是差异分析的分组依据);log: 指令为每个任务单独保存日志;threads: 声明一个任务想用几个核心;summarize 这类汇总规则把所有样本的中间结果收集成一个最终文件。改配置文件(比如接头序列、参考路径)不算改规则代码,但通过 params: 进入命令的配置值变化同样会触发重算——这是有意设计:影响结果的输入变了,结果就该重算。
运行、日志与失败恢复
运行流程时,需要留意以下几点:
- 并行由两层控制。
threads:是单个任务声明的核心数,命令行-c(--cores)限制整个流程同时可用的核心总数;Snakemake 会据此决定同时跑几个任务。-p(--printshellcmds)在执行前打印每条实际命令,排查问题很有用。 - 每个任务有日志。
log:指定的文件(如logs/{sample}.wc.log)承接命令的报错输出;目录会自动创建。任务失败时,先看屏幕上的报错和该任务的logs/文件,再查.snakemake/log/里 Snakemake 自身的运行日志。 - 重算不是”全部重来”。 Snakemake 记录每次运行的元数据(代码、参数、输入清单、输入校验和、软件环境),据此判断哪些任务需要重跑,见 表 10.1 。
| 触发条件 | 含义 | 典型场景 |
|---|---|---|
| 输出文件缺失 | 输出不存在,规则必须执行 | 删了某个中间文件、首次运行 |
| 输入内容变化 | 输入比输出新,且校验和与上次记录不同 | 重新下载了 FASTQ、换了注释文件 |
| 规则代码变化 | shell: 命令本体改了 |
修正参数、换命令 |
| 参数变化 | params: 引用的值变了 |
配置文件里改了接头或阈值 |
| 输入集合变化 | 输入文件的清单本身变了 | 样本表加了新样本 |
| 软件环境变化 | 每规则 conda 环境的定义变了 | 升级了环境文件里的工具版本 |
| 上次运行中断 | 输出被标记为不完整 | 任务被杀、断电、断网 |
表注:本表按 2026 年 10 月的 9.x 版本核对;所列触发条件默认全部启用。
对应的常用恢复手段:中断的任务用 snakemake --rerun-incomplete -c 8 补跑(--ri 是简写);强制重算某个目标用 -f;想让整个流程从头再来用 -R all。只改了文件时间戳而内容没变时不会触发重跑——这就是上一小节 touch 不重算的原因,也是”判断依据是内容而不只是时间”的好处。
把依赖关系画出来检查,是流程写完后值得做的一步:
# 输出 dot 格式的 DAG,交给 Graphviz 渲染成图片
snakemake --dag -c 8 | dot -Tsvg > dag.svg
最后是两个进阶能力,本章实战流程不依赖它们,但真实项目常用:一是 --use-conda,配合规则里的 conda: "envs/xxx.yaml" 指令,让每条规则在各自独立、版本固定的 conda 环境中执行(前置条件见本节开头的注意框);二是 --report report.html,生成一份把关键结果文件、统计和运行环境打包在内的自包含 HTML 报告,方便随论文或课题报告一起交付。
10.2 RNA-seq 的 Snakemake 流程
把第 5 章的 RNA-seq 分析组织成一条完整、可增量重跑的工作流。
第 5 章的主案例是 METTL3 敲降的 HEK293T 转录组数据(5.2 节):对照与敲降各两个生物学重复,四个样本,链特异性 mRNA 文库、双端 100 bp。每一步的生物学理由和工具选择都已在第 5 章讲过——FastQC 质控、cutadapt 去接头、HISAT2 剪接感知比对、featureCounts 基因水平定量;下面将这些命令组织成 Snakemake 流程,从原始 FASTQ 一直走到差异分析需要的计数矩阵。
项目结构与样本表
为流程单独建一个目录,分别存放数据、参考、结果和日志:
rnaseq/
├── Snakefile            # 流程本体(下一小节)
├── config.yaml          # 配置:路径、接头、链特异性
├── samples.tsv          # 样本表
├── envs/
│   └── rnaseq.yaml      # 流程环境定义
├── raw/                 # 原始 FASTQ:{样本}_1.fastq.gz / {样本}_2.fastq.gz
├── reference/
│   ├── hisat2_index/    # HISAT2 索引(5.3 节构建)
│   └── hg38_refseq_from_ucsc.rm_XM_XR.fix_name.gtf
├── results/             # 全部输出(自动创建)
└── logs/ # 全部任务日志(自动创建)原始数据按5.2 节的 prefetch + fasterq-dump 下载四个 Run,重命名成 raw/{样本}_1.fastq.gz 与 {样本}_2.fastq.gz 的统一约定;HISAT2 索引按5.3 节构建。样本表把样本和分组写在一起——condition 列就是第 5 章差异分析的分组依据,下游做 DESeq2 时直接取用:
sample  condition
SRR1573494  control
SRR1573495  control
SRR1573498  METTL3_kd
SRR1573499  METTL3_kd
配置文件集中存放”换一批数据就要改”的内容:参考路径、接头序列、链特异性参数。接头用 Illumina TruSeq 标准序列;strandedness: 2 对应 featureCounts 的 -s 2(read1 比对在反义链),与5.4 节链特异性文库用 htseq-count -s reverse 是同一个事实的两种写法:
环境定义沿用第 6 章的做法,一个环境装齐整条流程的工具(subread 提供 featureCounts 命令;Snakemake 读样本表需要 pandas):
micromamba create -n ch10_rnaseq -f envs/rnaseq.yaml
micromamba activate ch10_rnaseq
完整的 Snakefile
下面是完整的流程文件。命令体与第 5 章一致,只把路径改成了流程目录的结构:
import pandas as pd

configfile: "config.yaml"

SAMPLES = pd.read_csv(config["samples"], sep="\t", dtype=str)
SAMPLE_IDS = SAMPLES["sample"].tolist()

rule all:
    input:
        "results/counts/featureCounts.txt",
        "results/counts/featureCounts.txt.summary",
        expand("results/bam/{sample}.bam", sample=SAMPLE_IDS),
        expand("results/bam/{sample}.bam.bai", sample=SAMPLE_IDS),
        "results/multiqc/multiqc_report.html",

rule fastqc_raw:
    input:
        r1="raw/{sample}_1.fastq.gz",
        r2="raw/{sample}_2.fastq.gz",
    output:
        html=["results/qc/fastqc/{sample}_1_fastqc.html",
              "results/qc/fastqc/{sample}_2_fastqc.html"],
        zip=["results/qc/fastqc/{sample}_1_fastqc.zip",
             "results/qc/fastqc/{sample}_2_fastqc.zip"],
    log:
        "logs/fastqc/{sample}.log",
    threads: 2
    shell:
        "fastqc --threads {threads} --outdir results/qc/fastqc "
        "{input.r1} {input.r2} > {log} 2>&1"

rule cutadapt:
    input:
        r1="raw/{sample}_1.fastq.gz",
        r2="raw/{sample}_2.fastq.gz",
    output:
        r1="results/clean/{sample}_1.clean.fq.gz",
        r2="results/clean/{sample}_2.clean.fq.gz",
    log:
        "logs/cutadapt/{sample}.log",
    threads: 6
    params:
        a=config["adapter_r1"],
        A=config["adapter_r2"],
    shell:
        "cutadapt -j {threads} --times 1 -e 0.1 -O 3 "
        "--quality-cutoff 25 -m 55 "
        "-a {params.a} -A {params.A} "
        "-o {output.r1} -p {output.r2} "
        "{input.r1} {input.r2} > {log} 2>&1"

rule hisat2_align:
    input:
        r1=rules.cutadapt.output.r1,
        r2=rules.cutadapt.output.r2,
    output:
        bam="results/bam/{sample}.bam",
    log:
        "logs/hisat2/{sample}.log",
    threads: 8
    params:
        index=config["hisat2_index"],
    shell:
        "hisat2 -p {threads} -x {params.index} "
        "-1 {input.r1} -2 {input.r2} 2> {log} "
        "| samtools sort -@ {threads} -o {output.bam} -"

rule samtools_index:
    input:
        "results/bam/{sample}.bam",
    output:
        "results/bam/{sample}.bam.bai",
    log:
        "logs/samtools_index/{sample}.log",
    threads: 2
    shell:
        "samtools index -@ {threads} {input} > {log} 2>&1"

rule feature_counts:
    input:
        bams=expand("results/bam/{sample}.bam", sample=SAMPLE_IDS),
        gtf=config["annotation"],
    output:
        counts="results/counts/featureCounts.txt",
        summary="results/counts/featureCounts.txt.summary",
    log:
        "logs/featureCounts.log",
    threads: 8
    params:
        stranded=config["strandedness"],
    shell:
        "featureCounts -t exon -g gene_id -Q 10 --primary "
        "-s {params.stranded} -p -T {threads} "
        "-a {input.gtf} -o {output.counts} {input.bams} > {log} 2>&1"

rule multiqc:
    input:
        fastqc=expand("results/qc/fastqc/{sample}_1_fastqc.html", sample=SAMPLE_IDS),
        cutadapt=expand("logs/cutadapt/{sample}.log", sample=SAMPLE_IDS),
        hisat2=expand("logs/hisat2/{sample}.log", sample=SAMPLE_IDS),
        featurecounts="logs/featureCounts.log",
    output:
        "results/multiqc/multiqc_report.html",
    log:
        "logs/multiqc.log",
    threads: 2
    shell:
        "multiqc --outdir results/multiqc {input} > {log} 2>&1"
几个值得注意的写法:
all就是交付清单。 它列出计数矩阵(含 summary)、四个排序 BAM 及索引、MultiQC 报告。想让某个中间文件在运行结束后保留,把它加进all即可——比如想在 IGV 里查看比对,BAM 与.bai都在。- 具名输入输出与规则间引用。
r1="raw/{sample}_1.fastq.gz"给文件起了名字,命令里用{input.r1}引用;hisat2_align的输入直接写rules.cutadapt.output.r1,由文件引用明确依赖关系,改 cutadapt 的输出路径时下游自动跟随。 - 管道与日志的分工。
hisat2_align里 HISAT2 的比对汇总走标准错误流,用2> {log}存档;比对结果经管道直接交给samtools sort,不落地未排序的 SAM——省空间,也少一类中间文件。 - 汇总型规则没有通配符。
feature_counts一次读入所有样本的 BAM(expand展开),multiqc把各类日志当作普通输入文件收集。它们与每样本规则一起,构成”先分后合”的完整 DAG。 - 配置进入命令要走
params:。 接头、索引前缀、链特异性都经params:进入命令——改config.yaml就能换一批数据,且参数变化会正确触发下游重算。
运行流程与检查结果
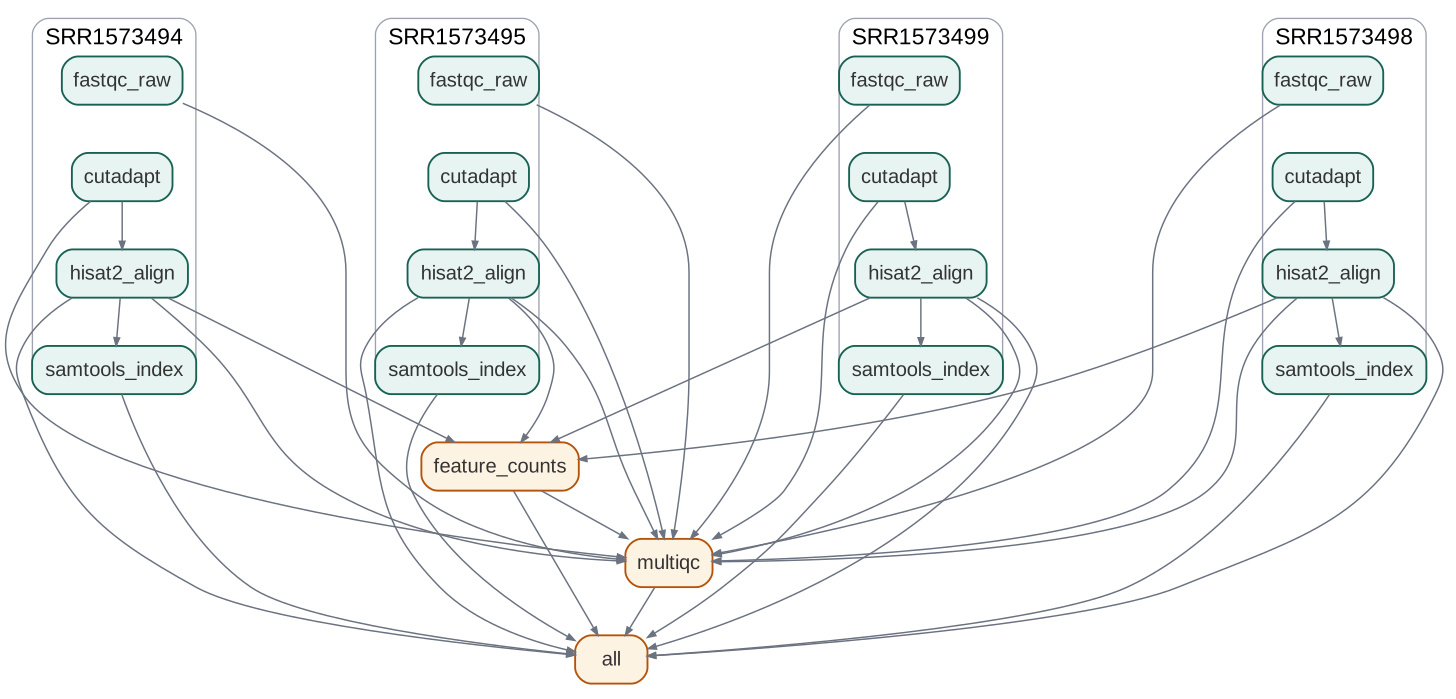
图注:图由上面的 Snakefile 通过 Snakemake 生成;框内是任务对应的规则名,外框按样本分组。绿色节点属于逐样本任务,琥珀色节点汇总多个样本的结果或日志。图保留了全部 19 个任务和 35 条文件依赖;只解析依赖即可生成,无须先运行完生信分析。可打开原尺寸 DAG查看各条连线。
读 图 10.1 时沿箭头看前置条件:每个样本的 hisat2_align 要等待自己的 cutadapt;feature_counts 要等待四个 BAM;multiqc 则汇总质控和分析日志。fastqc_raw 与 cutadapt 都读取原始 FASTQ,彼此没有依赖,因此允许并行;samtools_index 与 feature_counts 也都使用已生成的 BAM,后者不需要等索引。图中竖向排在一起只是便于按样本阅读,只有箭头才表示依赖关系;实际同时运行多少任务还受线程和其他资源限制。最下方的 all 是最终文件清单,本身不执行分析命令。
四个样本、七条规则,试运行会报告 19 个任务(4 个 fastqc_raw + 4 个 cutadapt + 4 个 hisat2_align + 4 个 samtools_index + feature_counts + multiqc + all)。运行中断后重新执行同样的命令即可:已完成的任务直接跳过,被标记为不完整的输出自动补跑。本章流程的规则、依赖与命令展开在写作时通过了 Snakemake 9.27 的试运行检查;各工具命令与第 5 章实测口径一致。
结果检查沿用第 5 章的口径:results/counts/featureCounts.txt.summary 里看 Assigned 比例——落到注释基因上的 read 占比,人类样本通常应有六成以上,明显偏低时先怀疑注释与参考基因组不同源(5.2 节的混用陷阱)或存在污染;logs/hisat2/ 里每个样本的总体比对率(人类 RNA-seq 一般应有 80% 以上,多定位 read 通常不超过 10%);results/multiqc/multiqc_report.html 把这些指标汇总在同一页,可以横向比较四个样本,找出异常。计数矩阵 featureCounts.txt 的每一列对应 samples.tsv 里一个样本,接下来就交回5.5 节的 DESeq2 做差异分析——本节工作流到计数矩阵为止,R 中的统计分析按相应章节继续。
这条流程的可复用性来自显式声明,也正因为如此,换一批数据时必须核对声明是否还成立:样本表是否更新;strandedness 与新文库的建库方式是否一致(非链特异性文库要改回 0);adapter 序列是否匹配新接头;参考索引与 GTF 是否同源(5.2 节的混用陷阱)。流程会按这些设置执行,设置与数据不匹配时,错误也会传到后续结果中。
10.3 ATAC-seq 的 Snakemake 流程
用同一条工作流骨架组织 ATAC-seq,并练习向新任务迁移。
第 6 章 6.5 节的 ATAC-seq 案例是 Irf8 敲除小鼠的造血干细胞数据:野生型与敲除各两个重复(SRR5852294–2297),从 FASTQ 到过滤后 BAM、片段分布、TSS 富集度与峰集合。它与 RNA-seq 流程共用同一套骨架(样本表、配置、每样本规则 + 汇总规则),但多了三类 ATAC 特有环节:比对与过滤的参数不同(-X 2000 容纳核小体片段、去线粒体、去重);Tn5 偏移校正;以及用配对末端信息直接找峰与 ataqv 质控。每一步的生物学理由见6.5 节,这里专注组织方式。
项目结构与样本表
目录结构与 RNA-seq 流程完全相同,只是参考换成小鼠 mm10 的 Bowtie 2 索引(6.3 节)和 TSS 注释文件:
atac/
├── Snakefile
├── config.yaml
├── samples.tsv
├── envs/
│   └── atac.yaml
├── raw/                 # {样本}_1.fastq.gz / {样本}_2.fastq.gz
├── reference/
│   ├── mm10.1.bt2 ...   # Bowtie 2 索引前缀 reference/mm10
│   └── mm10_tss.bed     # 与 BAM 染色体命名一致的 TSS 注释(6.5 节)
├── results/
└── logs/
sample condition
SRR5852294 WT
SRR5852295 WT
SRR5852296 KO
SRR5852297 KO环境沿用第 6 章的版本口径(macs 包装的是 macs3 命令;deeptools 提供 alignmentSieve):
完整的 Snakefile
import pandas as pd

configfile: "config.yaml"

SAMPLES = pd.read_csv(config["samples"], sep="\t", dtype=str)
SAMPLE_IDS = SAMPLES["sample"].tolist()

rule all:
    input:
        expand("results/bam/{sample}.final.bam", sample=SAMPLE_IDS),
        expand("results/bam/{sample}.final.bam.bai", sample=SAMPLE_IDS),
        expand("results/bam/{sample}.shifted.bam", sample=SAMPLE_IDS),
        expand("results/peaks/ATAC_{sample}_peaks.narrowPeak", sample=SAMPLE_IDS),
        expand("results/qc/fragment_dist_{sample}.txt", sample=SAMPLE_IDS),
        expand("results/qc/ataqv_{sample}.txt", sample=SAMPLE_IDS),

rule fastp_atac:
    input:
        r1="raw/{sample}_1.fastq.gz",
        r2="raw/{sample}_2.fastq.gz",
    output:
        r1="results/clean/{sample}_1.clean.fq.gz",
        r2="results/clean/{sample}_2.clean.fq.gz",
    log:
        "logs/fastp/{sample}.log",
    threads: 8
    shell:
        "fastp --thread {threads} --detect_adapter_for_pe "
        "-i {input.r1} -I {input.r2} "
        "-o {output.r1} -O {output.r2} "
        "-h results/qc/{wildcards.sample}.fastp.html "
        "-j results/qc/{wildcards.sample}.fastp.json > {log} 2>&1"

rule bowtie2_align:
    input:
        r1=rules.fastp_atac.output.r1,
        r2=rules.fastp_atac.output.r2,
    output:
        flt="results/bam/{sample}.flt.bam",
    log:
        "logs/bowtie2/{sample}.log",
    threads: 8
    params:
        index=config["bowtie2_index"],
    shell:
        "bowtie2 -x {params.index} -p {threads} -X 2000 --very-sensitive "
        "-1 {input.r1} -2 {input.r2} 2> {log} "
        "| samtools view -h -@ {threads} -bS -q 30 -F 1804 -o {output.flt} -"

rule remove_chrM:
    input:
        rules.bowtie2_align.output.flt,
    output:
        bam="results/bam/{sample}.ns.bam",
        idxstats="results/qc/{sample}.idxstats.txt",
    threads: 6
    shell:
        "samtools idxstats {input} | awk '$3>0' > {output.idxstats}; "
        "samtools view -h -@ {threads} -o - {input} "
        "| awk 'BEGIN{{OFS=\"\\t\"}} /^@/{{print; next}} "
        "$3!=\"chrM\" && $7!=\"chrM\" {{print}}' "
        "| samtools sort -n -@ {threads} -o {output.bam} -"

rule fixmate:
    input:
        rules.remove_chrM.output.bam,
    output:
        temp("results/bam/{sample}.fx.bam"),
    threads: 6
    shell:
        "samtools fixmate -m -@ {threads} {input} {output}"

rule sort_coord:
    input:
        rules.fixmate.output,
    output:
        temp("results/bam/{sample}.fxs.bam"),
    threads: 6
    shell:
        "samtools sort -@ {threads} -o {output} {input}"

rule markdup:
    input:
        rules.sort_coord.output,
    output:
        "results/bam/{sample}.final.bam",
    log:
        "logs/markdup/{sample}.log",
    threads: 6
    shell:
        "samtools markdup -r -@ {threads} -s {input} {output} 2> {log}"

rule samtools_index:
    input:
        "results/bam/{sample}.final.bam",
    output:
        "results/bam/{sample}.final.bam.bai",
    threads: 2
    shell:
        "samtools index -@ {threads} {input}"

rule tn5_shift:
    input:
        "results/bam/{sample}.final.bam",
    output:
        "results/bam/{sample}.shifted.bam",
    log:
        "logs/alignmentsieve/{sample}.log",
    threads: 4
    shell:
        "alignmentSieve -b {input} -o {output} --ATACshift > {log} 2>&1"

rule fragment_dist:
    input:
        "results/bam/{sample}.final.bam",
    output:
        "results/qc/fragment_dist_{sample}.txt",
    shell:
        "samtools view {input} | awk '$9>0{{print $9}}' "
        "| sort -n | uniq -c "
        "| awk 'BEGIN{{OFS=\"\\t\"}}{{print $2,$1}}' > {output}"

rule macs3_callpeak:
    input:
        "results/bam/{sample}.final.bam",
    output:
        peaks="results/peaks/ATAC_{sample}_peaks.narrowPeak",
        summits="results/peaks/ATAC_{sample}_summits.bed",
    log:
        "logs/macs3/{sample}.log",
    params:
        genome=config["genome_size"],
    shell:
        "macs3 callpeak -t {input} -f BAMPE -g {params.genome} "
        "-n ATAC_{wildcards.sample} -q 0.01 "
        "--outdir results/peaks > {log} 2>&1"

rule ataqv_qc:
    input:
        bam="results/bam/{sample}.shifted.bam",
        peaks="results/peaks/ATAC_{sample}_peaks.narrowPeak",
        tss=config["tss_file"],
    output:
        "results/qc/ataqv_{sample}.txt",
    log:
        "logs/ataqv/{sample}.log",
    shell:
        "ataqv mouse --tss-file {input.tss} "
        "--peak-file {input.peaks} "
        "{input.bam} > {output} 2> {log}"
对照 RNA-seq 流程,注意四个新写法:
- awk 的花括号要写成
{ }。 Snakemake 把{...}当作占位符语法,所以remove_chrM和fragment_dist里 awk 程序的所有花括号都加倍了;这是把 awk 命令搬进 Snakefile 时最常踩的坑,报错通常是”格式串无效”或命令被截断。 - 一条规则可以产出多个文件。
remove_chrM同时产出去掉线粒体的 BAM 和各染色体统计——idxstats先记录、再去 chrM 的顺序在6.5 节解释过:线粒体比例本身是质控指标,不能先删后算。 temp()标记中间文件。 去重需要”按名字排序 → fixmate 标记 → 按坐标排序 → markdup”的链条,fixmate和sort_coord的输出只是中间文件,用temp()包裹后,下游一完成 Snakemake 就自动删除它们。{wildcards.sample}显式取通配符的值。fastp的报告名和macs3的-n项目名用它拼进命令;{wildcards.xxx}永远解析为通配符本身,不会被误认为其他占位符。
运行、检查与迁移
运行方式与 RNA-seq 流程完全一样(snakemake -n -c 8 试运行、snakemake -c 8 -p 正式运行)。四个样本、十一条规则,共 45 个任务。结果检查的口径全部来自6.5 节:logs/bowtie2/ 的比对率(那套数据实测 92% 上下,其中 SRR5852296 只有 46%——是数据集特性而非流程错误,处理方式见第 6 章);fragment_dist_*.txt 画出来应呈现 NFR 峰与约 200 bp 周期的核小体锯齿;ataqv_*.txt 的 TSS 富集度与 FRiP 参照第 6 章的实测与 ENCODE 阈值讨论;四个样本的峰数量与第 6 章 BAMPE 口径的 24,964 / 14,971 / 28,796 / 55,203 应属同一量级。
对照两条流程,可以看出哪些部分能够复用,哪些需要调整:
| 环节 | RNA-seq 流程 | ATAC-seq 流程 |
|---|---|---|
| 过滤 | cutadapt(TruSeq 接头,来自配置) | fastp(--detect_adapter_for_pe 自动识别) |
| 比对 | HISAT2(剪接感知) | Bowtie 2(-X 2000 --very-sensitive) |
| 比对后处理 | samtools sort + index | 过滤 -q 30 -F 1804、去 chrM、fixmate/markdup 去重 |
| 定量 / 找峰 | featureCounts 汇总成计数矩阵 | MACS3 BAMPE 每样本找峰 |
| 实验质控 | MultiQC 汇总 | 片段分布、ataqv(TSS 富集度、FRiP、线粒体比例) |
| 交给下游 | 计数矩阵 → DESeq2(5.5 节) | 峰集合 → IDR 与统一峰(6.6 节) |
骨架不变,变的是每条规则的命令体:换一批 ATAC 样本,只改 samples.tsv;换参考基因组,只改 config.yaml 的索引与 TSS 路径;把比对器换成 BWA,只重写 bowtie2_align 一条规则并核对其输出约定。第 7 章的 WGS 变异流程(比对、标记重复、BQSR、 calling 一路到 VCF)和第 9 章的单细胞分析,同样可以按”每样本规则 + 汇总规则”的方式组织——规则划分的自然单位就是”一次工具调用产出一类文件”。
让 AI 帮忙写或改工作流时,这套结构就是你的核对清单:检查每条规则的输入是否真实存在(路径、命名约定、参考版本)、输出是否与命令实际生成的文件一致(少声明会留下无主文件,多声明会永远判缺失)、通配符能否从输出推断、以及 awk 这类含花括号的命令有没有正确转义。即使 AI 生成的流程通过了语法检查,也仍需核对文件与规则是否一致。运行 dry-run,并逐条对照 all 清单,可以帮助发现这类问题。