4 测序结果的比对
本章提要
本章从参考基因组、参考转录本和基因注释出发,理解序列为什么能够定位到参考资源,以及怎样选择合适的比对策略。我们会介绍双序列比对、mapping 和 BLAST 等概念,练习 SAM/BAM 的查看、转换、排序与过滤,再讨论测序深度、文库复杂度和 IGV 中的结果检查。最后从公共数据库获取数据,把参考资源与实际输入对应起来。学习的重点是理解文件、参数和处理结果之间的联系。
4.1 概览
经过上一章的质控,我们已经有了干净的测序数据(clean reads)。接下来要做的是把处理后的 clean reads 通过比对放回参考基因组,得到记录每条 read 位置与比对情况的 BAM 文件。我们先认识参考基因组与常用注释,也就是比对所需的“地图”,再学习双序列比对、BLAST、哈希表与 BWT 等算法。随后根据数据特点选择软件、完成比对,将结果保存成 SAM/BAM 文件,进行排序、过滤与统计,并用 IGV 查看。最后从公共数据库下载数据,作为练习的输入。
如 图 4.1 所示,从 FASTQ 到 SAM 的每一步都有明确的输入和输出。阅读本章时,可以顺着流程逐步检查:输入的是什么文件,处理后得到什么,又保留了哪些比对信息。
4.2 参考基因组
选取相互兼容的参考资源并理解注释差异。
比对前,先确定所用的参考基因组。它相当于比对的“地图”,是一份由多家研究机构共同维护、尽可能准确和完整的物种 DNA 序列,以 FASTA 格式发布。第 3 章已经介绍了 FASTA,这里还需要留意参考基因组的版本。
- 人类参考基因组最常用的两个版本是 GRCh37(UCSC 称为 hg19,2009 年发布)和 GRCh38(hg38,2013 年发布);2022 年发布的 T2T-CHM13 进一步补全了末端的重复区域。版本越新不代表“更适合所有分析”——大量已有工具、注释和教程仍基于 GRCh37/hg19,本书的教学示例也使用 hg19。关键是全流程保持同一个版本:参考 FASTA、注释文件、软件索引必须来自同一版本,混用会导致坐标错位。
- 常用的下载来源有 UCSC Genome Browser、Ensembl 与 NCBI RefSeq。它们发布的序列基本一致,但染色体命名有细微差别(例如 Ensembl 用
1,UCSC 用chr1),注释的基因集合也不完全相同,后一小节会展开。 - 本书各链接均于 2026 年 10 月核对可访问。网站界面会随版本更新调整,按钮位置可能变化,但操作逻辑是一致的:进入官网,找到下载入口,选好物种与版本,再选格式(FASTA 或 GTF/GFF)。
参考基因组长什么样? 表 4.1 列出了 hg38 每条染色体的长度(数据取自 UCSC hg38 chromInfo,2026 年 10 月核对)。几个值得留意的数字:
- 22 条常染色体加两条性染色体共约 3.09 Gb;最长的 chr1 约 2.49 亿碱基,最短的 chr21 约 4,670 万。
- chrM 只有 16,569 bp,是线粒体基因组:它独立于核基因组、完全来自母系,细胞里拷贝数又极高,比对时 reads 数常常异常多,分析中一般要单独对待(第 7 章 WGS 还会遇到它)。
- 表中的长度包含大量 N:N 代表尚未确定的碱基(着丝粒、端粒附近的高度重复区域),并不是真实的 A/T/C/G。这也解释了为什么参考基因组会不断推出新版本——补全这些区域正是 T2T-CHM13 的主要贡献。
| 染色体 | 长度(bp) | 染色体 | 长度(bp) |
|---|---|---|---|
| chr1 | 248,956,422 | chr13 | 114,364,328 |
| chr2 | 242,193,529 | chr14 | 107,043,718 |
| chr3 | 198,295,559 | chr15 | 101,991,189 |
| chr4 | 190,214,555 | chr16 | 90,338,345 |
| chr5 | 181,538,259 | chr17 | 83,257,441 |
| chr6 | 170,805,979 | chr18 | 80,373,285 |
| chr7 | 159,345,973 | chr19 | 58,617,616 |
| chr8 | 145,138,636 | chr20 | 64,444,167 |
| chr9 | 138,394,717 | chr21 | 46,709,983 |
| chr10 | 133,797,422 | chr22 | 50,818,468 |
| chr11 | 135,086,622 | chrX | 156,040,895 |
| chr12 | 133,275,309 | chrY | 57,227,415 |
| chrM | 16,569 |
那有多少物种已经有了参考基因组?以 NCBI 为例,其 Assembly 数据库 2021 年就突破了 100 万个基因组装配,如今仅原核生物的归档就超过 200 万个,覆盖数万个物种1;真核生物方面,2024 年的统计是已有超过 41,000 个装配、覆盖约 2,300 个已命名物种,且仍在快速增长2。对初学者更重要的是另一个事实:人、小鼠、大鼠、鸡、拟南芥、斑马鱼、酵母等常用模式生物都有维护良好的参考基因组,直接下载即可使用。
构建参考基因组索引
获取到 clean reads 之后,需要把它们回贴(mapping)到参考基因组上——也就是确定每条 read 在参考基因组上的来源位置(alignment 与 mapping 的概念辨析见 4.4.1)。这一步是几乎所有有参考基因组分析的起点,后续 RNA-Seq、ChIP-Seq、WGS 都要用到同样的操作。
但 mapping 面临一个现实问题:输入常常是上千万条 reads,参考基因组又有约 30 亿碱基,逐条做精确比对运算量完全不可行(4.4.2 会算这笔账)。解决之道就是先给参考基因组建立一个索引:把基因组预处理成一套方便快速查询的数据结构,就像给一本 30 亿字的书先编好目录,之后每条 read 的定位都能在瞬间完成。建索引只需要做一次,之后可以反复使用。
常用 mapping 软件的索引格式各不相同,但建好的索引都可以反复用于比对:
- 二代短读长:BWA3、Bowtie4、Bowtie2、HISAT2(RNA-Seq 剪接比对,见 4.5);
- 三代长读长:早期常用 BLASR(用
sawriter建库、blasr比对),当前的事实标准是 minimap2,PacBio 官方流程中的 pbmm2 也是基于它实现的。
软件会更新换代,但“为参考序列建索引、再把 reads 定位上去”的逻辑没有变。以 Bowtie2 为例,建立 index 的输入是参考基因组序列(FASTA 格式)和 1 个我们指定的 index 名称,输出是若干个以该名称为开头的 index 文件:
bowtie2-build hg19_only_chromosome.fa hg19_only_chromosome其中 bowtie2-build 为建立 index 的命令;hg19_only_chromosome.fa 为参考基因组(FASTA 格式);hg19_only_chromosome 是我们指定的 index 名称。执行完成后会生成以它为前缀的 6 个 .bt2 索引文件(形如 hg19_only_chromosome.1.bt2 到 hg19_only_chromosome.rev.2.bt2),调用 index 时使用的名字就是 hg19_only_chromosome。
为什么 Bowtie、Bowtie 2、BWA 的索引能做到又小又快?靠的正是 BWT/FM 索引——具体算法推导在本章 4.4.6 一节,这里先记住结论:有了索引,比对软件可以把序列定位问题的时间复杂度降到对数级别。
问题 1:为什么 FASTQ 文件的快速比对需要建立 index?
参考解答:主要是为了加快比对速度。Index 简单来说就是若干个文件,方便程序快速地访问及搜索基因组;在 Index 的帮助下,比对软件可以把序列比对问题的时间复杂度大大降低。
问题 2:如果从网站上下载的是一个物种的参考转录组序列,其中包含 A、U、C、G 碱基;而我的 FASTQ 是该物种转录组测序的结果,用 A、T、C、G 四种碱基表示。那么建 index 之前,需要把参考转录组中的 U 全部换成 T 吗?
参考解答:需要转化,因为比对程序并不能将 U 直接识别为 T。
请在 Linux 环境下,下载 human genome 19 参考基因组的 1 号染色体序列,并使用 Bowtie 2 建立 index。
参考解答:
- 下载 1 号染色体序列(该链接 2026 年 10 月核对可访问):
wget -c -P ./test https://hgdownload.soe.ucsc.edu/goldenPath/hg19/chromosomes/chr1.fa.gz &
# -P,将文件下载到指定目录中
# -c,断点续传
# &,后台运行- 下载得到的文件为 chr1.fa.gz,是 gzip 压缩格式,先解压:
gzip -d ./test/chr1.fa.gz- 解压得到 chr1.fa,下一步建立 index:
bowtie2-build ./test/chr1.fa ./test/chr1_bowtie2_index- 得到以
chr1_bowtie2_index为前缀的 6 个.bt2文件,注意调用 index 时使用的名字为chr1_bowtie2_index。
4.3 参考转录本与基因注释
为什么需要基因注释
参考基因组提供序列,基因注释文件则在这张“地图”上标出基因、外显子等的位置,供分析软件使用。
我们的基因在基因组上的结构不是连续的,而是被 exon-intron-exon(exon=外显子,intron=内含子)分隔开的。基因要表达,首先会转录出包含 intron 的 pre-mRNA,再经过可变剪接、加 5’ 帽子、3’ PolyA 尾巴等加工过程,才形成成熟的 mRNA( 图 4.2 )。
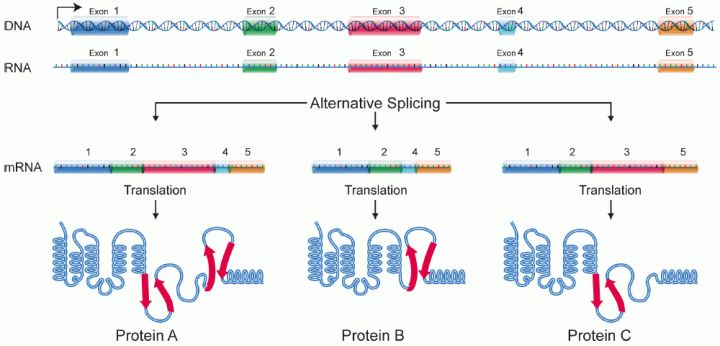
mRNA 由外显子拼接而来,因此转录组比对经常要处理跨越两个外显子的 reads:它们对应的基因组序列中间隔着内含子。这时需要基因注释告诉比对软件 exon 和 intron 的位置。基因注释文件记录的主要内容,就是基因、转录本、外显子和编码区在基因组上的坐标,以及这些特征的属性。
GTF 与 GFF 文件
基因注释文件最常见的两种格式是 GTF(Gene Transfer Format)和 GFF(General Feature Format)。GFF 有若干版本,一般认为 GTF 就是 GFF 2.0 版本;两者只是格式细节不同,信息内容完全可以等价,很多工具可以互相转换。
一个标准的 GTF/GFF2.0 文件每行 9 列,以 TAB 分隔。我们来看人类 SGIP1 基因在 hg19 上的部分真实注释行, 图 4.3 是相同内容的截图:
chr1    hg19_ncbiRefSeq exon    66999252    66999355    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq exon    66999929    67000051    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq start_codon 67000042    67000044    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq CDS 67000042    67000051    0.000000    +   0   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq CDS 67091530    67091593    0.000000    +   2   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq stop_codon  67208776    67208778    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";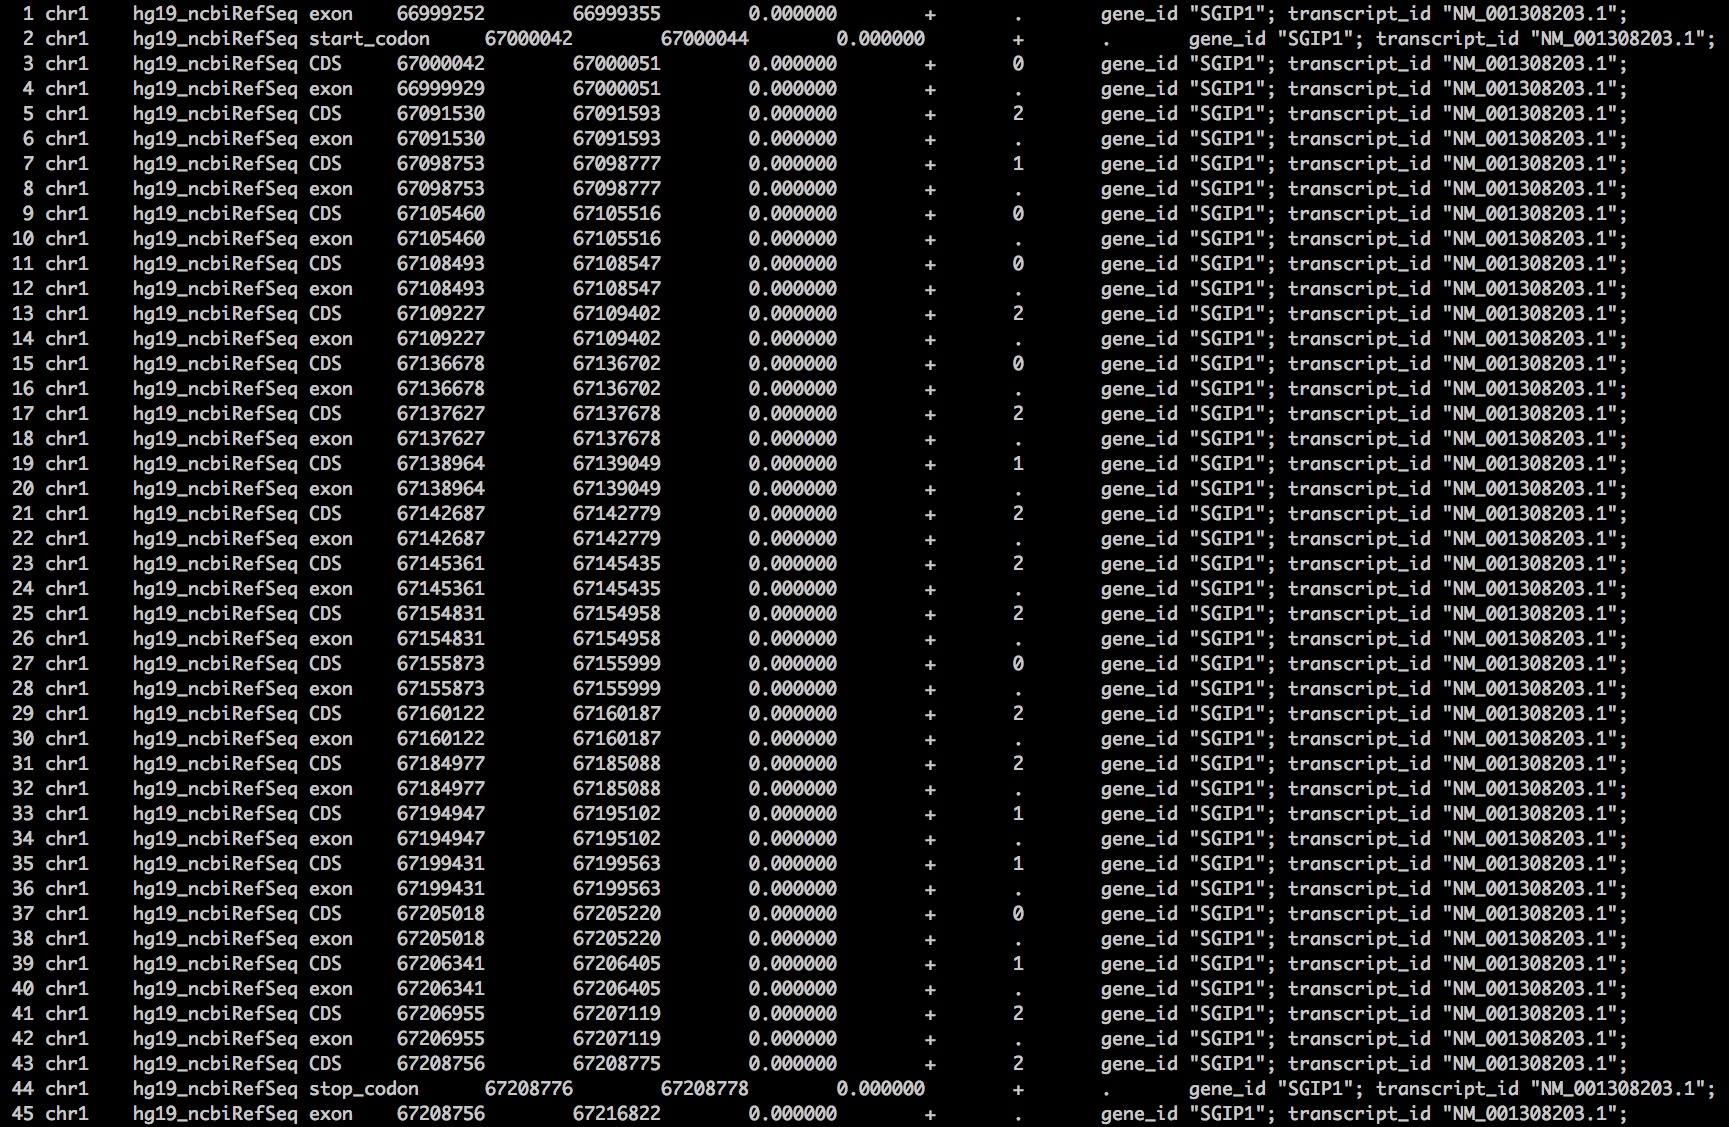
下面对照文件,逐列解释各字段的含义:
- 第 1 列 seqname:
chr1,序列名,一般为染色体名,必须与参考 FASTA 里的名称一致——一个用chr1、另一个用1或Chr1都会造成注释对不上。 - 第 2 列 source:
hg19_ncbiRefSeq,注释来源,通常是数据库名或软件名;没有则用.。 - 第 3 列 feature:
exon、CDS、start_codon、stop_codon,这一行记录的特征类型;常见的还有 gene、mRNA 等。 - 第 4、5 列 start、end:该特征在染色体上的起止坐标,从 1 开始计数、双端都包含。例如第一行 exon 是 66999252 到 66999355,长度就是 66999355-66999252+1=104 bp。
- 第 6 列 score:该条注释可信度的打分,下载的官方注释文件里一般是
0.000000或.。 - 第 7 列 strand:
+正链、-负链。注意无论基因在正链还是负链,start 都小于 end(坐标永远按基因组正方向书写)。 - 第 8 列 frame:读码框,只有 CDS、start_codon、stop_codon 行有意义,取值 0/1/2,表示要跳过几个碱基才遇到完整密码子的第一位(0 即该特征第 1 个碱基就是密码子第 1 位);其他类型用
.。 - 第 9 列 attribute:属性,格式为
tag=value,多个属性以分号分隔;最关键的是gene_id与transcript_id——程序处理时会把相同 gene_id 的行汇总为同一个基因。
再看两条全局规则:9 列一律用 TAB 分隔;前 8 列必须有值,表达“空”用 .,第 9 列内容可长可短。
- seqname 与参考 FASTA 的染色体命名必须一致(
chr1vs1是最常见的坑); - 无论正链负链,start 一律小于 end,负链基因并不是“倒着写坐标”;
- frame 只对编码特征(CDS、start_codon、stop_codon)有意义,其他行是
.。
坐标的起点与区间边界
把一种文件里的区间拿到另一种工具中使用之前,要同时核对参考版本、染色体名称、坐标起点和区间边界,这四件事只要有一件对不上,同一串数字代表的就不是同一段序列。
SAM 文本中的 POS 从 1 开始计数,并且区间两端都包含;BED 通常使用从 0 开始、右端不包含(half-open)的区间。因此 BED 的 99 与 GTF 的 100 可能指同一个碱基。相同的数字不一定表示同一段序列。
以一条染色体上第 100 到第 108 个碱基的区段为例,两种体系的写法对比见 表 4.2 。
| 坐标体系 | 起点 | 终点 | 区段宽度 |
|---|---|---|---|
| GTF/GFF、SAM(1-based,双端包含) | 100 | 108 | 9 |
| BED(0-based,右端不包含) | 99 | 108 | 9 |
系统示例与转换练习待补充。规范来源:SAM/BAM 格式规范。
从公共数据库下载注释文件
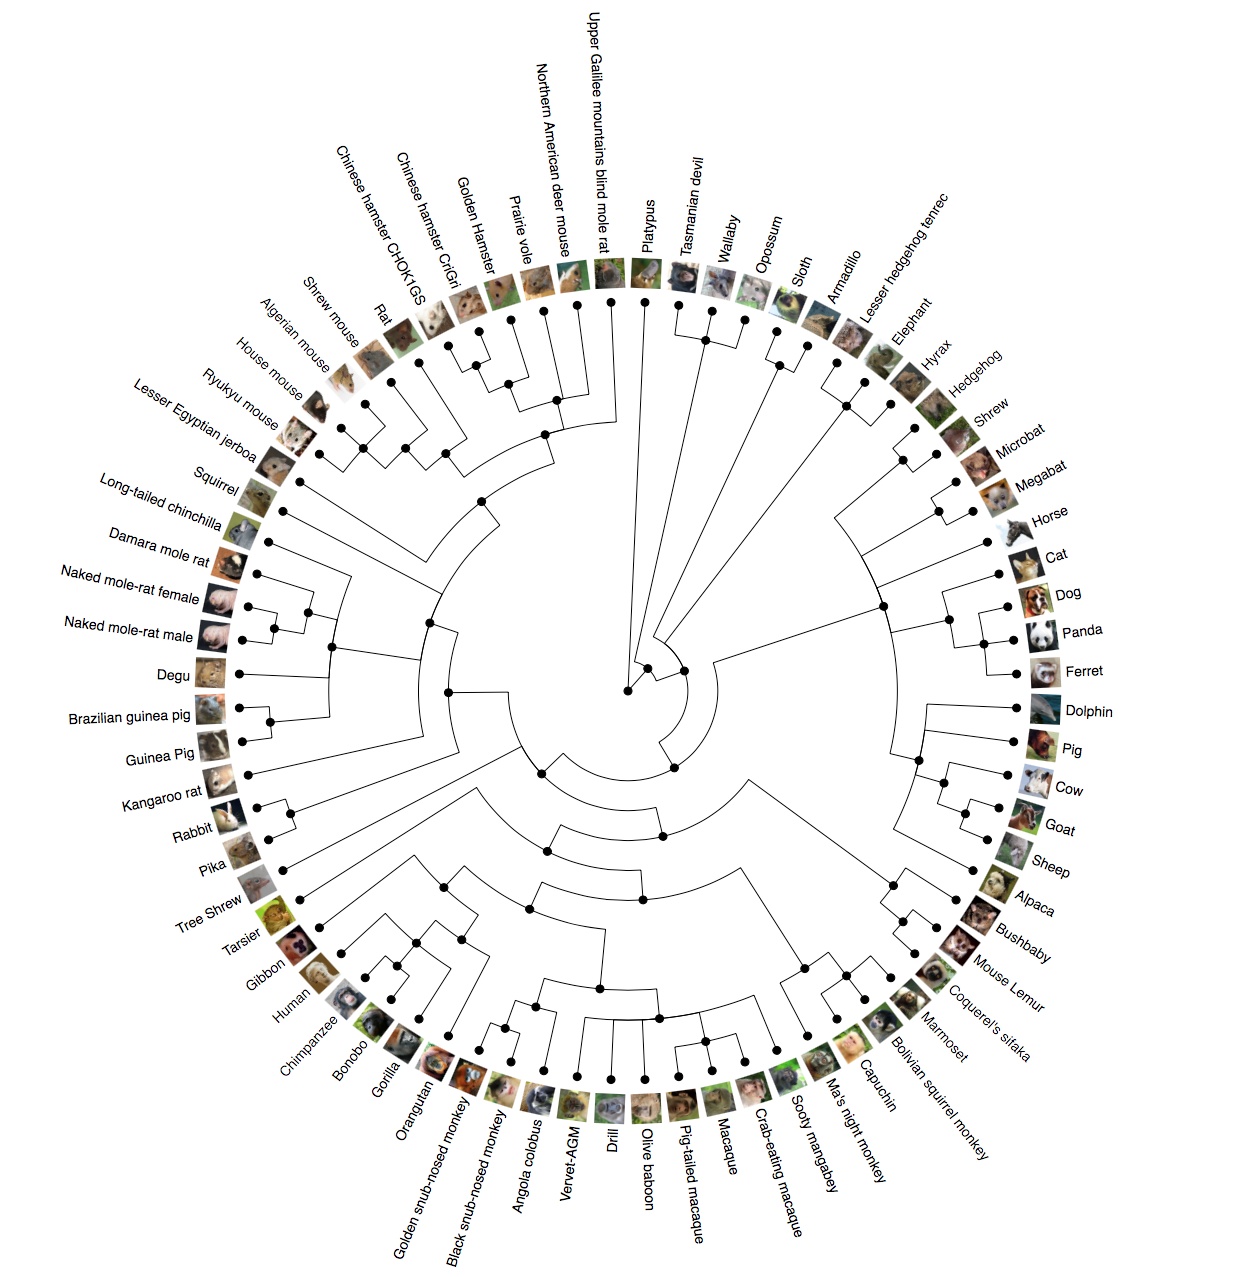
针对已经完成基因组测序计划的物种,数据库一般会同时提供参考基因组序列(FASTA)与转录组注释(GTF/GFF)。 图 4.4 是 Ensembl 展示的已公布参考基因组的哺乳动物系统发生树——常用的模式生物(人、小鼠、大鼠、鸡、拟南芥等)都已经有非常好的注释资源,直接到网站上下载即可。下载下来的 FASTA 就是参考基因组(用于建索引),GTF 是转录组注释(一般在计算表达量时提供)。
下载 GTF/GFF 最常用的两个网站是 UCSC Genome Browser(https://genome.ucsc.edu)和 Ensembl(https://www.ensembl.org);注意植物要使用 Ensembl 的专门站点 Ensembl Plants(https://plants.ensembl.org)。
小提示:以下操作截图摄于 2018 年前后(本书资料整理时期),2026 年 10 月核对各网站与链接仍可访问。网站界面会随版本更新调整,按钮位置可能变化,但操作逻辑是一致的:进入网站,找到数据入口,选好物种与版本,再选择注释格式下载。
从 UCSC Table Browser 下载 human 的 GTF
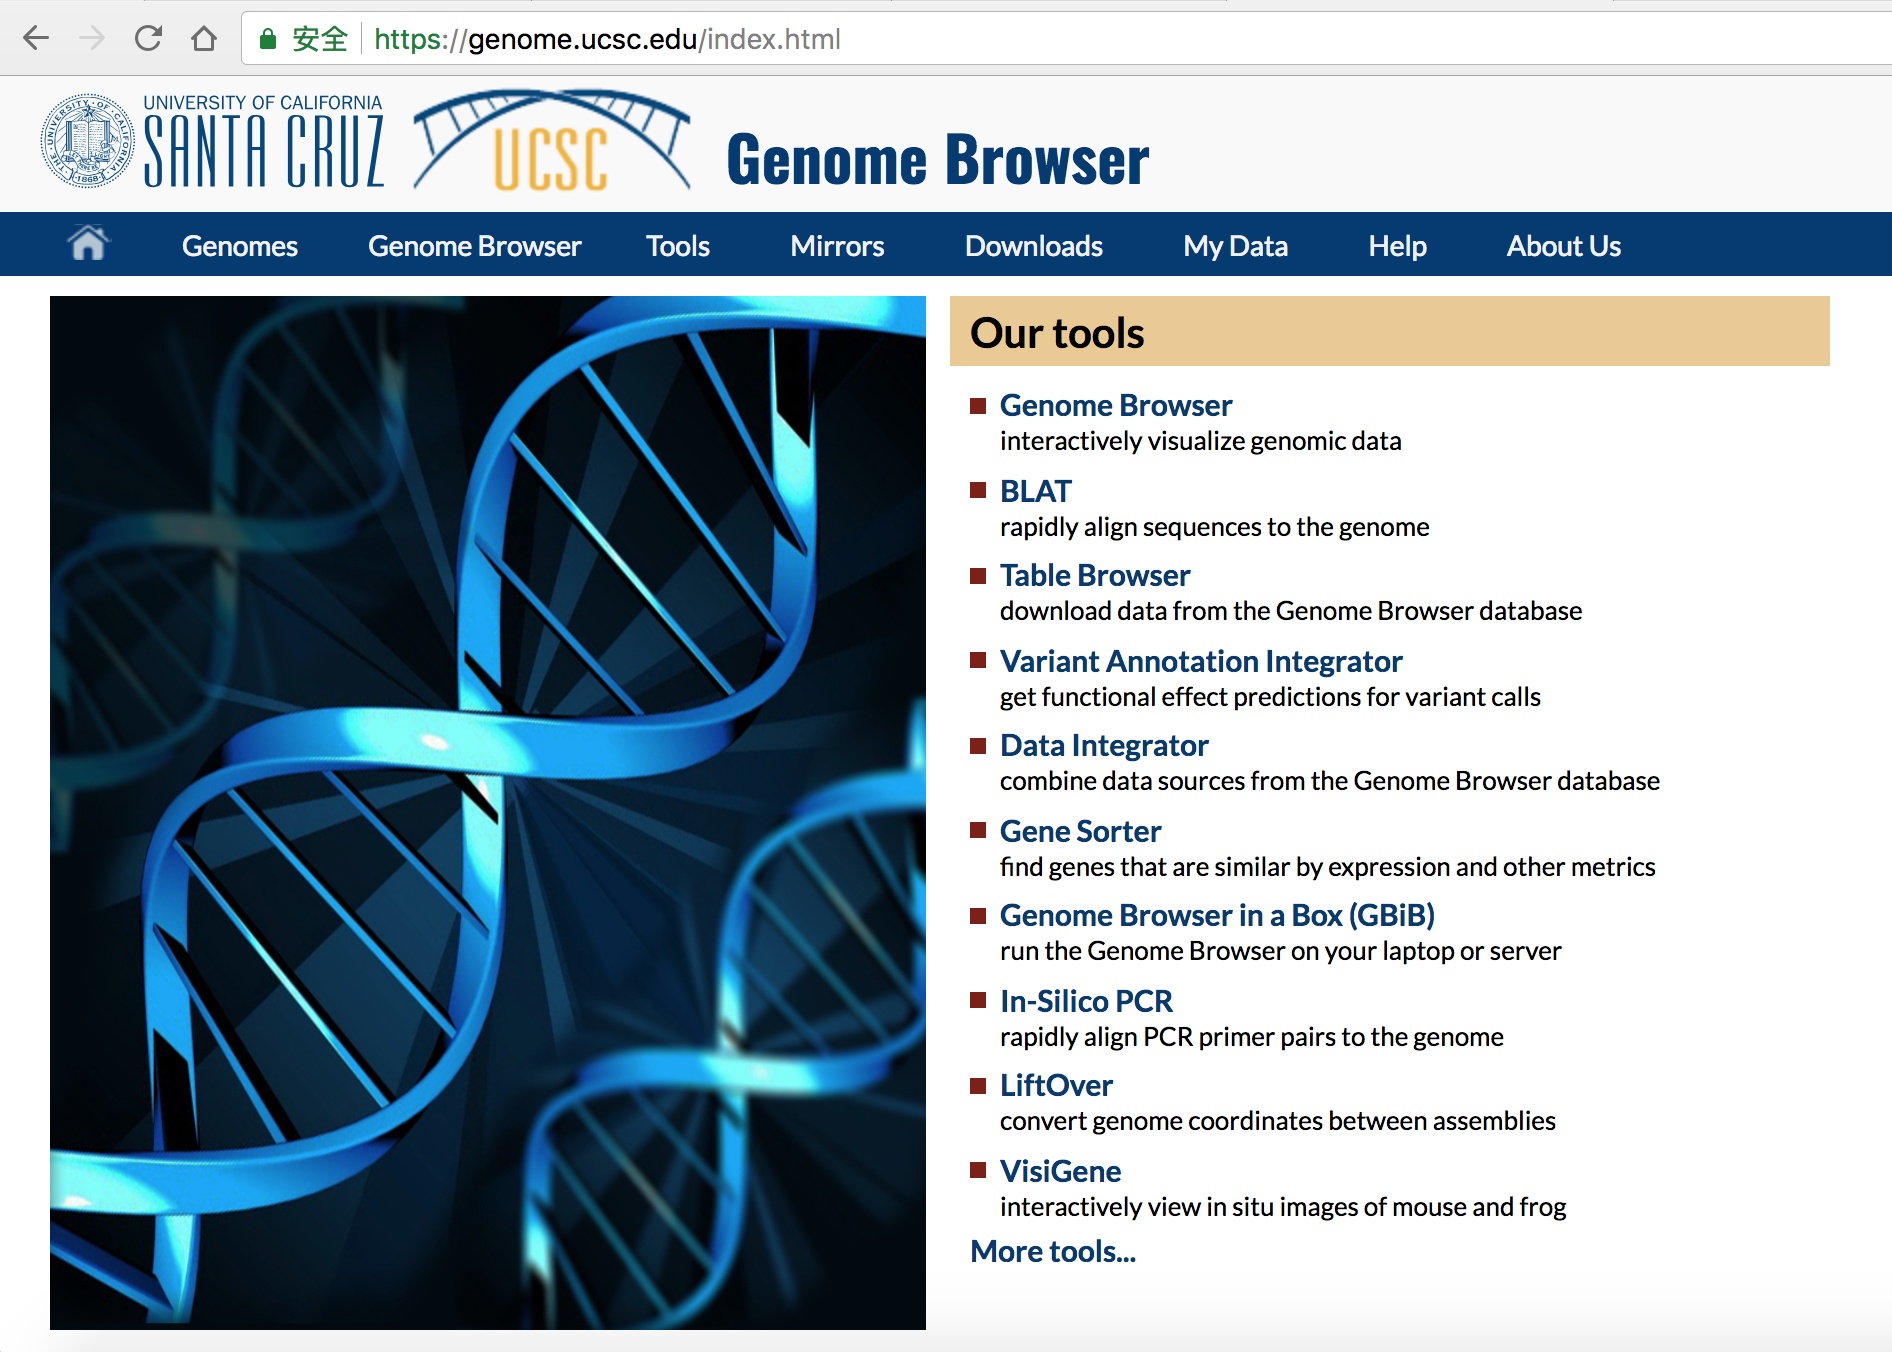
- 打开 UCSC Genome Browser 网站( 图 4.5 )。
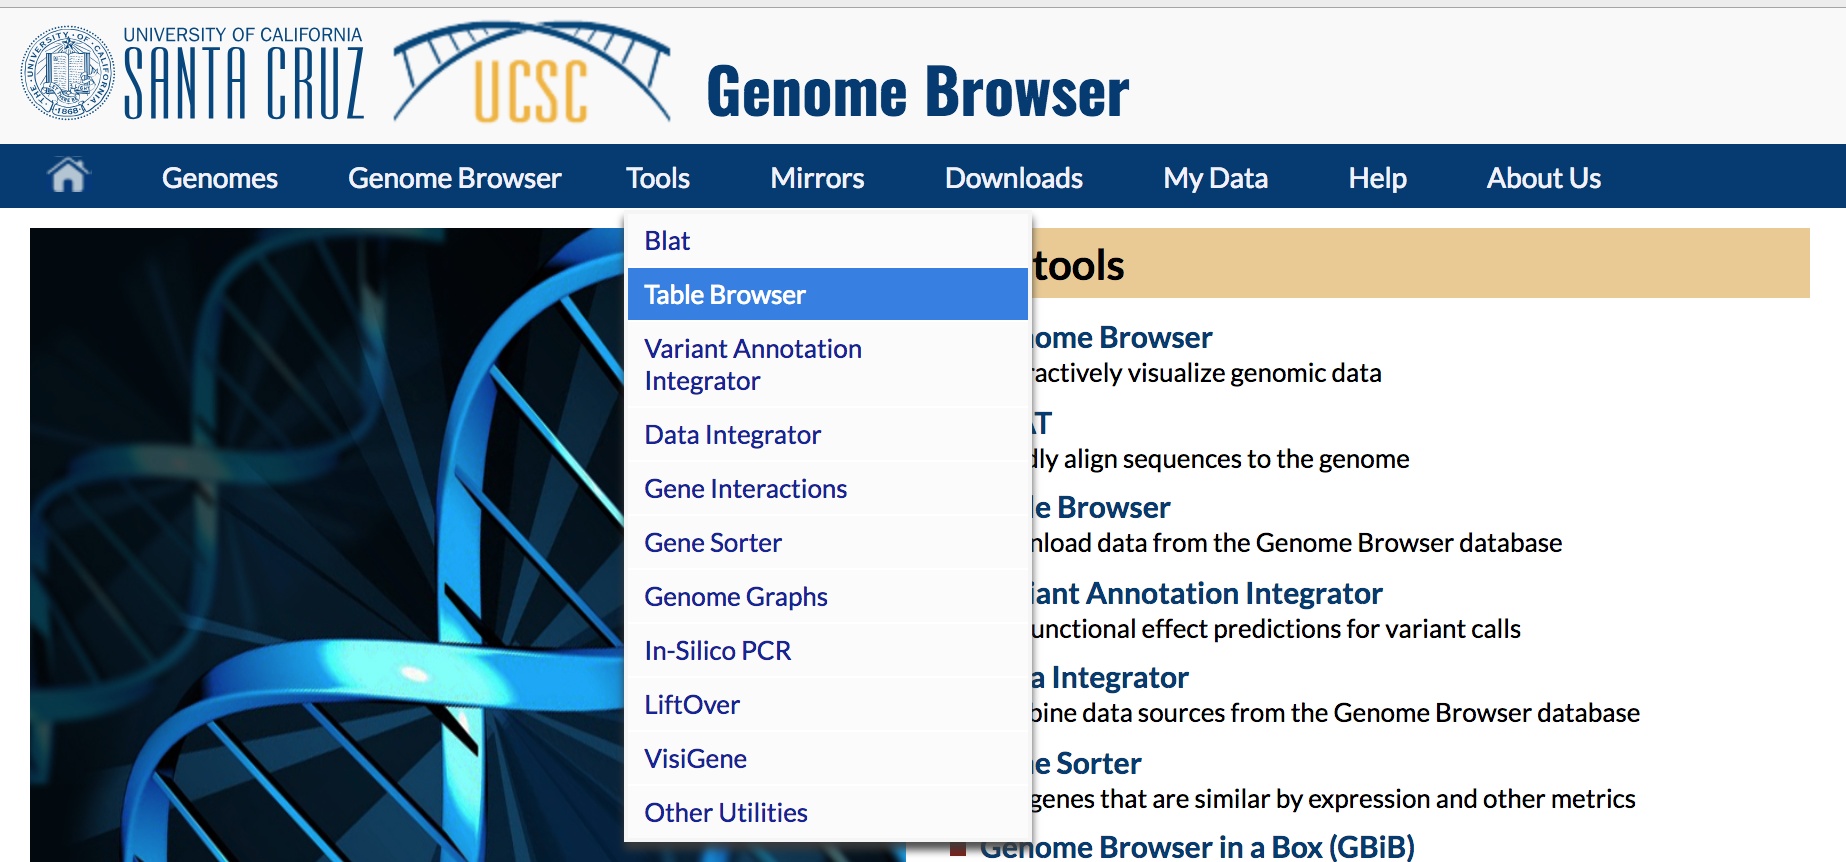
- 在 Tools 里选择 Table Browser( 图 4.6 )。
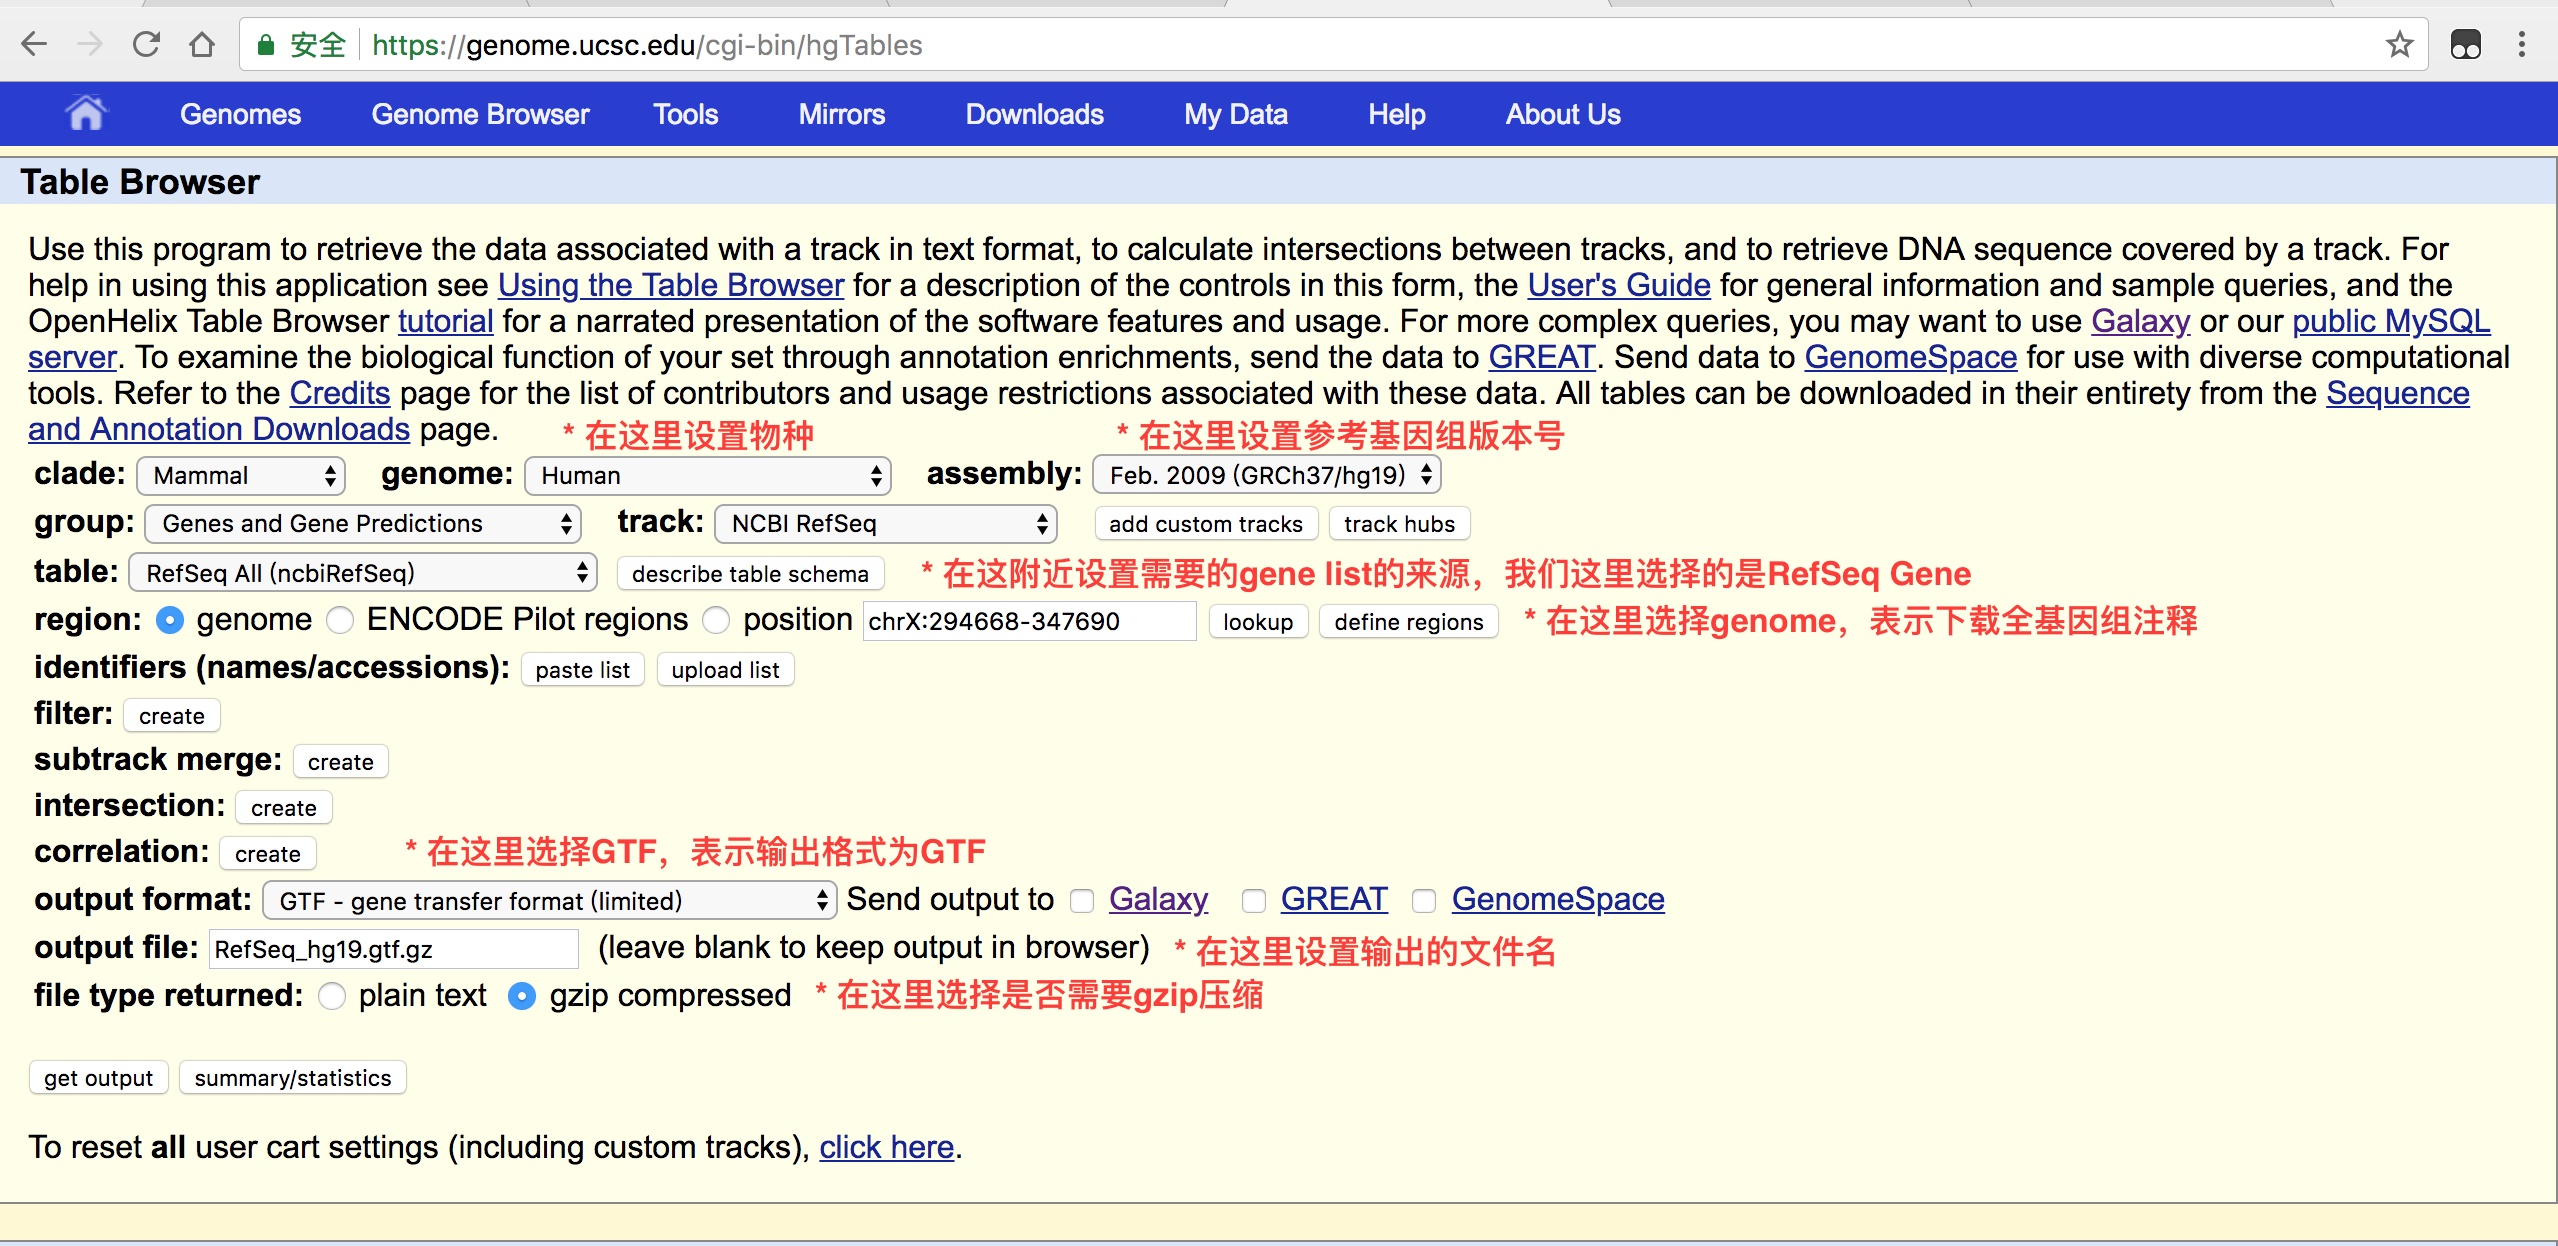
- 打开 Table Browser 以后,设置需要的内容( 图 4.7 ):clade 选 Mammal,genome 选 Human,assembly 选 hg19,track 选 RefSeq Genes。hg19 = human genome 19,是常用的 human 参考基因组版本号;RefSeq Genes 是 NCBI RefSeq 维护、经过一定程度人工审核的基因注释。
- 点击 get output 即可下载。
从 Ensembl 下载 human 的 GTF
- 动物相关的信息访问 Ensembl 主站:https://www.ensembl.org
- 植物相关的信息访问 Ensembl 植物站:https://plants.ensembl.org
以下载 human hg19 版本的 GTF 为例:
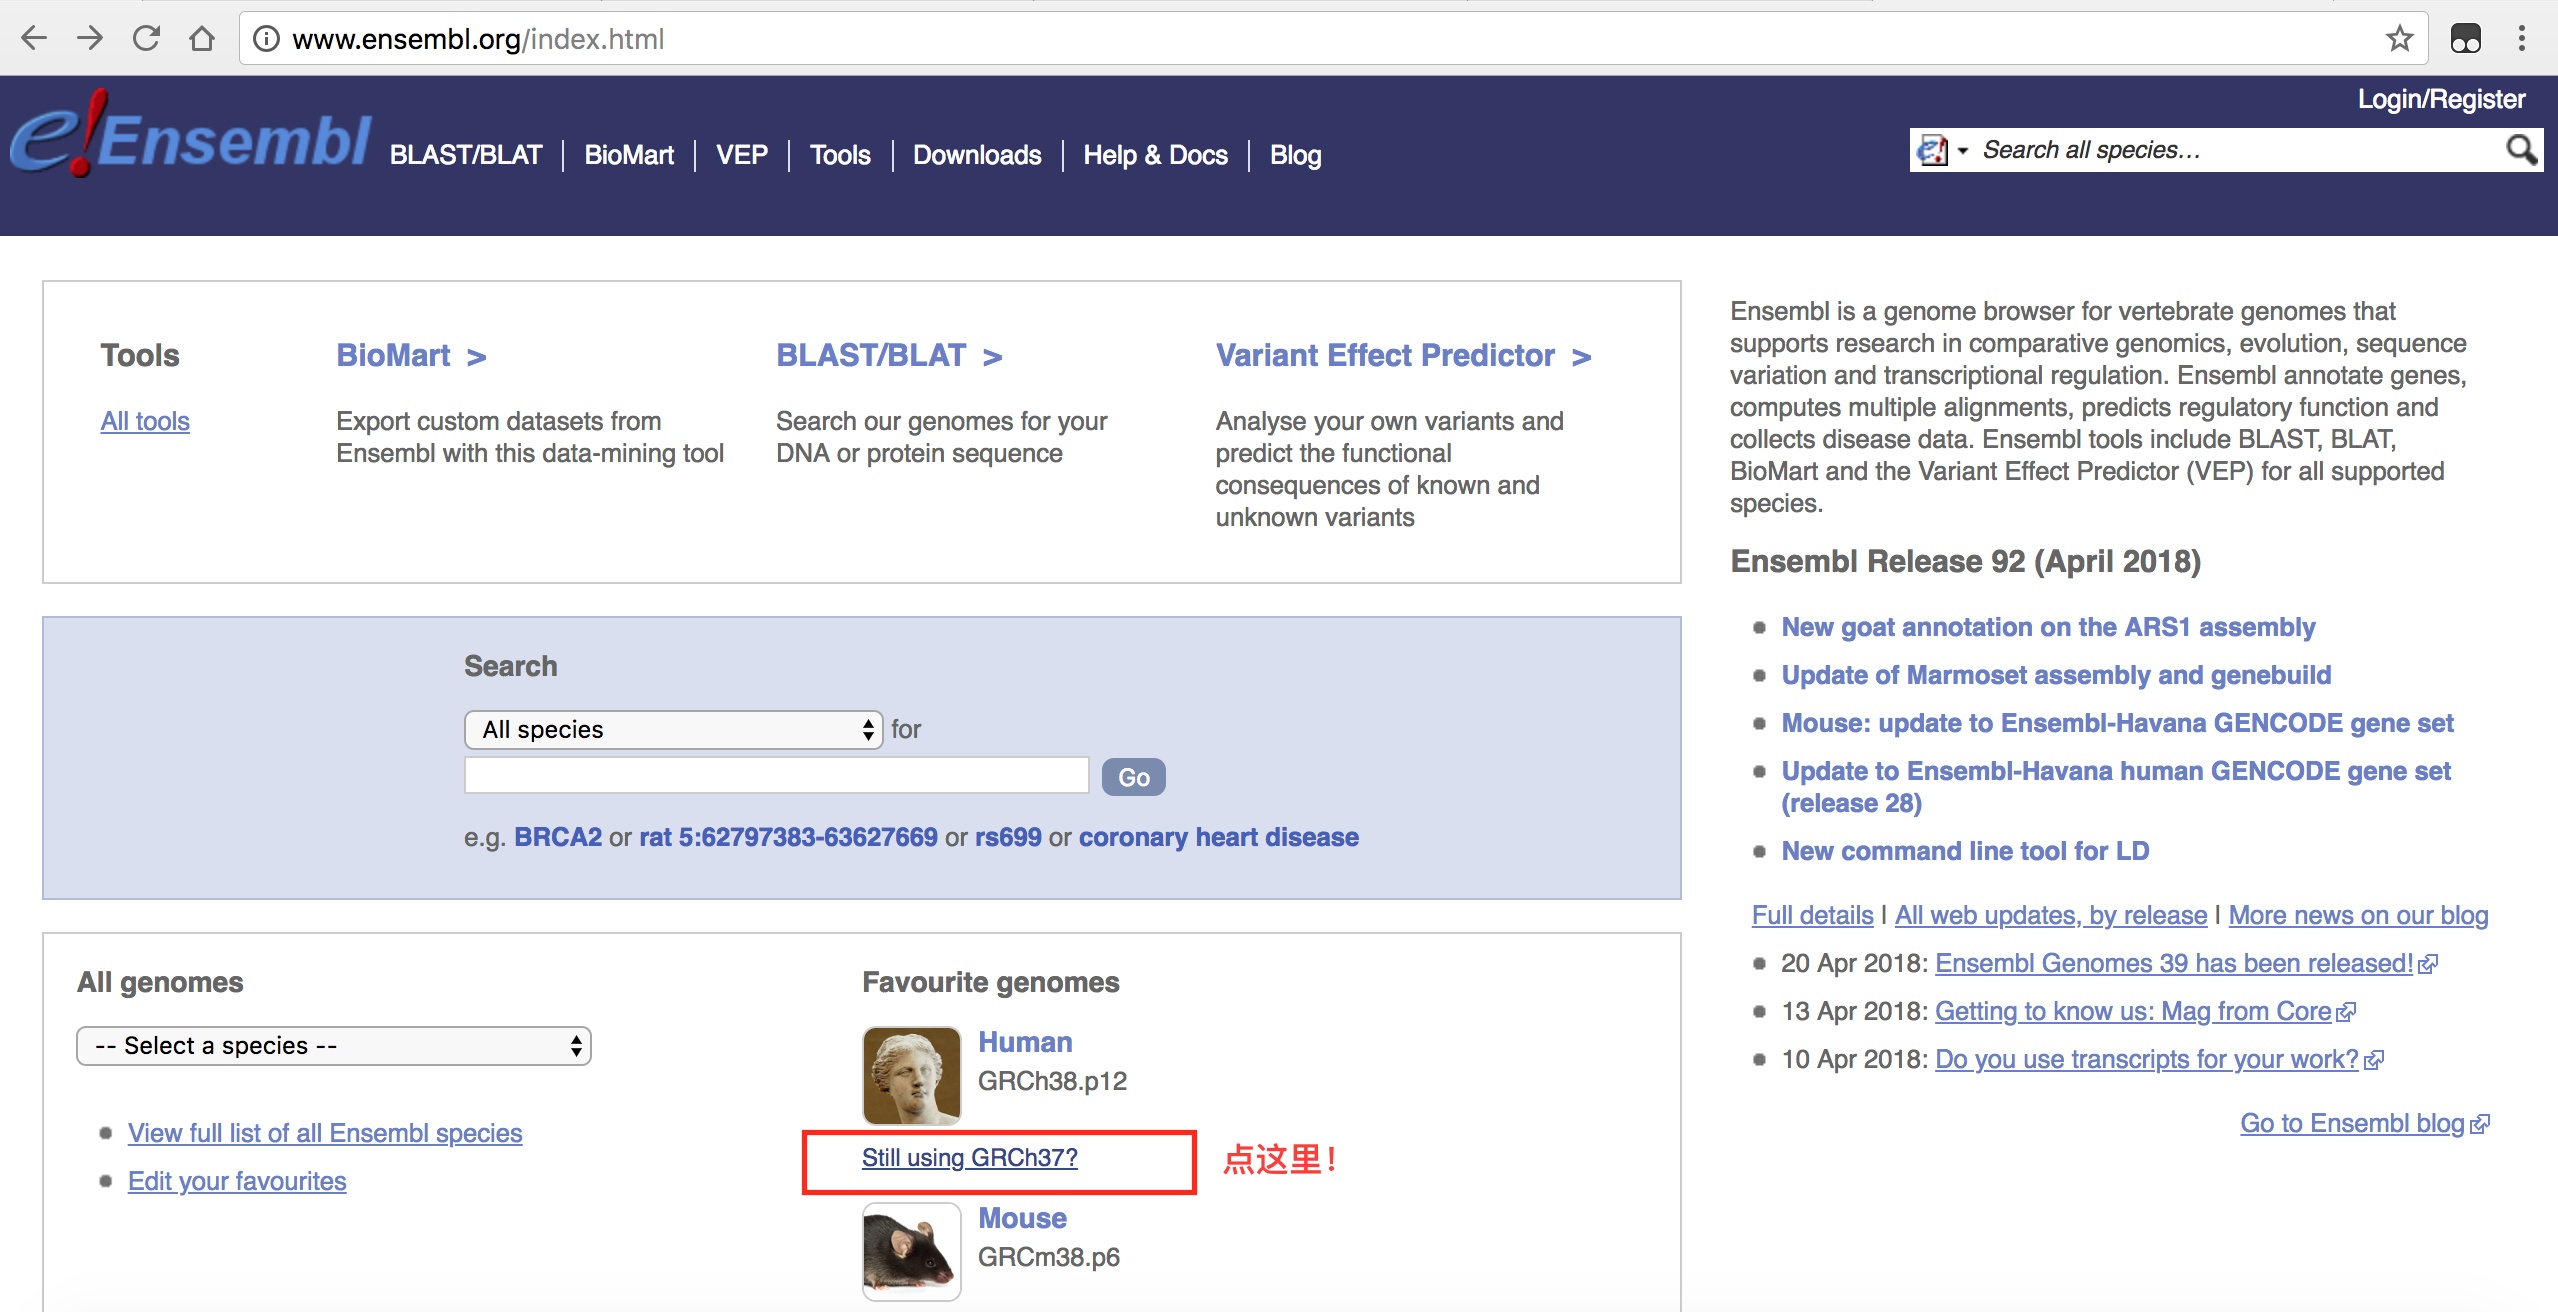
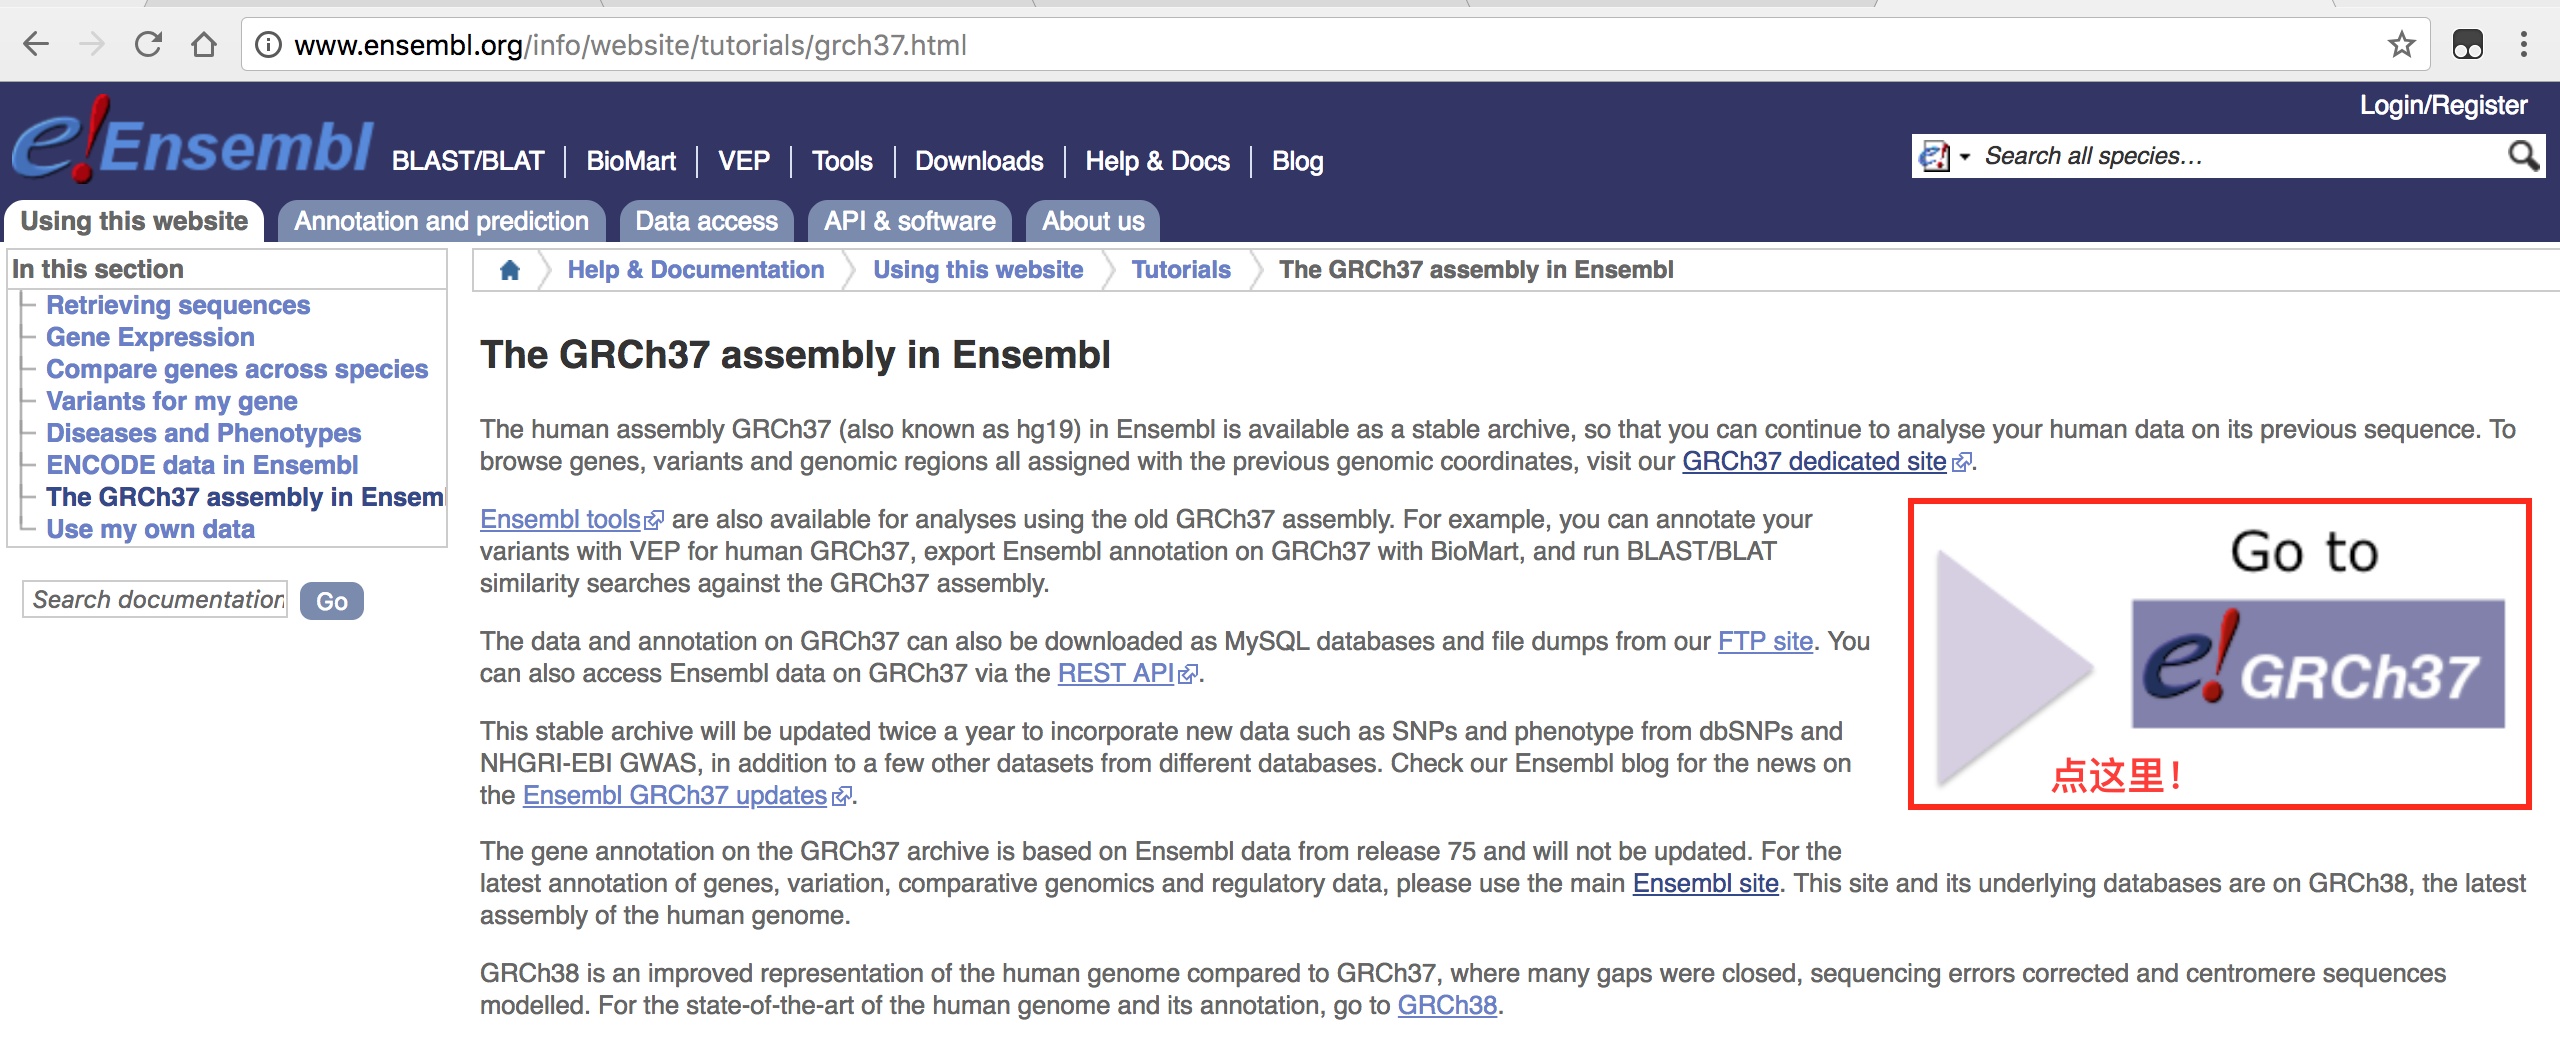
- 登录 Ensembl 网站,并跳转到 hg19 版本界面( 图 4.8 )。
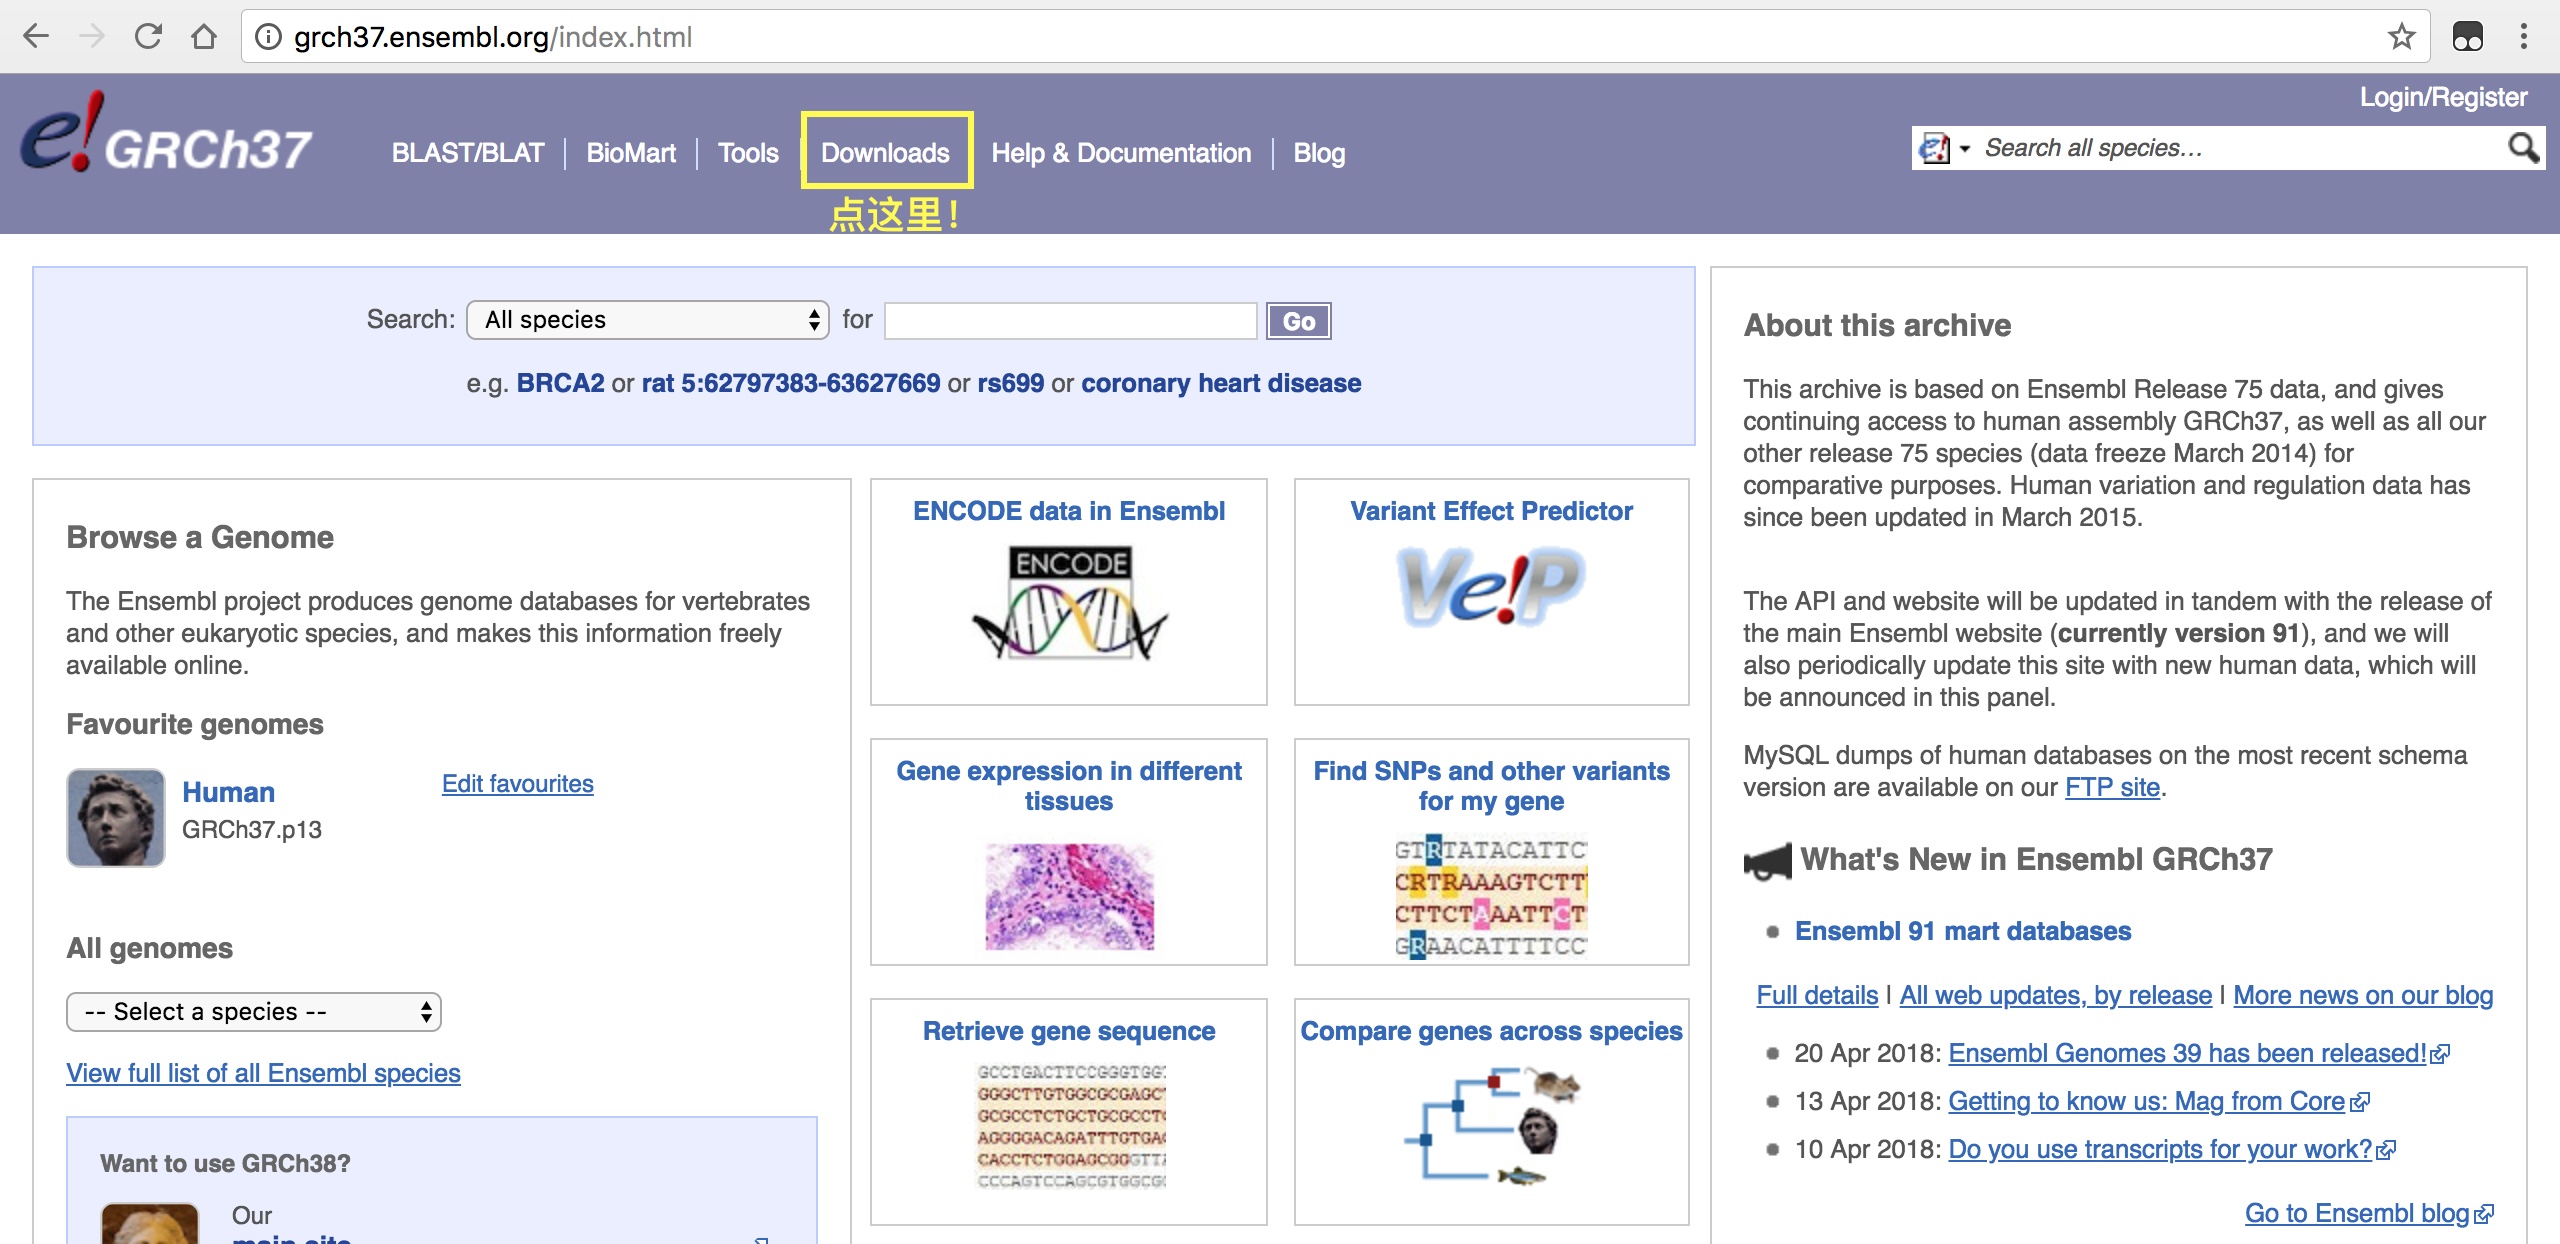
- 继续选择跳转到 hg19 版本界面( 图 4.9 )。
- 在 hg19 版本的 Ensembl 界面中选择 download( 图 4.10 )。
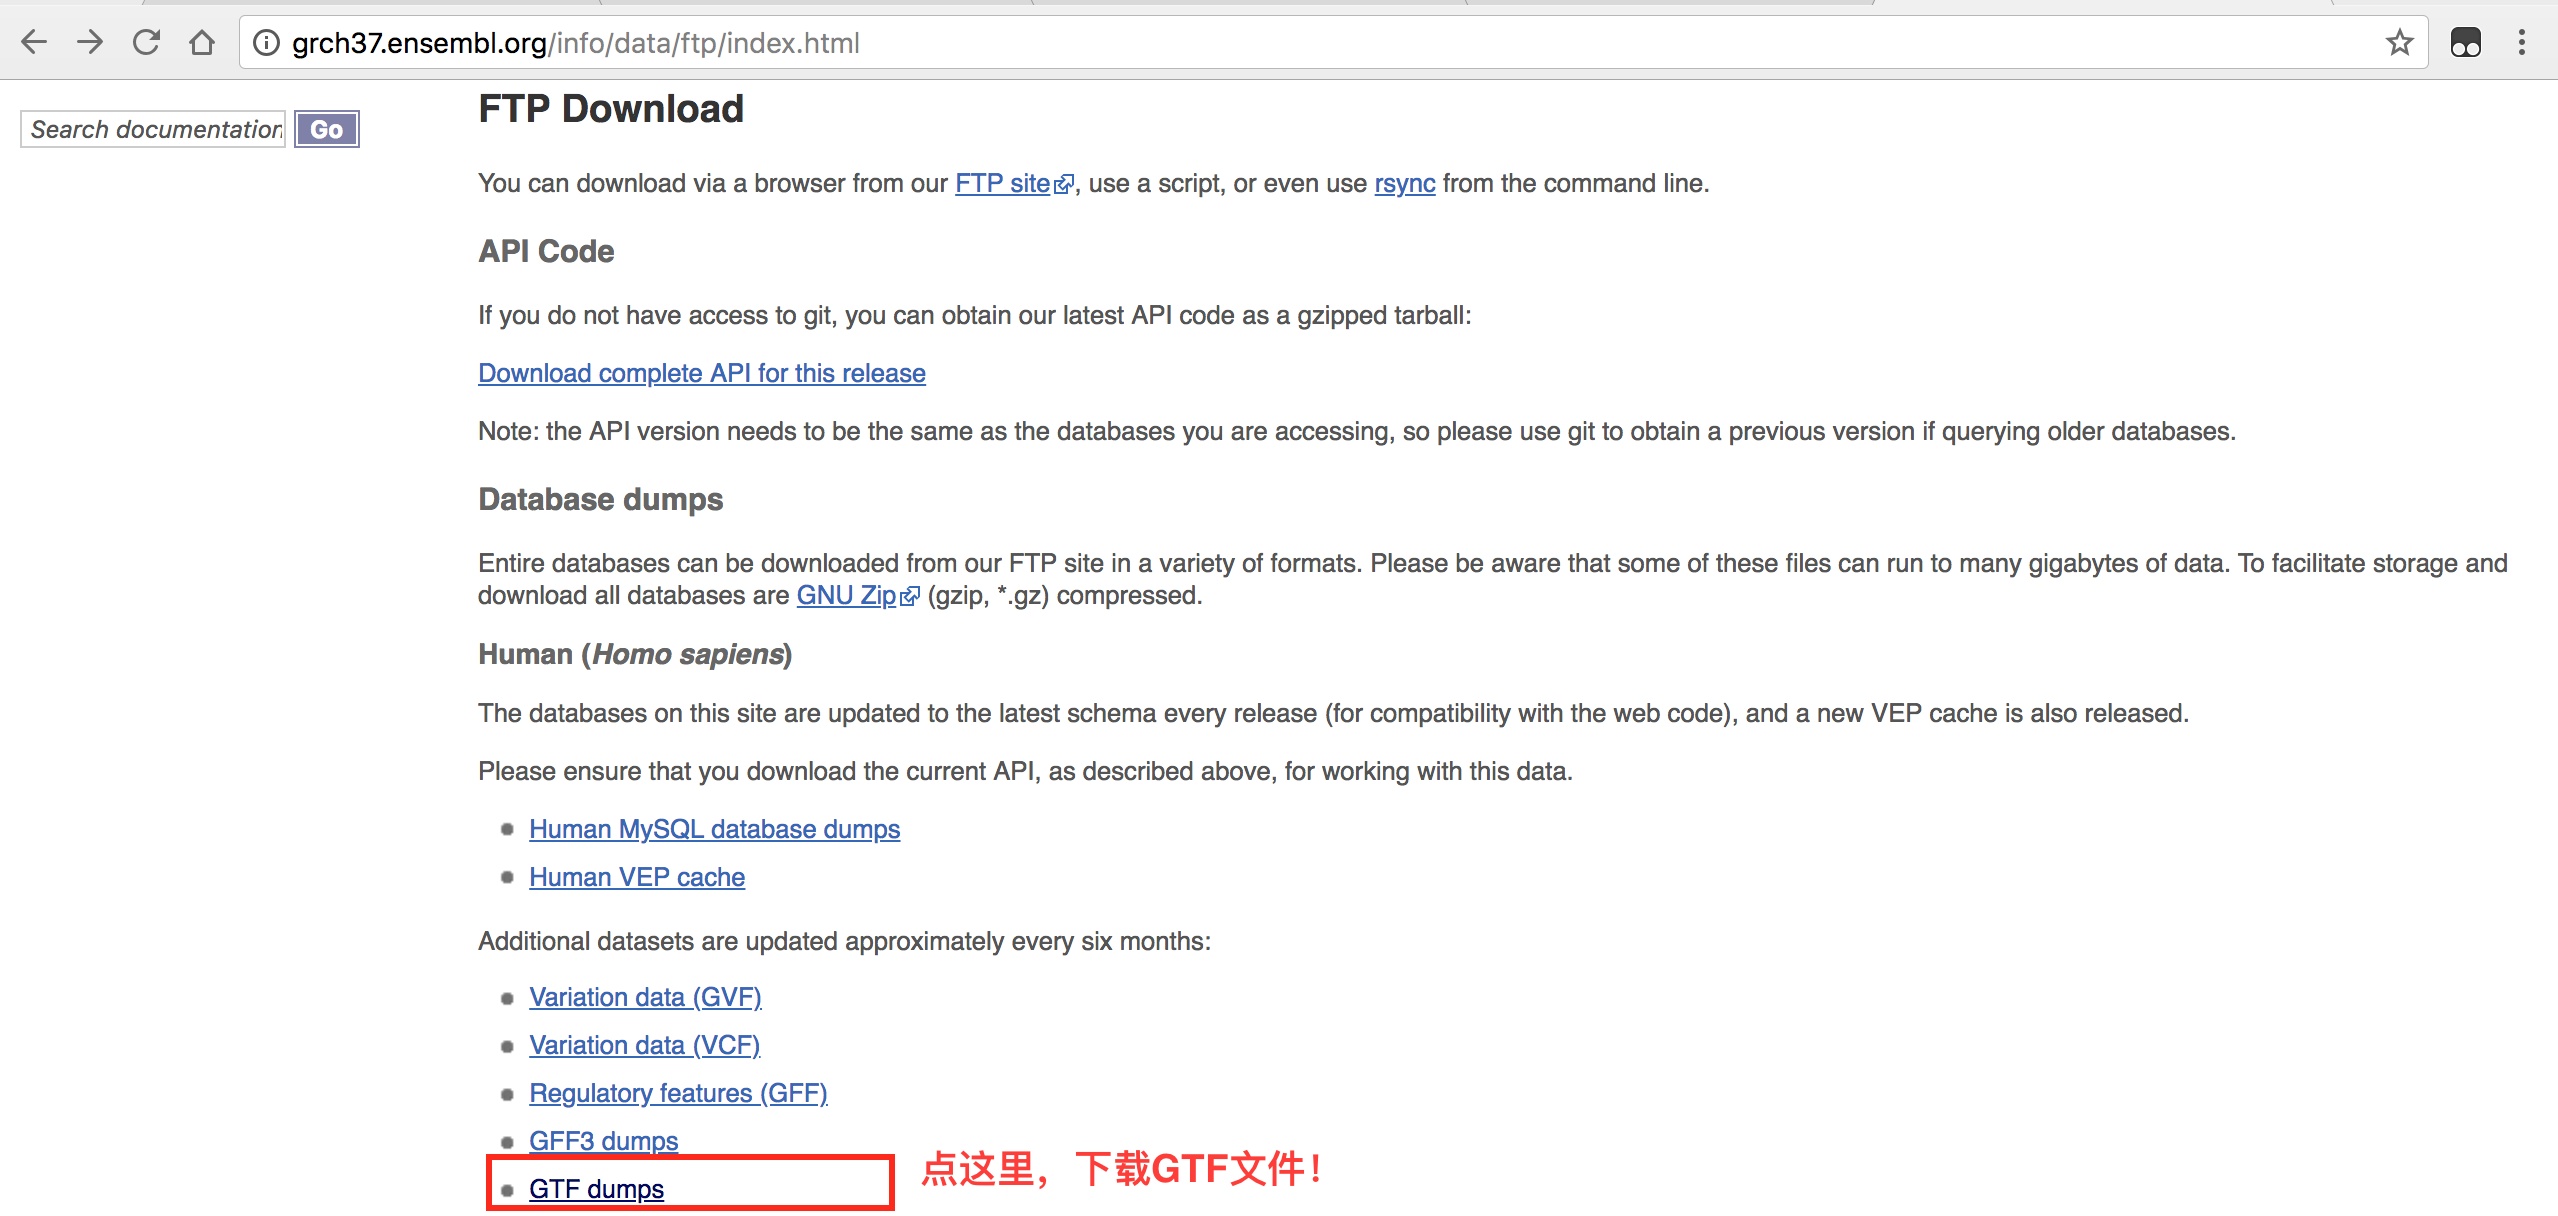
- 在 download 页面中选择 Download a sequence or region( 图 4.11 )。
- 在左边栏选择 FTP download,然后选择下载 GTF 文件( 图 4.11 )。
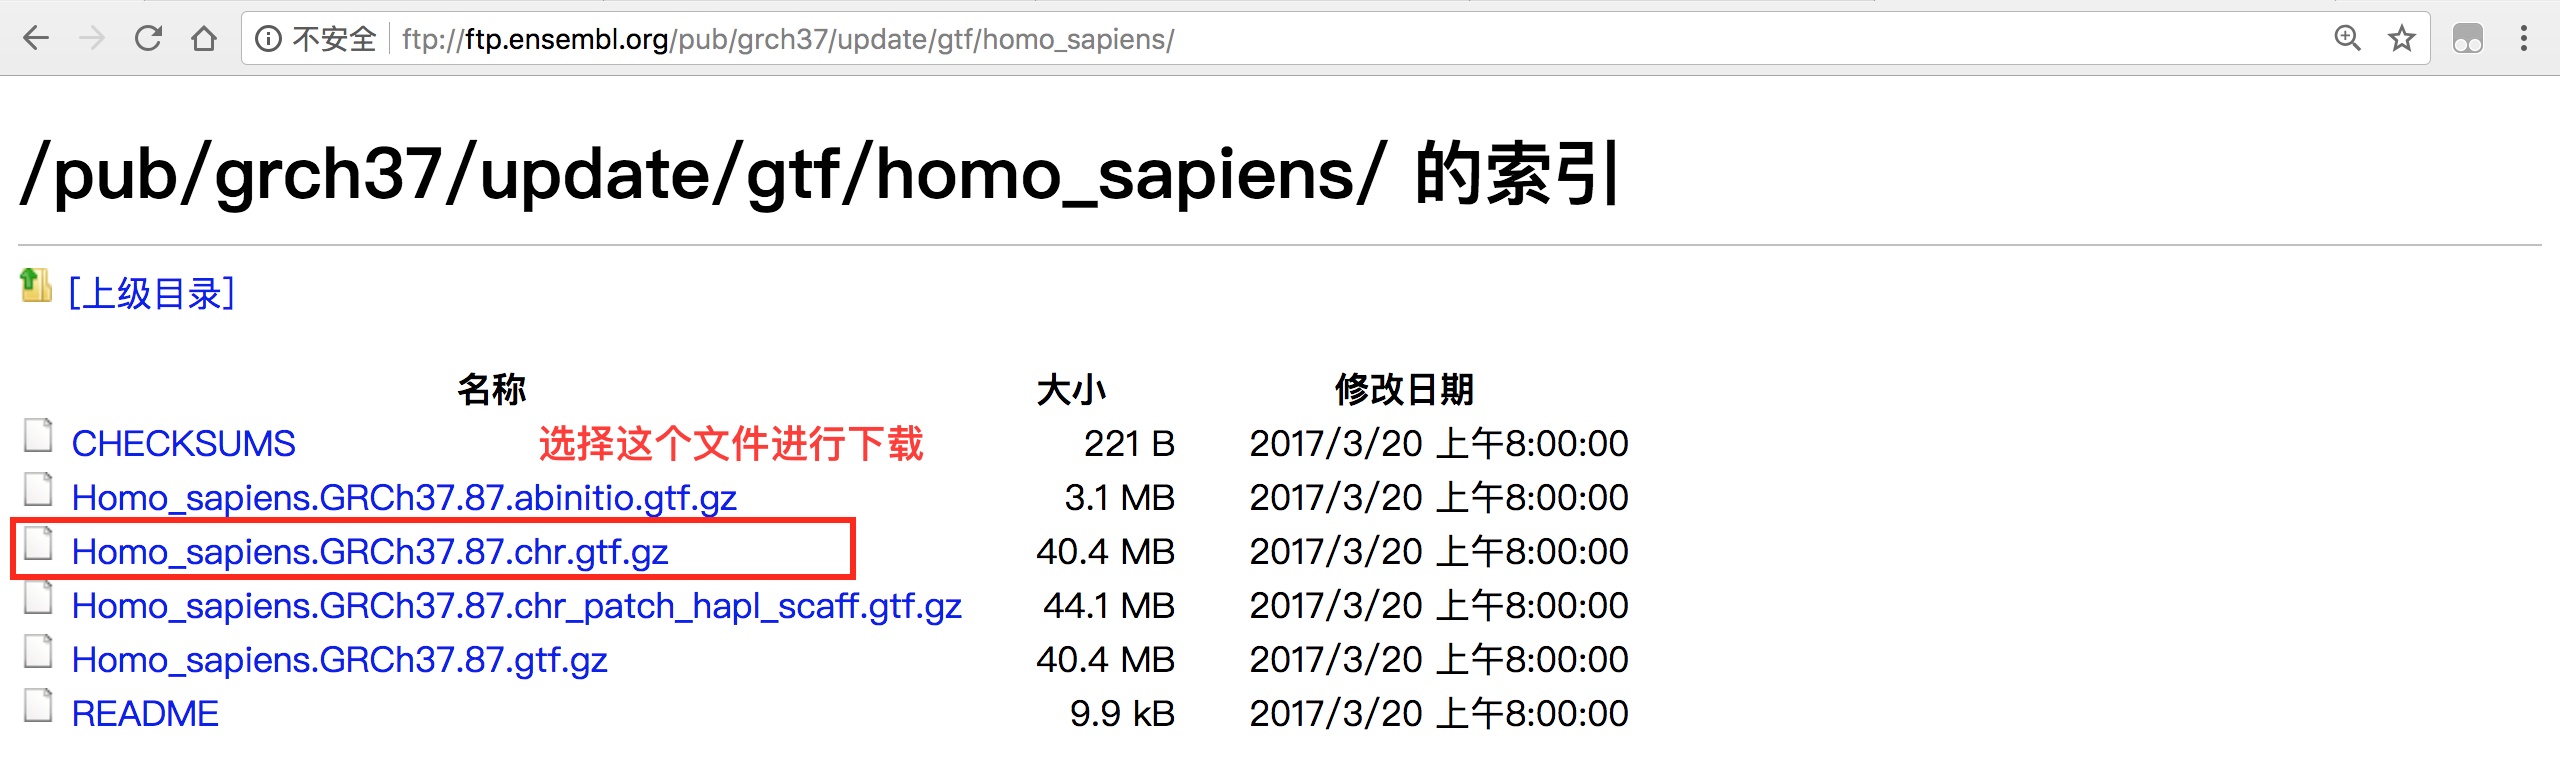
- 选择注释好的 GTF 进行下载( 图 4.12 )。
请分别从 UCSC Genome Browser 和 Ensembl 下载 hg19 的转录组注释 GTF 文件,然后回答下面的问题。
问题 1:下载的两个文件解压后的大小差异大吗?
参考解答:差异较大。解压之后 UCSC 的 hg19_RefSeq_GTF 约 126M,Ensembl 的 Homo_sapiens.GRCh37.87.chr.gtf 约 1.2G( 图 4.13 )。
问题 2:用 less 打开两个文件,比较 transcript_id 与 gene_id 是否相同,还有哪些不同?
参考解答:两者的编号体系完全不同。Ensembl 的 transcript_id 以 ENST 开头、gene_id 以 ENSG 开头(全称分别是 Ensembl Transcript ID 和 Ensembl Gene ID);UCSC(RefSeq)的两者均以 NM 开头。此外 UCSC 的注释非常简练,Ensembl 的注释信息更全面但也更冗余;RefSeq 经过人工审核的比例更大。使用策略上可以先用 UCSC 的 GTF 筛选目标基因,再用 Ensembl 的 GTF 查详细注释。
Ensembl GTF 文件示例:
1 havana exon 12613 12721 . + . gene_id "ENSG00000223972"; gene_version "4"; transcript_id "ENST00000456328"; transcript_version "2"; exon_number "2"; gene_name "DDX11L1"; gene_source "ensembl_havana"; gene_biotype "pseudogene"; transcript_name "DDX11L1-002"; transcript_source "havana"; transcript_biotype "processed_transcript"; havana_transcript "OTTHUMT00000362751"; havana_transcript_version "1"; exon_id "ENSE00003582793"; exon_version "1"; tag "basic";UCSC GTF 文件示例:
chr1 hg19_ncbiRefSeq exon 66999929 67000051 0.000000 + . gene_id "NM_001308203.1"; transcript_id "NM_001308203.1";
转录组分析中常说的“用 XX 软件拼装转录本”,通常涉及下面两种场景,并不意味着有了参考转录组还要重新拼装:
- 无参考基因组的物种:需要先用 RNA-Seq 数据自己拼出参考转录组(包括注释信息),再做下游分析;
- 注释非常好的物种(如 human):不同细胞系的转录组存在结构变异和转录本差异(比如同一个基因在参考注释中从 chr1:1000~15000 转录,在某个细胞系中实际是 chr1:980~15050),有时需要根据已知注释和测序数据做修正,常用软件有 StringTie 等(Cufflinks 是更早期的工具,现在已较少使用)。
不过对于有参考转录组的物种,一般建议不要自己拼转录本、也不要做修正,意义不大——除非研究的体系非常特殊。
这是一个偏理论的讨论题:你认为 GTF/GFF 的文件格式设计合理吗?为什么?
参考解答:并不是非常合理。这种格式虽然包括了注释需要的全部信息,但同一个基因的不同 elements 分散在不同行,程序统计一个基因包含哪些元件时,需要逐行循环判断该行是否属于同一个基因,比较耗费 CPU 和内存。如果不选 GTF,而是用 UCSC Table Browser 的“all fields from selected table”文件( 图 4.14 ),它以一个基因为一行,把各个元件集中在同一行里,处理起来更便捷——当然代价是丢失了逐行注释的通用性,这也是 GTF 至今仍是标准的原因。
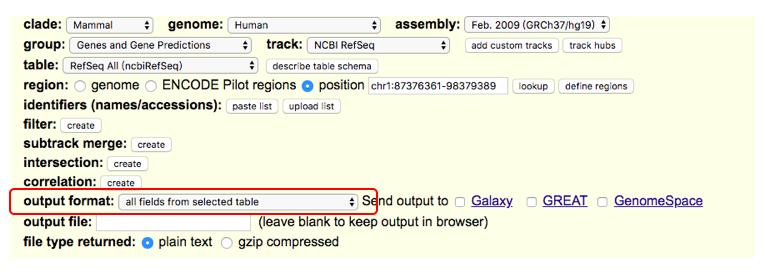
all fields from selected table 文件内容示例:
#bin    name    chrom   strand  txStart txEnd   cdsStart    cdsEnd  exonCount   exonStarts  exonEnds    score   name2   cdsStartStat    cdsEndStat  exonFrames
1251 NM_004261.4 chr1 - 87328127 87380048 87329156 87379794 5 87328127,87333735,87346344,87368963,87379710, 87329288,87333785,87346408,87369131,87380048, 0 SELENOF cmpl cmpl 0,1,0,0,0,已知 transcript_id 为 NM_001308203.1、gene_id 为 SGIP1,某片段在转录本上的坐标是 101,它对应的基因组坐标是多少?注释信息如下(节选):
chr1    hg19_ncbiRefSeq exon    66999252    66999355    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq start_codon 67000042    67000044    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq CDS 67000042    67000051    0.000000    +   0   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq exon    66999929    67000051    0.000000    +   .   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1    hg19_ncbiRefSeq CDS 67091530    67091593    0.000000    +   2   gene_id "SGIP1"; transcript_id "NM_001308203.1";
chr1 hg19_ncbiRefSeq exon 67091530 67091593 0.000000 + . gene_id "SGIP1"; transcript_id "NM_001308203.1";参考解答:思路是按注释算出各 exon 的分布与长度,转录本坐标代表该位置之前各 exon 的累计长度。chr1 上该基因第一个 exon 是 66999252 到 66999355,长度 66999355-66999252+1=104;转录本坐标 101 不超过 104,说明该片段就落在第一个 exon 上,对应基因组坐标 66999252+101-1=66999352。
4.4 序列比对算法
理解速度、灵敏度与唯一定位之间的权衡。
alignment 与 mapping
先统一两个贯穿本章的术语。
比对(alignment) 通常特指低通量的序列之间的比较:比如 10 条序列做多序列比对(multiple alignment),或者 2 条序列做双序列比对(pairwise alignment)。
回贴(mapping) 一般指高通量数据寻找基因组位置:比如测序得到 10M 对 read pair,要确定它们在基因组上的位置,这就是典型的 mapping 问题。
两者密切相关:mapping 软件的核心思想都是从低通量的精确比对逐步改进而来的。下面按“精确比对(双序列比对)→ 启发式检索(BLAST/BLAT)→ 高通量算法(哈希表/BWT)”的顺序,介绍这些算法之间的联系。
双序列比对:Needleman-Wunsch 与 Smith-Waterman
双序列比对是一切比对问题的基础:找到两条序列最佳的匹配方式。经典算法有两种:Needleman-Wunsch 算法(全局比对)和 Smith-Waterman 算法(局部比对),它们都用动态规划(dynamic programming)填一张打分表格:每个格子的值由左、上、左上三个邻居决定,填完整个表格后回溯,就得到最优比对。
BLAST:启发式检索
鉴定未知物种时,常规的分子生物学操作是提取 DNA,用通用引物进行 PCR 扩增,送公司做 Sanger 测序,再把序列提交到 NCBI 检索,从分子层面完成物种鉴定。数据库中有上亿条序列,逐一做精确比对并不现实,因此 NCBI 采用了启发式检索工具 BLAST(Basic Local Alignment Search Tool)。
学习这部分内容推荐结合北京大学高歌老师《生物信息学:导论与方法》的课程视频(以下链接 2026 年 10 月核对可访问):
我们用一个贯穿的小例子把两种算法都算一遍。假设打分规则如 图 4.15 所示:match 得 5 分,mismatch 扣 4 分,空位罚分 \(d=-5\)(每个空位扣 5 分);要比对的序列是 seq1 = AAGT 和 seq2 = AGCT,需要填写 图 4.16 的动态规划表格(以全局比对为例,第 0 行/第 0 列先填入空位累计罚分 0、-5、-10……;局部比对的初始化全为 0)。
图注:相同碱基得 5 分,不同碱基扣 4 分,每个空位扣 5 分。
图注:列为 seq2(AGCT),行为 seq1(AAGT)。灰格按全局比对初始化;练习局部比对时,先将灰格改为 0。
Needleman-Wunsch(全局比对):从左上角出发,第 0 行第 0 列按空位数初始化(0、-5、-10……),其余每格取“对角线+匹配得分、上方−5、左方−5”三者最大值,右下角的值就是全局最优得分。填表结果见 图 4.17 :最优得分 5,回溯路径(图中箭头)给出最优比对。本例并列两个最优结果(得分都是 5):
A A G - T        A A G - T
- A G C T        A - G C T
图注:灰色小箭头为取值来源,绿色连线为回溯。A、B 两种最优比对均为 5 分;B 独有的回溯段用虚线表示。
Smith-Waterman(局部比对):与全局比对的差别有两点——第 0 行第 0 列全为 0;每个格子算完后如果为负就记 0。填表结果见 图 4.18 :矩阵最高分是 10,回溯从得分最高的单元格开始、遇到 0 停止(注意不是“从第一个非零的格子开始”,那是初学时常见的错误)。本例最高分 10 对应两个并列的最优局部比对:
A G              A G - T
A G              A G C T
图注:从两个加框的 10 分格分别回溯,遇到 0 停止。A、B 共用段为实线,B 独有段为虚线;零分格没有来源箭头。
全局比对从头到尾比较两条序列的每一个碱基,寻找整体最优解;局部比对寻找最相似的部分,最优结果可以有多个。为什么需要局部比对?随着序列信息积累,人们发现:
- 某些蛋白序列虽然整体相差很大,但对某些特殊的功能域却有着极高的相似性;
- 这些功能域在不同物种中序列和功能都相当保守,这在全局比对中很难发现;
- 20 世纪 70 年代内含子被发现后,比对算法还必须能处理由内含子导致的大片段差异。
这也是后面 BLAST 选择“局部比对+启发式”的思想来源。
BLAST 为什么快?我们先算一笔账( 图 4.19 )。假设有 1 条 100bp 的序列 SeqA(不算长),想在核酸库中找相似序列:以 2017 年前后的 NCBI 非冗余核酸库(nt)为参照,当时库里有约 47,193,206 条序列、平均长度按 0.1Mbp 计,用精确的局部比对逐条比较,运算量为
\[ 100\,\mathrm{bp} \times 0.1\,\mathrm{Mbp} \times 47{,}193{,}206 \approx 4.7\times10^{14} \](4.1)
按单核每秒约 \(3\times10^{9}\) 次、20 个核心计算,大约需要 130 分钟(见 公式 4.1 )——序列变成 1000bp 就是 1300 分钟。为找一个相似性花两个小时,显然不划算。
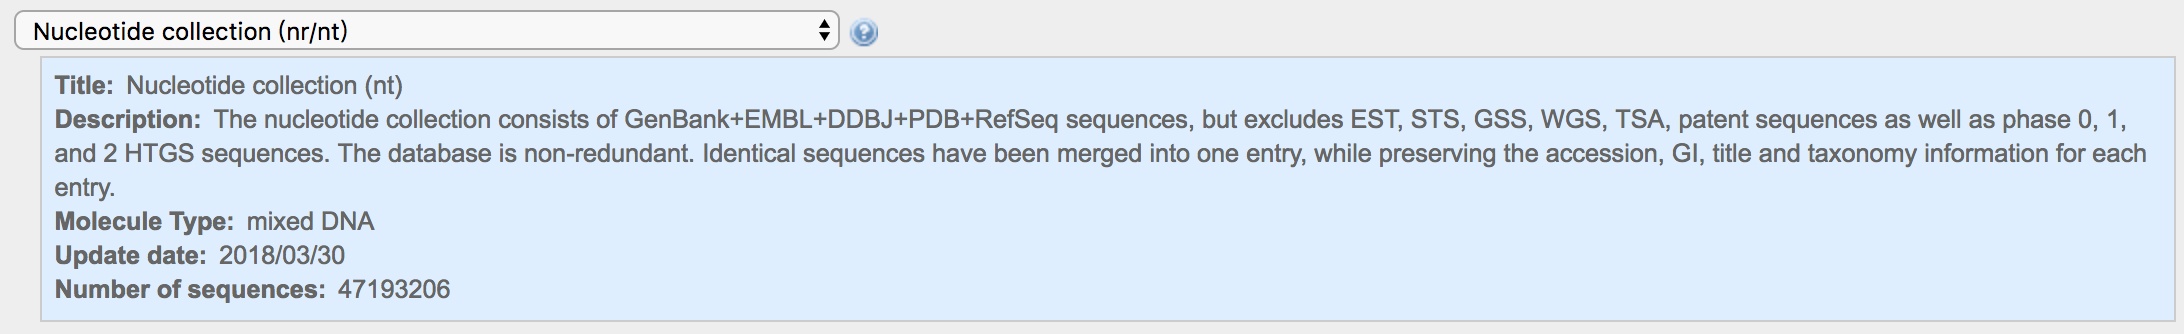
BLAST 的解法是启发式的 seed-and-extend:把查询序列切成短的种子序列(word),用种子在数据库中快速定位候选区域,再只对候选区域做局部比对延伸,从而避免对全库做精确动态规划,把这类任务的运行时间缩短到了 1 分钟以内。
读懂 BLAST 结果需要两个指标:
- S 值(bit score):两条序列比对的相似程度,与打分系统和序列长度有关,分值越高越相似,没有上限;结果中的 Identities 百分比才最高是 100%,两者不要混淆。
- E 值:可靠性的评价,表示随机情况下出现这种相似度的序列条数期望。E 值越小越好,注意 E 值有可能大于 1。
BLAST 提高速度靠启发式,代价是可能混入假阳性。想一想有哪些办法可以降低假阳性?
参考解答:
- Word size 的选择:BLAST 将查询序列分割成一系列固定长度的小序列进行数据库搜索,此值越小得到的搜索结果越多,假阳性也就越多;
- 根据序列长度调整 E 值:检索序列较短时可适当提高 E 值(短序列随机命中更容易得到低 E 值),反之可降低 E 值;
- 空位罚分的选择:严谨的罚分会让相似度高的序列错过,而松弛的罚分会使检索结果过多;
- 序列检索前将低复杂度的序列先去除,尤其是 DNA 序列中的重复片段。
把下面的蛋白序列提交 BLAST,看相似度最高的命中来自哪个物种。
>Protein Sequence
MVRAPCCEKMGLKKGPWTPEEDQILISYIQSNGHG
NWRALPKLAGLLRCGKSCRLRWTNYLRPDIKRGNF
TREEEDSIIQLHEMLGNRWSAIAARLPGRTDNEIK
NVWHTHLKKRLKNYQPPQSSKRHSKNKDSKAPCTS
QIALKSSNNFSNIKEDGPGLGSGPNSPQLSSSEMS
TVTADSLAVTMDISNSNDQIDSSENFIPEIDESFW
TDGLSTSGGGEELQVQFPFHDMKQENVEKDVGAKL
EDDMDFWYSVFIKSGDLLELPEF
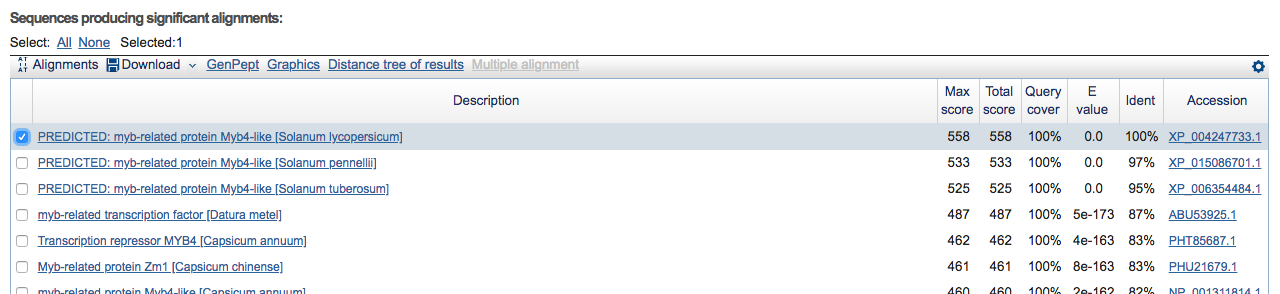
使用网站与参数:BLAST https://blast.ncbi.nlm.nih.gov(2026 年 10 月核对可访问);Database 选 Non-redundant protein sequences (nr);Algorithm 选 blastp;Word size 3;Matrix BLOSUM62;Gap Costs Existence 11 / Extension 1;其他参数默认。
参考解答:如 图 4.20 所示,相似度最高的物种是 Solanum lycopersicum(番茄)。
BLAT:单基因组快速定位
BLAT 的名字与 BLAST 很接近,两者的用途有什么区别?
- BLAST = Basic Local Alignment Search Tool:在所有物种的非冗余数据库里找相似序列,优点是全,缺点是输出冗余;
- BLAT = BLAST-like alignment tool:只在某一个指定基因组上快速定位一条序列,比如“这条 SeqA 在 human genome 的哪里”。
在线 BLAT 工具地址是 https://genome.ucsc.edu/cgi-bin/hgBlat,也可以通过 UCSC Genome Browser 的 Tools 菜单打开(2026 年 10 月核对可访问)。
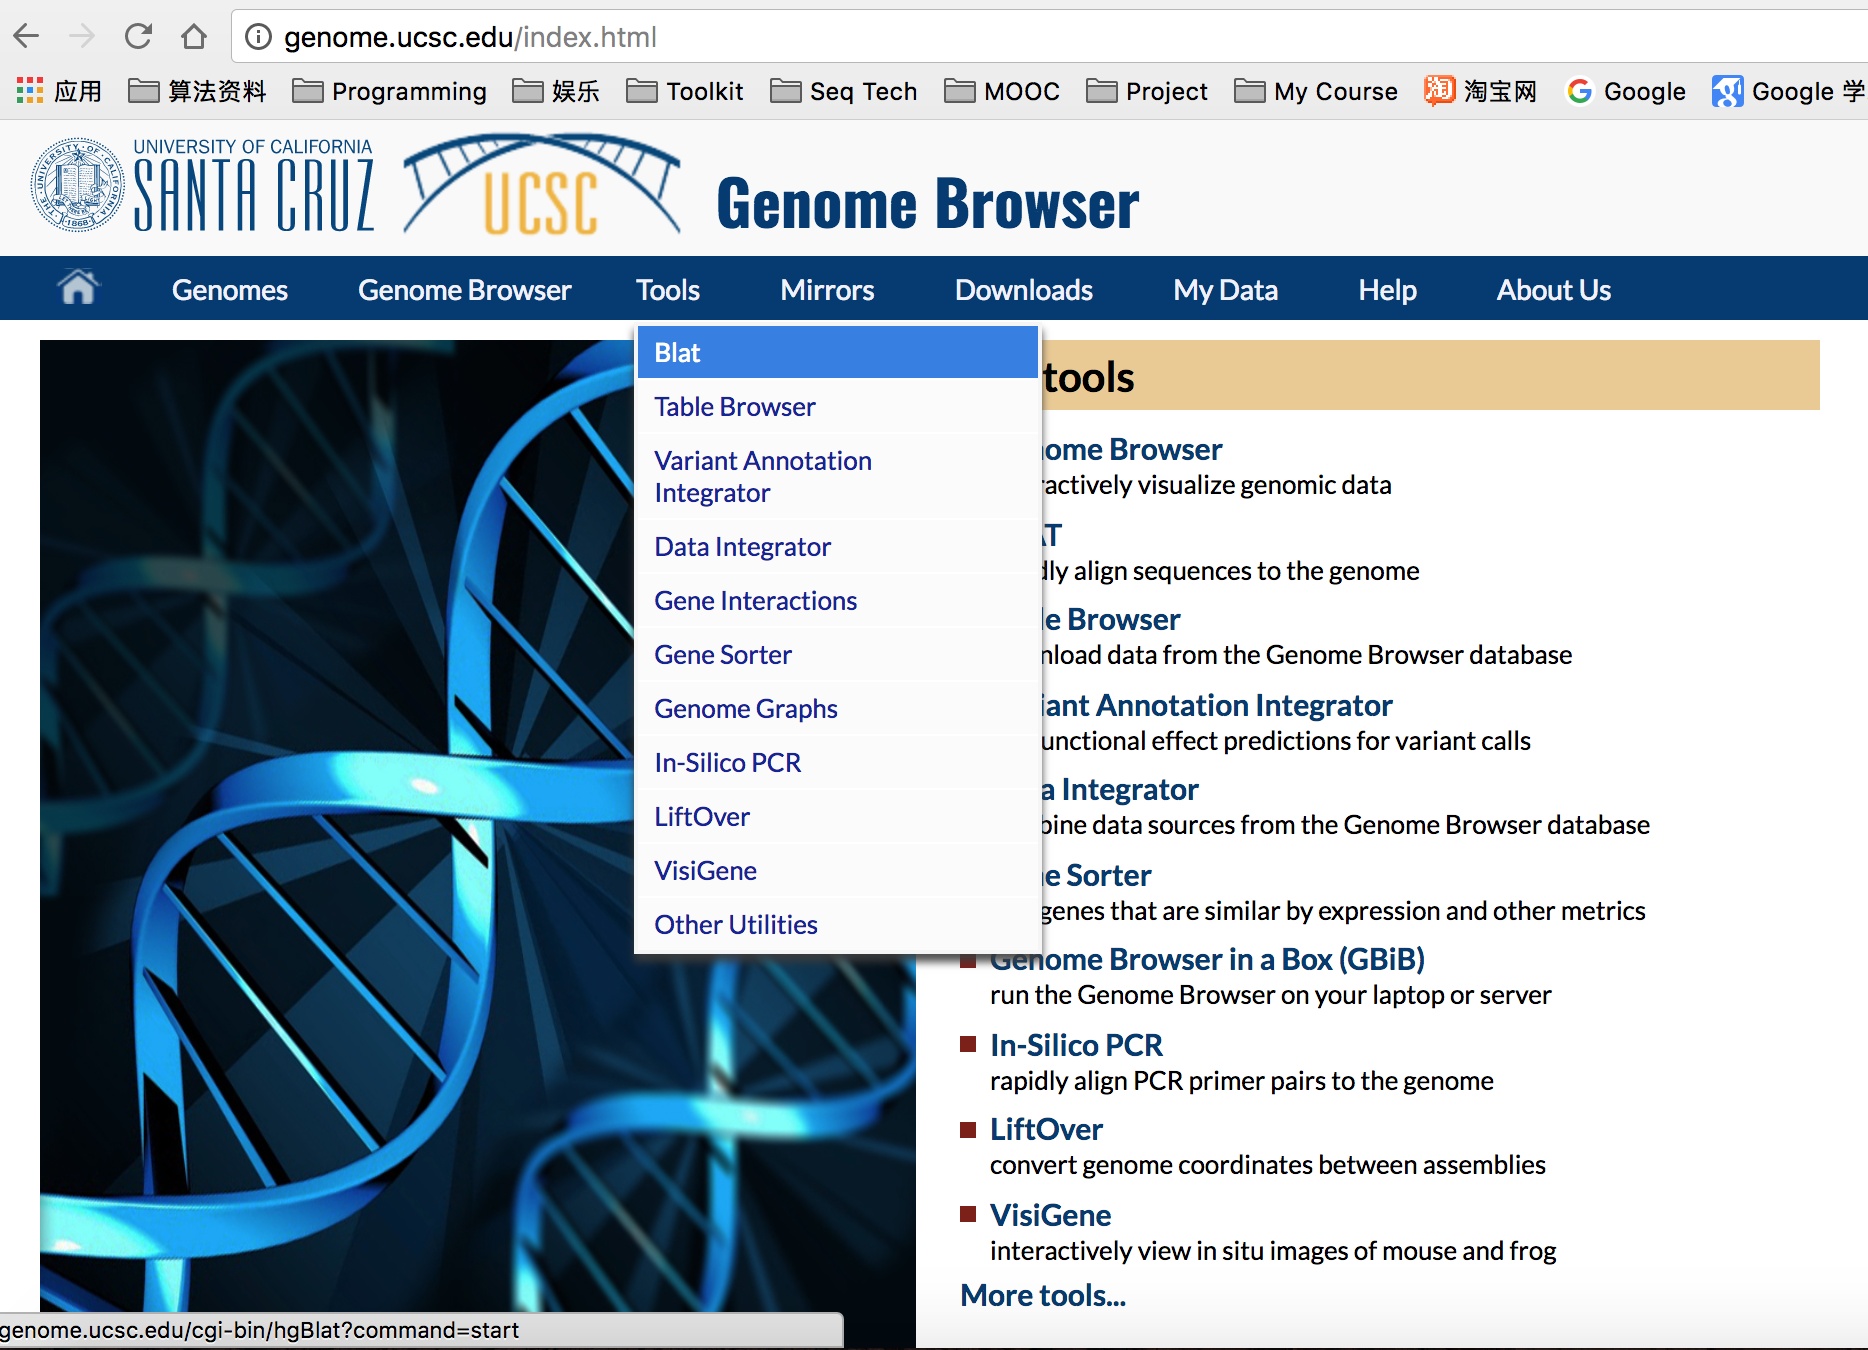
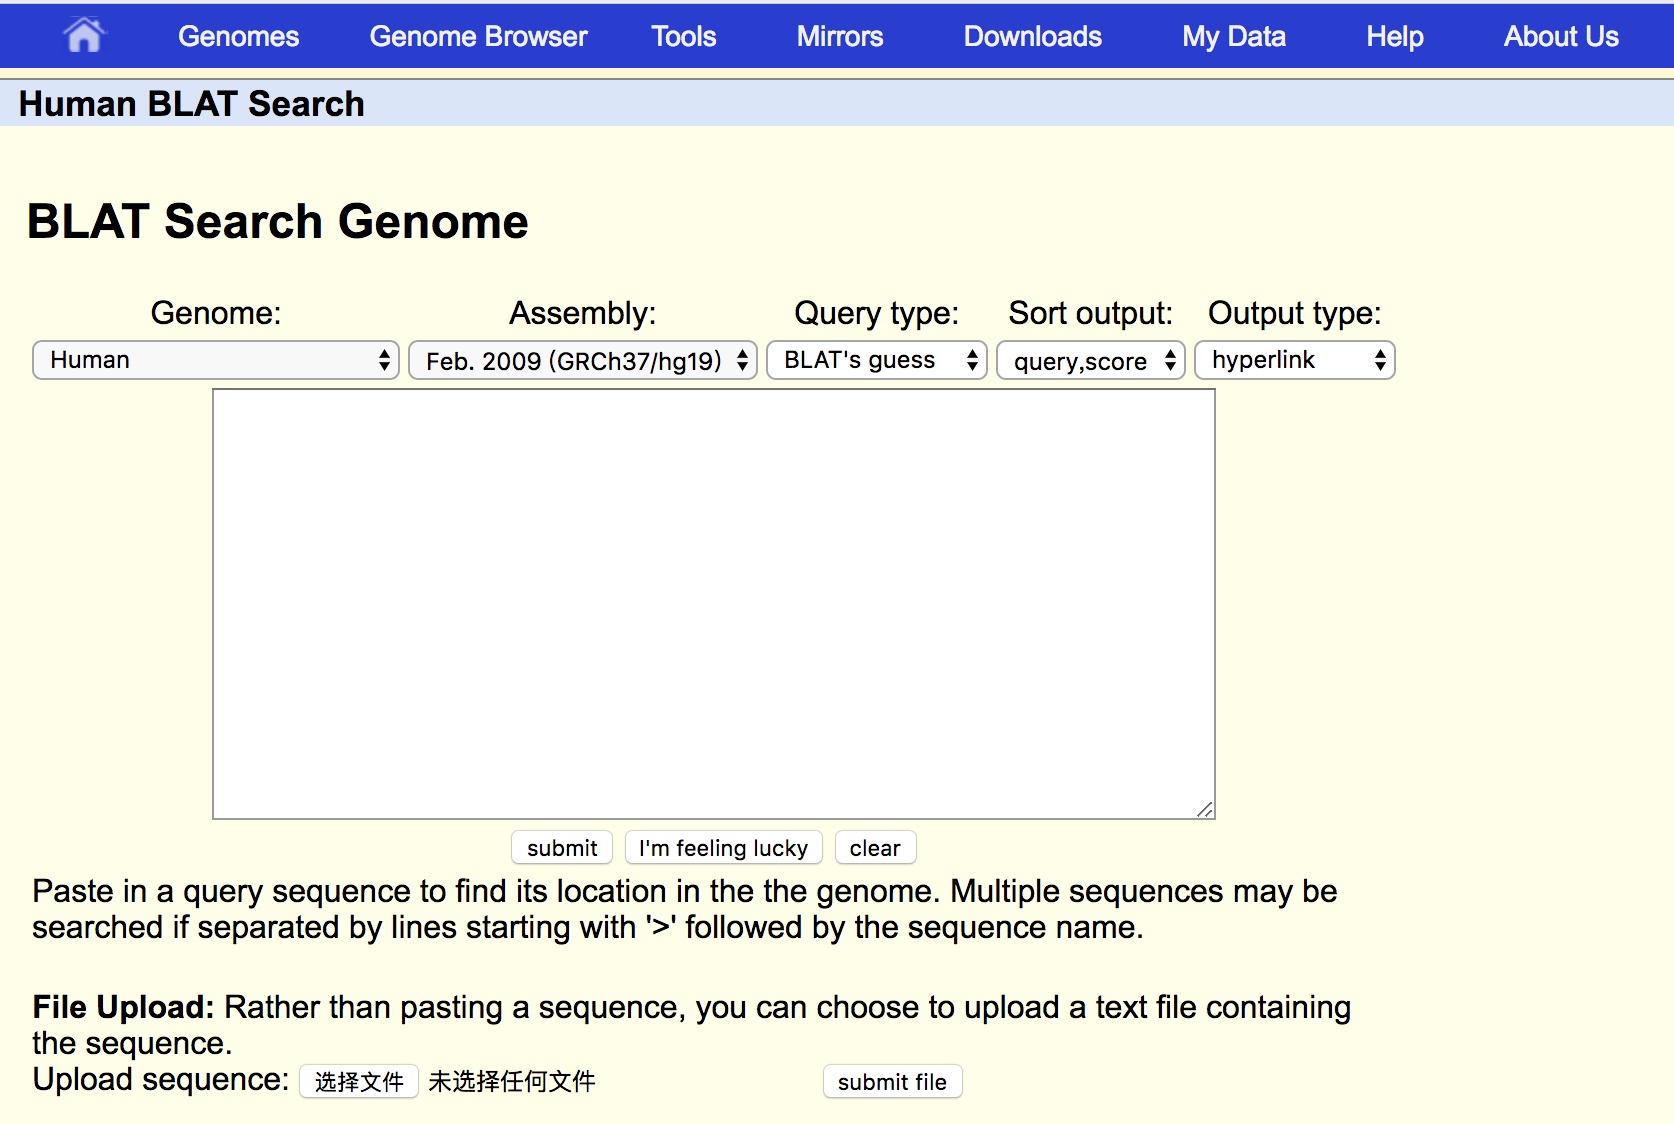
使用很简单:第 1 行选择基因组版本(比如常用的 hg19),下面的白框粘贴标准 FASTA 格式的序列,点 submit 即可。
来看一个真实分析中遇到的问题:一份小 RNA 测序数据(reads 平均长度小于 200bp)比对到 miRNA 序列库后,只有 2 条 miRNA 各自比对上了大量 reads,其余 1800 种 miRNA 总共才比对上 10000 条:
hsa-mir-7641-2    2000000
hsa-mir-7641-1      50000
通过 miRBase 查到这两条序列:
>hsa-mir-7641-2
GUUUGAUCUCGGAAGCUAAGCAGGGUCGGGCCUGGUUAGUACUUGGAUGGGAG

>hsa-mir-7641-1
UCUCGUUUGAUCUCGGAAGCUAAGCAGGGUUGGGCCUGGUUAGUACUUGGAUGGGAAACUU
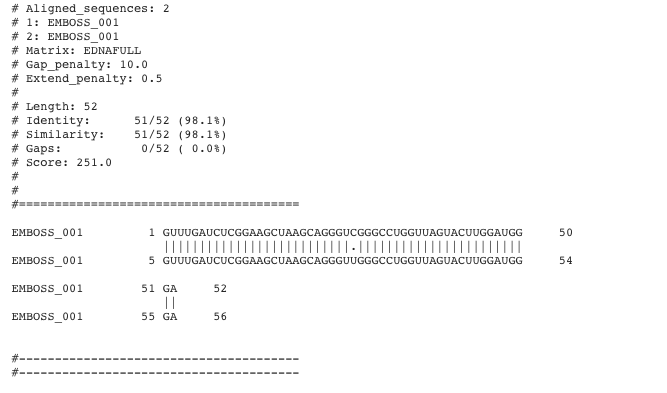
请使用 BLAT 与双序列比对工具(推荐 EMBL-EBI 的 EMBOSS Water,2026 年 10 月核对可访问)探索并解释原因。
参考解答:
- 先用 BLAT 查这两条序列定位在哪里( 图 4.23 、 图 4.24 ):两条序列都比对到了 5S rRNA 中间的一段序列上;
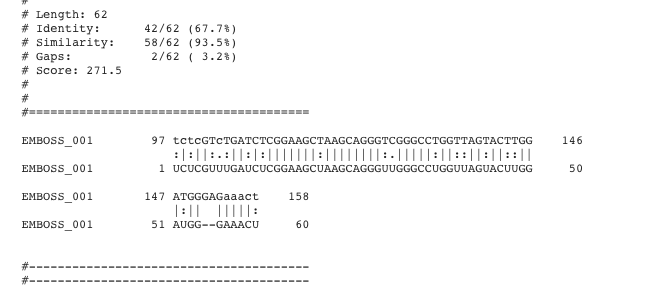
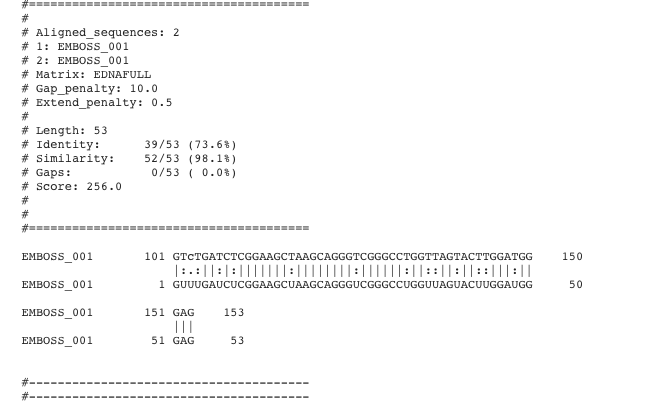
- 再用 EMBOSS Water 做局部双序列比对:两条 miRNA 与 5S RNA 高度重合( 图 4.25 、 图 4.26 ),两条 miRNA 之间也高度相似( 图 4.27 );
- 结论:小 RNA 建库时核糖体 RNA 不可能完全去除,5S rRNA 片段被当作小 RNA 测了出来,于是“冒充”miRNA 霸占了比对结果。这个案例也提醒我们:比对结果异常时,先怀疑实验与建库,再用工具求证。


基于哈希表的比对算法
说回到我们手上的高通量数据,类比 blast 查询:fq 文件就是我们要检索的序列,reference genome 就是我们手上的数据库,要做的事情就是把 fq 里面的序列全部在 reference genome 上找位置。与 BLAST 不同的是,这回面对的是成千上万条序列的检索,而数据库相对小了很多,检索序列也比传统 sanger 读长短得多。按核心算法不同,高通量比对软件大致分成两大阵营:哈希表(hash-table)与 BWT/FM 索引,本小节讲前者,下一小节讲后者( 图 4.28 概括了测序技术与比对算法的对应关系,图片引自 Alser 等人的综述5)。
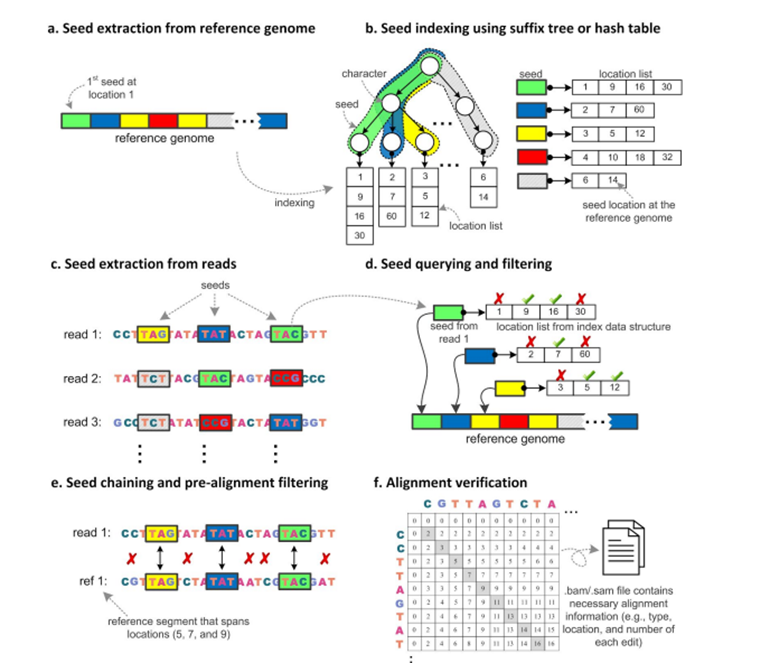
哈希表把关键码值(key value)映射到表中的具体位置,从而加快查询。基于哈希表的比对采用种子序列定位及延伸算法(seed-and-extend algorithm)。
根据索引构建对象的不同,可以将软件分为两类:基于参考基因组索引的延伸比对软件与基于短序列数据集索引的延伸比对软件。
PASS 和 GASSST 根据参考基因组构建哈希表,通过查询短序列在参考基因组中的候选位置来定位;另一类软件则对短序列数据集建立索引,查询方向与前者相反。大部分哈希表比对软件采用后一种方法,如 SOAP、SeqMap 等。
按比对策略划分,哈希表比对又可分为连续种子序列(contiguous seed)策略与间隔种子(spaced seed)策略。 比较这两种策略之前,先看哈希表怎样构建。
哈希表的构建
这里需要用到 k-mer:沿一条序列依次选取长度为 K 个碱基的子序列。若原序列长度为 L,k-mer 长度为 K,就可以得到 \(L-K+1\) 个 k-mer。
DNA 序列由 A、T、C、G 四种碱基排列而成。我们可以用四进制表示序列,再转换为十进制,以此构建生成哈希表关键码值的函数 H(x),编码方式见 图 4.29 。
图注:A、T、C、G 分别编码为 0、1、2、3;将序列对应的四进制数转为十进制,得到哈希关键码。
举个例子,如果某个子序列为ATGCT,其中我们设定A->0, T->1, C->2, G->3,并把序列末端的碱基当作最低位,则
\[ H(\mathrm{ATGCT}) = 1\times4^0 + 2\times4^1 + 3\times4^2 + 1\times4^3 + 0\times4^4 = 121 \](4.2)
这样我们就得到了 5-mer 序列在哈希表中的关键码值( 公式 4.2 )。将上面的方法进一步推广,对长度为 \(n\) 的序列有通式
\[ H(X) = I(n)\times4^{\,n-1} + I(n-1)\times4^{\,n-2} + \cdots + I(1)\times4^0 \](4.3)
其中 \(I(j)\) 是第 \(j\) 个碱基对应的编码值(见 公式 4.3 )。
把参考基因组中所有 k-mer 的位置存入哈希表( 图 4.30 以 k=5 为例),就记录了所有 seed 序列的位置。查询输入序列时,先找到种子的比对位置,再通过延伸确定整条序列的位置。
图注:每个 5-mer 作为关键码,指向它在参考基因组中出现的位置。
连续种子序列策略
连续种子序列策略先把短序列拆成 k-mer 子序列,再到参考基因组 k-mer 构建的哈希表中查找匹配,完成回溯。
这种算法的缺点是显而易见的,即不允许mismatch的存在,如果序列中出现了至少一个位点的突变,则该位点就会被过滤掉。为了弥补这种缺陷,软件设计者们采用了鸽洞原理(pigeonhole principle)对算法进行了修正:首先,将短序列分割成等长的多段子序列,进行定位时,如果完全match上,则证明序列定位成功,如果存在mismatch,只要不超过设定的某个mismatch数目,则将该序列设定为候选序列,在所有候选序列汇总后选出最少的mismatch作为回溯序列。而后又陆续推出了一系列的修正算法,如q-gram过滤算法,但由于本书重点不在算法解释,仅作简单介绍,有兴趣的读者可以自行查阅相关文献。
图注:24 nt 的 read 分成 4 段,第 2 段含 1 处错配(✗)。即使该段无法精确命中,其余 3 段(✓)仍能在哈希表中定位到参考基因组上。
间隔种子序列策略
间隔种子序列允许中间若干个位置的碱基不确定,也就是在这些位置允许 mismatch。例如,种子 AGxCGTAA 既可以匹配 AGGCGTAA,也可以匹配 AGCCGTAA。这样能明显提高比对灵敏度,但也会明显增加时间复杂度。
BWT 与 FM 索引
无论采用的是连续种子策略还是间隔种子策略,两者都存在共同的问题,即面对高重复序列的真核生物基因组时,比对效果会比较差,究其原因就是因为k-mer分割所导致的。为了解决这个问题,软件设计者们把目光投向了另一类索引结构:后缀树与后缀数组。后缀树把参考序列的所有后缀组织成一棵树,查询很快,但把所有后缀完整存下来非常吃内存;后缀数组省得多,但对人类基因组来说仍然不小。这一方向真正的突破在于:不需要真的存下整棵树或整个数组,只需要存下参考序列的 BWT 字符串和少量辅助数组,就能模拟在后缀数组上的查找,这就是 FM 索引(FM-index)。Bowtie、BWA 这类软件正是靠它做到了既省内存又快速定位。
BWT(Burrows-Wheeler Transform)原本是一种用于文本压缩的变换,压缩工具 bzip2 就使用了它。它重新排列原文本,使相同字符连续或相邻,再配合其他方法压缩文本。
构建 BWT 的步骤如下:
- 给定一个子序列,譬如:ACAACG,在其末尾加入一个只会出现在结尾的特殊符号
$,然后写出它全部 7 个循环旋转(rotation),见 图 4.32 。每一行都是把原序列 ACAACG$ 循环左移一位得到,$ 只出现在结尾;高亮的第一行就是原序列本身。
ACAACG$ 的全部循环旋转
- 将所有旋转按字符顺序(ASCII 顺序,
$最小)排序,得到排序后的旋转矩阵,见 图 4.33 。
图注:排序规则为 $ < A < C < G。
- 取排序矩阵每一行的最后一个字符,按行连成一个序列,即得到 BWT =
GC$AAAC。矩阵第一列记为 F 列(排好序的),最后一列记为 L 列(就是 BWT 本身)。
构建 BWT 后,还原原序列的过程(回溯)就是解码。它依据下面两条性质:
- L 列的第一个元素(G)是原始序列的最后一个字符——因为排序后第一行是
$ACAACG,它就是原始序列本身,其结尾的 G 正是原序列最后一个字符。 - 同一行中,L 列的字符在原序列中紧挨在 F 列字符的前面。利用这一对应关系(LF 映射),从 L 走回 F,就能一步一步把原序列从后往前还原出来。
以 GC$AAAC 为例,解码过程如下:
- 第 1 步( 图 4.34 ):确定原序列的最后一个字符是 G,目前的还原结果是
G。
图注:从 $ 所在行确定原序列以 G 结尾,当前逆序还原结果为 G。
- 第 2 步( 图 4.35 ):沿着 LF 映射走一步,G 的前一个字符是 C,目前的还原结果是
GC。
图注:G 前面是 C,当前逆序还原结果为 GC。
- 第 3 步( 图 4.36 ):继续沿 LF 映射,C 的前一个字符是 A,目前的还原结果是
GCA。
图注:C 前面是 A,当前逆序还原结果为 GCA。
- 后面依次类推( 图 4.37 ),依次得到
GCAA、GCAAC、GCAACA。把GCAACA反过来读,就是原序列ACAACG,说明解码成功。
图注:依次得到 GCAA、GCAAC、GCAACA,逆序即原序列 ACAACG。
有了上面的推导再回头看 4.2.1 的建索引:目前 BWA、Bowtie、Bowtie 2 的核心用的都是 BWT/FM 索引——把人类基因组的 BWT 字符串和少量辅助数组存下来,就能既省内存、又以对数级时间完成海量 reads 的定位,这正是它们能“秒级”完成上千万条 reads 比对的底层原因。
本节内容待补充。
4.5 根据数据选择比对策略
能为 DNA 与 RNA 选择合适策略并解释未比对或多重比对。
常用比对软件与选择
现在最为流行的二代测序比对软件基本都是基于 BWT/FM 索引的,例如最早的 Bowtie 与 BWA;Bowtie 2 是它们的同族后继版本,支持空位与局部比对;在 RNA-Seq 方向,TopHat2(已停止维护)曾经流行,如今的主流是 HISAT2 与 STAR 等剪接比对软件。需要说明的是:TopHat2 内部调用 Bowtie 2 做比对,而 HISAT2 是独立的实现,使用的是层次化 FM 索引(图 FM 索引),并不是”基于 Bowtie 2 改进”而来。软件会更新换代,但底层索引思想都来自本章前面讲的 BWT。
面对一个具体项目,可以按数据类型先做一轮初筛( 表 4.3 ;表中软件均收录于 bioconda,2026 年 10 月核对可安装):
| 数据类型 | 常用软件 | 选择理由 |
|---|---|---|
| DNA 测序(WGS/WES/ChIP 等) | BWA-MEM、Bowtie 2 | 读长中等、需要唯一定位与空位支持 |
| 剪接数据(mRNA 的 RNA-Seq) | HISAT2、STAR | reads 可能跨越内含子,需要剪接感知比对 |
| small RNA(miRNA 等,18–30nt) | Bowtie(v1) | 序列很短,不允许空位的严格全局比对更合适 |
| 长读长(PacBio/ONT) | minimap2(pbmm2 基于它) | 为长读段错误模式设计 |
本章仅对 BWA、Bowtie 以及 Bowtie 2 做深入比较,方便读者在科研工作中选择。
BWA 提供多种比对模式,可以根据基因组大小和序列长短选择。其中 mem 模式对长序列支持更好,也能处理三代测序数据;BWA 更常用于重测序数据处理。
Bowtie 2 可以看作 Bowtie 的升级版本:它支持 gap 和局部比对,在中长序列(50-1000bp)的处理上速度和准确性更好。面对 small RNA 等短序列时,不允许 gap 的 Bowtie 则更有优势,因为它的比对更严格,仅将全局最优的序列视为比对成功。
至于BWA与Bowtie 2在处理转录组数据时谁更具备优势,其实很难界定,更多是看个人的工具使用倾向。真正针对”reads 跨外显子”这一问题的,是表中的剪接比对软件;HISAT2 在 2019 年下半年的大版本更新后性能有明显提升,在许多研究中被越来越多地使用。
Bowtie 2 实操
下面以 Bowtie 2 为例,介绍安装、使用和结果检查中的注意事项。
Bowtie 2 的安装
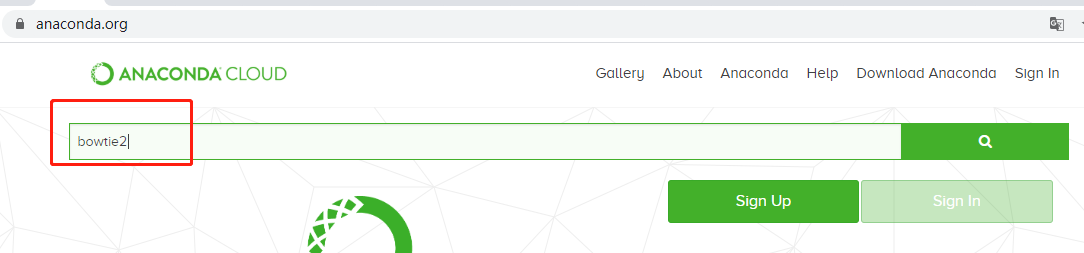
Bowtie 2 已收录在 conda 的 bioconda channel 中,用 conda 安装最方便。可以直接访问 bioconda 的软件页面(https://anaconda.org/bioconda/bowtie2,2026 年 10 月核对可访问),也可以按下图在 Anaconda 云端检索。以下截图摄于 2019 年前后,界面可能已有调整,操作仍是搜索软件名、进入软件页、复制安装命令。
如果不知道软件在哪个 channel,可以先在浏览器中搜索“conda cloud”,下图以必应为例。
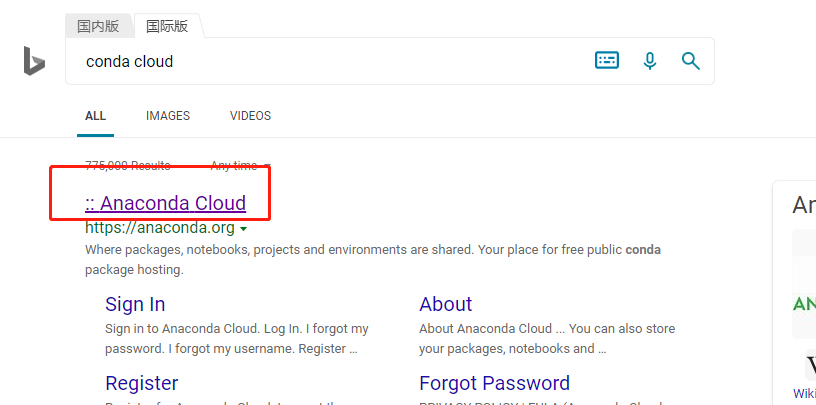
打开页面后,搜索 Bowtie 2。
搜索结果如下:
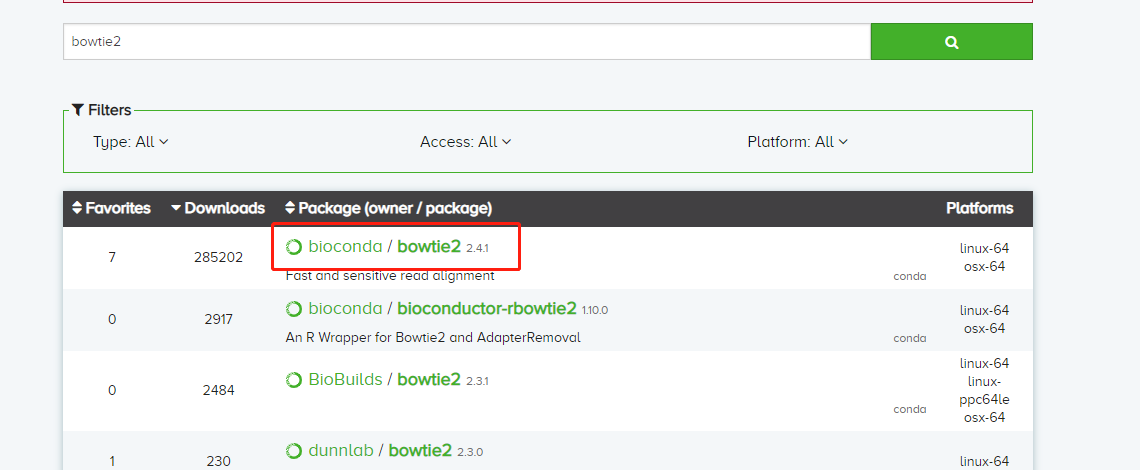
打开软件页面,就能看到安装命令。
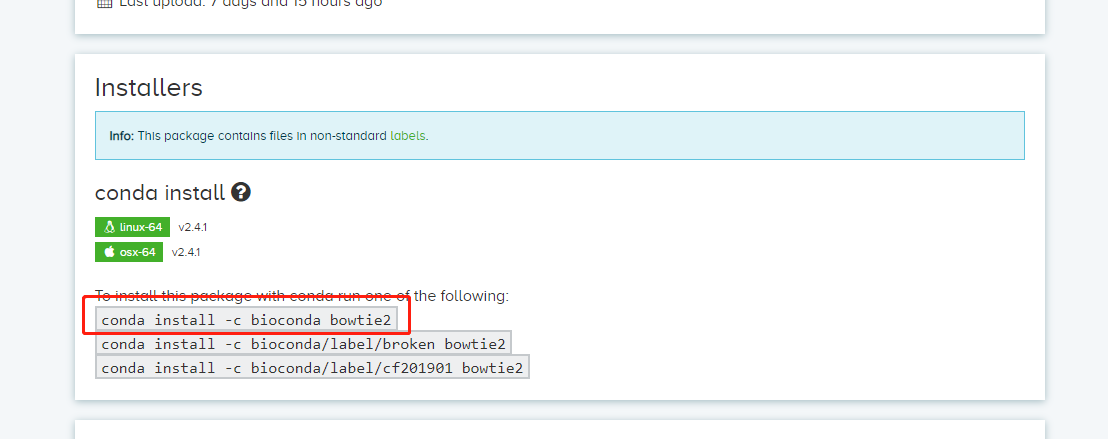
conda install -c bioconda bowtie2
#在软件检索完成之后,按照提示输入y即可按照完成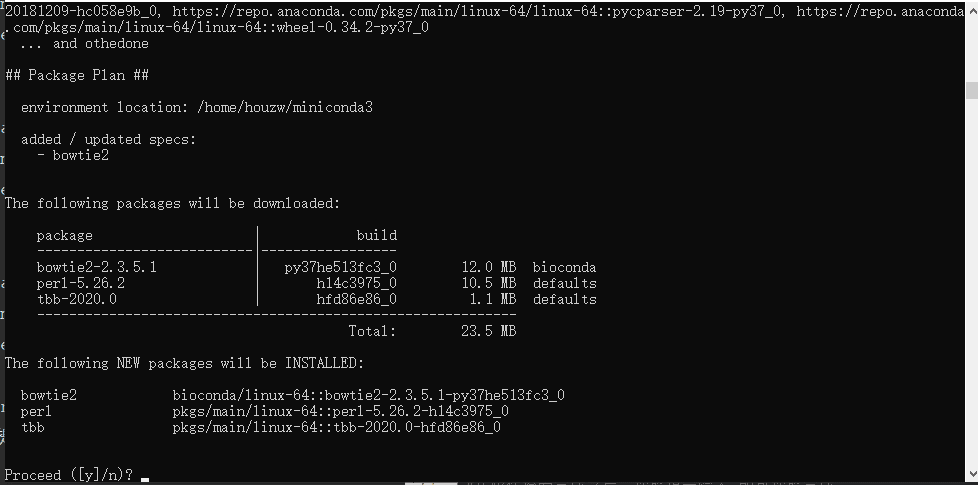
安装完成后,在命令行输入 Bowtie 2,连续按三次 Tab 补全键,即可查看以 Bowtie 2 开头的命令。

这种安装方法较简单,推荐刚入门的同学使用。已经熟悉相关操作的读者,也可以自行下载软件并配置全局调用,下面简要介绍这种方式。
先在搜索引擎中搜索 Bowtie 2。
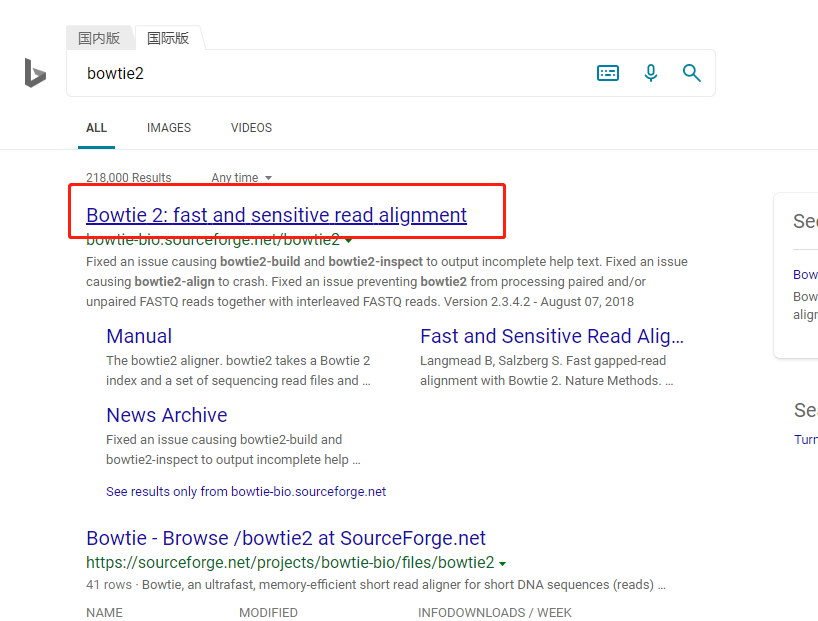
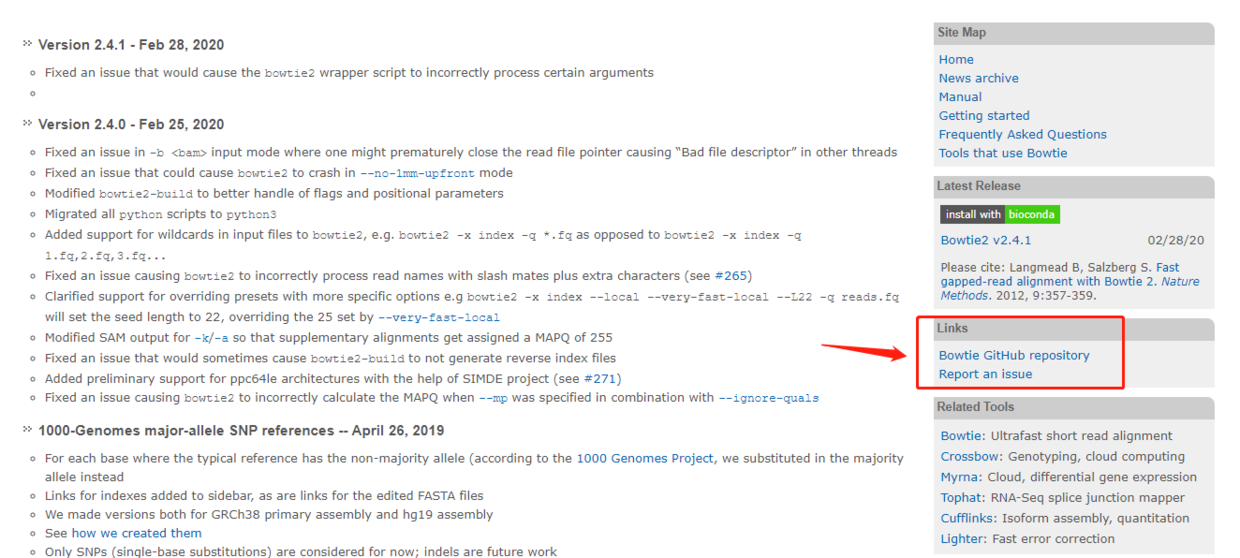
进入官网后,可以查看各版本修复的问题;右下角的 GitHub 链接指向源码下载页面。
点击绿色的 clone 按钮。Windows 用户可以下载 ZIP 压缩包,解压后传到服务器;如果服务器网络较好,也可以直接 clone 到服务器。
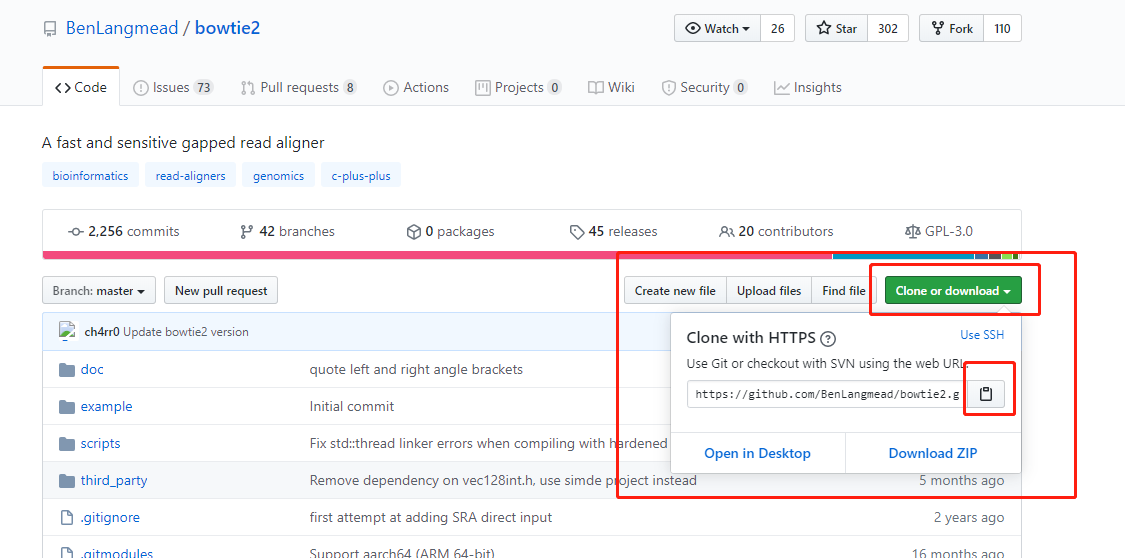
git clone https://github.com/BenLangmead/bowtie2.git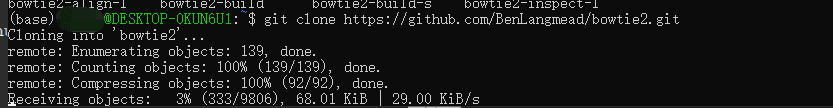
#由于bowtie2是无需编译的,下载完成后,即可立即使用

#进入下载后的文件夹,不知道文件夹全名是什么可以ls一下,即可看到当前目录的所有文件跟文件夹,选择进入
cd bowtie2

#看到bowtie2文件夹内的所有文件
ls

#选择当前文件夹内的程序使用./+文件名,-h即打开说明书,回车一下即可看到bowtie2的使用说明
./bowtie2 -h

#获取当前的全路径,并复制
pwd

#打开环境配置的文件,按i进入编辑模式,去到最后一行输入下一列内容
vim ~/.bashrc

#从home到bowtie2这一段为刚刚pwd复制的全路径
export PATH="$PATH:/home/Alfred/biosoft/bowtie2/bowtie2-2.3.5.1-linux-x86_64/"

#ESC键退出编辑模式,并按:wq,退出并保存
source ~/.bashrc #更新当前环境
对刚入门的同学,我建议优先用 conda 安装,暂时不必自行下载软件、更新环境。熟悉 Linux 的操作后,再按需要尝试手动安装。
Bowtie 2 的使用
遇到不熟悉的软件,先读说明书,再参考已有的使用经验。Bowtie 2 的 GitHub 下载页面下方就有简要使用说明,可以从这里开始。
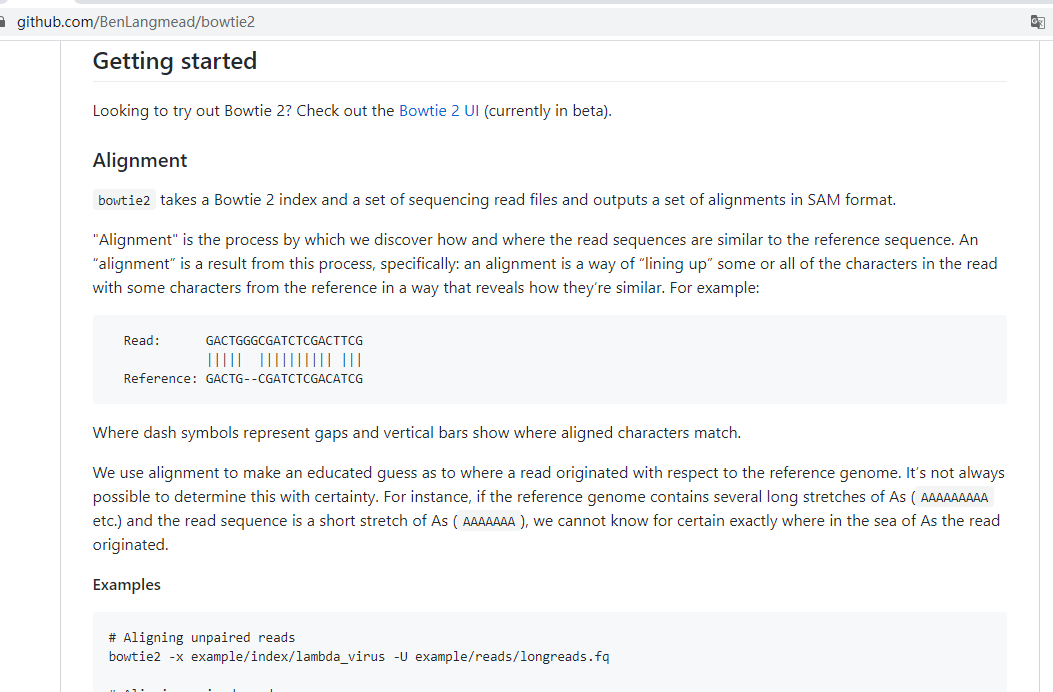
下面通过一个实际例子说明用法。
首先,我们需要下载参考基因组:本例使用人的 X 染色体(chrX),可以从 UCSC 的 hg19 下载目录获取(https://hgdownload.soe.ucsc.edu/goldenPath/hg19/chromosomes/,2026 年 10 月核对可访问),下载完成之后即为一个 fa 文件。

先用 Bowtie 2 为这个参考基因组构建索引,供后续比对时查询和定位 reads。
bowtie2-build chrX.fa chrX.fa
# bowtie2-build命令为构建索引的命令
# 第一个chrX.fa代表输入的参考序列
# 第二个chrX.fa代表输出的索引文件前缀
# 产生以 chrX.fa 为前缀的六个 .bt2 索引文件
接下来,将上一步处理好的 clean data 比对到参考基因组,找到各条短序列对应的位置。运行前,先了解 Bowtie 2 的主要参数。
必选参数
| 参数 | 含义 |
|---|---|
-x <bt2-idx> |
索引前缀,即刚刚由 bowtie2-build 生成的 chrX.fa |
-1 <m1> |
双端测序对应的 R1.fastq,可为多个文件并用逗号分开,需与 -2 的文件一一对应 |
-2 <m2> |
双端测序对应的 R2.fastq |
-U <r> |
单端测序对应的 fastq,可为多个文件并用逗号分开 |
-S <sam> |
指定输出的 SAM 文件名 |
常用可选参数
| 参数 | 含义 |
|---|---|
-p/--threads <num> |
设置线程数,默认为 1 |
--reorder |
配合 -p 使用,使比对结果顺序与 fq 的 reads 顺序一致 |
--seed <int> |
设置随机种子 |
--no-unal |
不记录没比对上的 reads |
--un-gz <path> |
将 unpaired 的未比对 reads 输出到 <path> 并以 gzip 压缩 |
--al-gz <path> |
将至少能比对 1 次以上的 unpaired reads 写入 <path> 并以 gzip 压缩 |
-5/--trim5 <int> |
剪掉 5’ 端 <int> 个碱基再比对 |
-3/--trim3 <int> |
剪掉 3’ 端 <int> 个碱基再比对 |
比对参数
| 参数 | 含义 |
|---|---|
-N <int> |
种子区域内允许的 mismatch 数目(默认 0),除非是跨物种比对,一般不更改 |
-L <int> |
设置比对时 reads 种子的长度 |
-i <func> |
设置两个相邻种子间的间隔函数 |
--n-ceil <func> |
设置 reads 中允许含有的 N 碱基数目 |
--gbar <int> |
设置头尾 <int> 个碱基内不允许出现 gap |
--end-to-end |
全局比对,为默认模式 |
--local |
局部比对,read 两端的碱基可以不参与比对罚分 |
罚分参数
| 参数 | 含义 |
|---|---|
--ma <int> |
设置匹配得分,仅在 --local 时生效,默认为 2,全局比对时匹配不加分 |
--mp MX,MN |
设置错配罚分,MX 为最高罚分,MN 为最低罚分,默认为 MX=6、MN=2;设置 --ignore-qual 时每次错配罚 MX |
--np <int> |
当匹配到 N 时的罚分,默认为 1 |
--rdg <int1>,<int2> |
设置 read 上打开 gap 罚分 <int1>、延长 gap 罚分 <int2>,默认为 5,3 |
--rfg <int1>,<int2> |
设置 reference 上打开 gap 罚分 <int1>、延长 gap 罚分 <int2>,默认为 5,3 |
--score-min <func> |
设置有效比对的最小分值函数,全局比对默认为 L,-0.6,-0.6,局部比对默认为 G,20,8 |
双端比对参数
| 参数 | 含义 |
|---|---|
-I/--minins <int> |
设置允许插入片段最小长度,默认为 0 |
-X/--maxins <int> |
设置允许插入片段最大长度,默认为 500 |
第一次运行时,通常只需设置必选参数和线程数,再根据比对结果调整其他参数。
bowtie2 -p 10 -x chrX.fa -1 ERR188245_chrX_1.fastq.gz -2 ERR188245_chrX_2.fastq.gz -S ERR188245.sam &比对结果检查
比对完成后,Bowtie 2 会输出记录比对情况的日志,可用于初步检查。若要查看每条染色体的比对情况,我推荐使用 Qualimap 2。该软件可以用 conda 安装;注意 qualimap bamqc 需要已排序的 BAM 文件,SAM 或未排序的 BAM 要先转换、排序,下一节会介绍。
conda install -c bioconda qualimap运行 bamqc 进行检查:
qualimap bamqc -bam ERR188245_chrX.sorted.bam -outdir bamqc_result -outformat PDF:HTML如果还想检查注释区域,可以添加指定 GFF 文件的参数:
qualimap bamqc -bam ERR188245_chrX.sorted.bam -gff chrX.gff -outdir bamqc_result -outformat PDF:HTML
4.6 比对结果:SAM/BAM 文件的操作与过滤
能把比对结果转换成适合下游分析的输入。
比对结果文件(SAM/BAM)记录的就是每条 read 在基因组上的位置和比对情况,包括 read 名称、所比对的染色体与位置、比对质量和序列本身。下面逐项看这些信息怎样存储,又怎样读取和过滤。
SAM 与 BAM 总览
SAM 的全称是 Sequence Alignment Map,设计之初就是为了存储 mapping 结果。BAM 是 SAM 的二进制压缩版本:内容完全等价,体积小得多,排好序后还能随机访问。一个标准的 SAM 文件由两部分组成:第 1 部分是以 @ 开头的头部;第 2 部分是紧跟在头部后面的比对结果。
经过 Bowtie 2 比对之后,会生成一个后缀是 sam 的结果文件。下面我们使用 less 指令查看这个文件( 图 4.51 ; 图 4.52 是另一份文件的完整视图):
less ERR188245.sam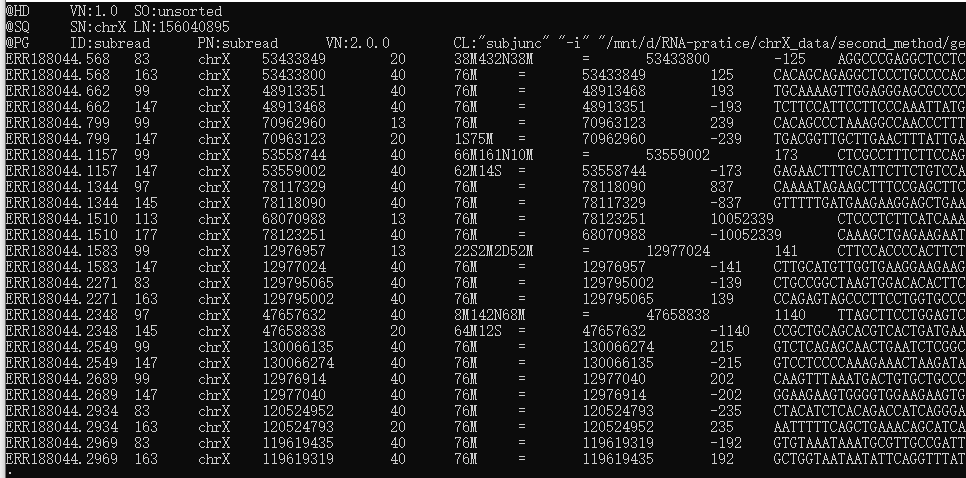
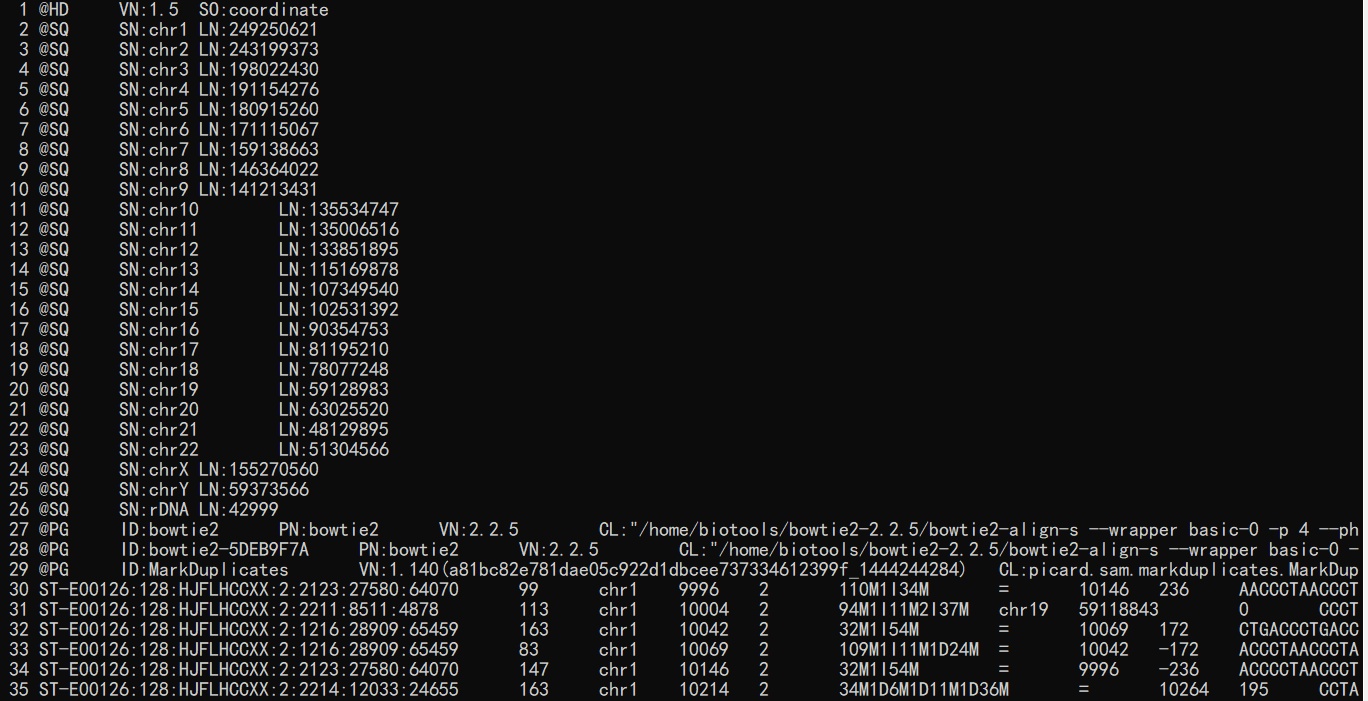
头部信息我们已经在图里见过:@HD 说明版本与是否排序(SO:coordinate 表示已按坐标排序),@SQ 列出每条参考序列的名称和长度,@PG 记录产生该文件的程序与命令行。真正承载数据的是头文件下面的比对结果:每行一条 read,共 11 个必需列,各列含义汇总见 表 4.4 ,下一小节结合实例逐列展开。
| 列 | 字段 | 含义 |
|---|---|---|
| 1 | QNAME | read 的编号,来自 FASTQ 第一行 |
| 2 | FLAG | 位标识,多种比对情况的数值之和 |
| 3 | RNAME | 比对到的参考序列(染色体)名,未比对上为 * |
| 4 | POS | 比对起点位置,1-based;未比对上为 0 |
| 5 | MAPQ | 比对质量,255 表示不可用 |
| 6 | CIGAR | 比对情况表达式(匹配、错配、插入、缺失等) |
| 7 | RNEXT | 配对 read 比对到的参考序列名,同一参考序列为 = |
| 8 | PNEXT | 配对 read 比对到的位置,不可用为 0 |
| 9 | TLEN | 模板长度:左端为正、右端为负,不可用为 0 |
| 10 | SEQ | read 的序列信息 |
| 11 | QUAL | read 的碱基质量,编码方式同 FASTQ |
逐列读懂比对结果
第一列是 read 的编号,图中以 ERR 开头,对应 FASTQ 文件中这条 read 的第一行。 第二列是 FLAG(位标识),用一个整数记录比对情况,其值为下列各适用标识值之和:
0   :未设置任何特殊位(如单端、比对到正链)
1   :是 paired-end 或 mate pair 中的一条
2   :同一模板的各片段满足比对软件定义的正确配对条件(proper pair)
4   :没有比对到参考序列上
8   :另一片段(mate)未比对到参考序列
16  :比对到参考序列的负链上
32  :双末端 reads 的另一条(mate)比对到参考序列的负链上
64  :这条 read 是 mate 1
128 :这条 read 是 mate 2
# 后续根据比对情况进行过滤就会用到这些数字
第三列、第四列分别是比对到的参考序列(染色体)名与具体起点位置(1-based 计数),表格中已有汇总,这里不再逐列重复。
第五列 MAPQ(比对质量)值得单独展开。回想 FASTQ 的第 4 行记录每个碱基的测序质量(phred 值),MAPQ 则回答“这条 read 放在这个位置有多可信”。为什么需要它?举个例子( 图 4.53 ):一条 readA 既能比对到 1 号染色体 100000 处(含 1 个错配),也能比对到 2 号染色体 200000 处(含 2 个错配),那它到底该算哪里?这时就需要一个度量值帮我们做判断、选择最好的那个作为最终结果(研究特殊问题时也可以把相似的结果都输出),这个度量值就是 MAPQ。
根据 SAM 官方规范的定义:
MAPQ: Mapping Quality. It equals -10 log10 Pr{mapping position is wrong}, rounded to the nearest integer. A value 255 indicates that the mapping quality is not available.
翻译过来:MAPQ 的计算方法与 FASTQ 的质量值同源,
\[ \mathrm{MAPQ}=-10\log_{10}\Pr\{\text{mapping出错}\} \](4.4)
当 MAPQ=255 时,代表该值不可用,只是一个占位符。至于“mapping 出错的概率”怎么算:各软件结合比对情况与碱基测序质量评估——核心思想是低质量碱基若发生错配,很可能是测序错误,不应重罚;低质量碱基即使完美匹配,置信度也不高。
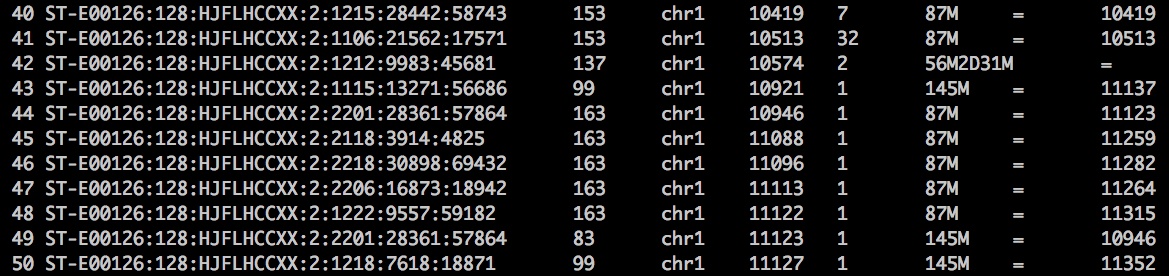
下游分析通常会把 MAPQ 过低的 reads 去掉。阈值没有统一规定,按分析目的选择:粗略统计常用 MAPQ≥10,常规过滤常用 MAPQ≥20,寻找 somatic mutation 这类高置信度要求的分析常用 MAPQ≥30。不同软件的 MAPQ 计算体系不同,不能跨软件直接比较(见下面的练习)。
MAPQ 用 Phred 标度表达比对位置错误的概率。SAM 规范并未将取值限制为 0—60;255 表示没有可用的比对质量。具体算法、上限和过滤阈值依赖比对软件及分析目的,不能把 MAPQ≥20 当作普遍的可信保证。
第六列 CIGAR 简要描述比对情况,全称是 Concise Idiosyncratic Gapped Alignment Report,出自 SAM 官方规范。它由数字和字母组成,字母代表比对中的不同操作:
CIGAR 用“数字+操作符”串描述一条 read 与参考的比对情况:M 比对(同时包含匹配与错配)、I 相对参考的插入、D 相对参考的缺失、N 跳过参考区域(如内含子)、S 软剪切、H 硬剪切、P 填充、=/X 显式的匹配/错配。例如 3S38M432N38M 表示:先软剪切 3 个碱基,比对 38 个碱基,跳过参考上 432 个碱基(内含子),再比对 38 个碱基。实际数据中主要出现前 7 个操作符,= 与 X 多数软件不输出。完整的操作符列表见 表 4.5 。
| 符号 | 含义 |
|---|---|
| M | 比对(alignment match,包含 match 与 mismatch) |
| I | 插入到参考序列(read 有、参考没有) |
| D | 从参考序列缺失(参考有、read 没有) |
| N | 跳过参考序列上的区域(如内含子) |
| S | 软剪切(soft clipping),被剪掉的序列仍保留在 SEQ 列 |
| H | 硬剪切(hard clipping),被剪掉的序列不保留在 SEQ 列 |
| P | 填充(padding,很少用到) |
| = | 序列匹配(match) |
| X | 序列不匹配(mismatch) |
第七、八列 RNEXT、PNEXT 是双端测序专用:配对的另一条 read(mate)比对到的参考序列名和位置;同一参考序列记为 =,没有则为 * 或 0。
第九列 TLEN(template length)可以理解为这一对 read 覆盖区域从上游第一个碱基到下游最后一个碱基的距离:上游 read 取正值、下游 read 取负值,单端或不可用时为 0(具体计算见下面的练习)。
第十、十一列 SEQ、QUAL 就是这条 read 的序列与碱基质量,编码方式同 FASTQ——SAM 不仅记录比对,还把 reads 的原始信息完整保留了下来。
不必一次记住所有字段。先理解SAM 记录的就是每条 read 在基因组上的位置和比对情况,需要过滤数据时,再回来查相应字段的含义。
图 4.54 是一份真实 SAM 文件的前 4 列(最前面的行号是截图时加的,不在文件里)。请解释标号 38 那行 FLAG=83 的比对含义。
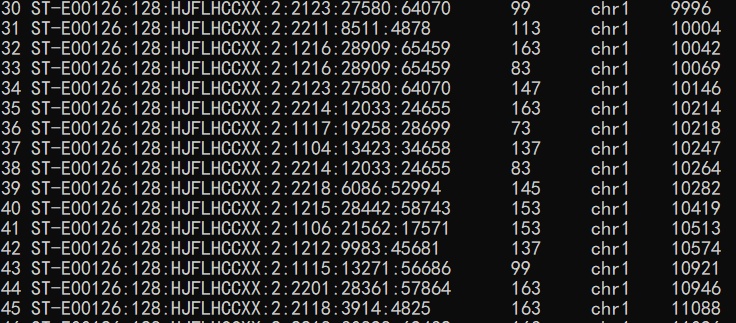
图注:最前面的行号是截图时添加的,不属于 SAM 文件。
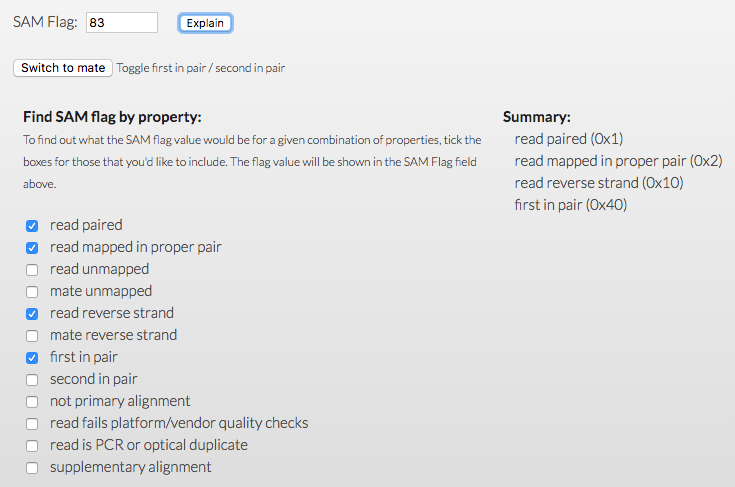
参考解答:可以手工分解,FLAG 是各二进制位之和:\(\mathrm{FLAG}=1+2+16+64=83\)。也可以用 Picard 的 Explain SAM Flags 工具(2026 年 10 月核对可访问),输入 83 即可得到分解( 图 4.55 )。FLAG=83 表示:
- 序列是双端测序的结果;
- 满足正确配对条件(proper pair);
- read 比对到了参考基因组的负链上;
- 此 read 是 read1。
问题 1:M、I、D、N 分别是什么意思?如果一条序列的 CIGAR=150M,能不能说这 150bp 区域中没有错配?
参考解答:M 表示比对(同时包含匹配与错配),I 表示相对参考序列的插入,D 表示相对参考序列的缺失,N 表示跳过参考上的区域。CIGAR=150M 不能说明没有错配:无论匹配还是错配都记为 M;想知道具体哪里有错配,要看 MD 标签(见下一小节)。
问题 2:一条来自成熟 mRNA 的序列比对到基因组时会遇到什么问题?如果它中间正好跨过 200bp 的内含子、前后各有 75bp 比对到外显子上,CIGAR 应该怎么写?
参考解答:成熟 mRNA 不含内含子,比对到基因组时会“跳过”内含子区域,对应操作符 N。该条序列的 CIGAR 为 75M200N75M。
问题 3:结合 图 4.56 理解 clip 的含义(soft clip 与 hard clip)。该图依据 SAM 规范中的官方示例绘制。
参考解答:以 r003 为例,它是嵌合比对(chimeric read),有两条记录:代表比对是 5S6M(前 5bp 软剪切),补充比对是 6H5M(前 6bp 硬剪切)。两条记录里 SEQ 列的长度分别是 11bp 和 5bp——软剪切时被剪掉的序列仍保留在 BAM 文件中,硬剪切时被剪掉的序列则不会出现在 SEQ 列里。图中 r004 的 6M14N5M 演示了跳过(N)内含子区域的 split alignment。
图 4.57 是一份包含 11 列的 SAM 文件截图。第 20 行第 9 列记录了 TLEN 值,请列出算式计算它。
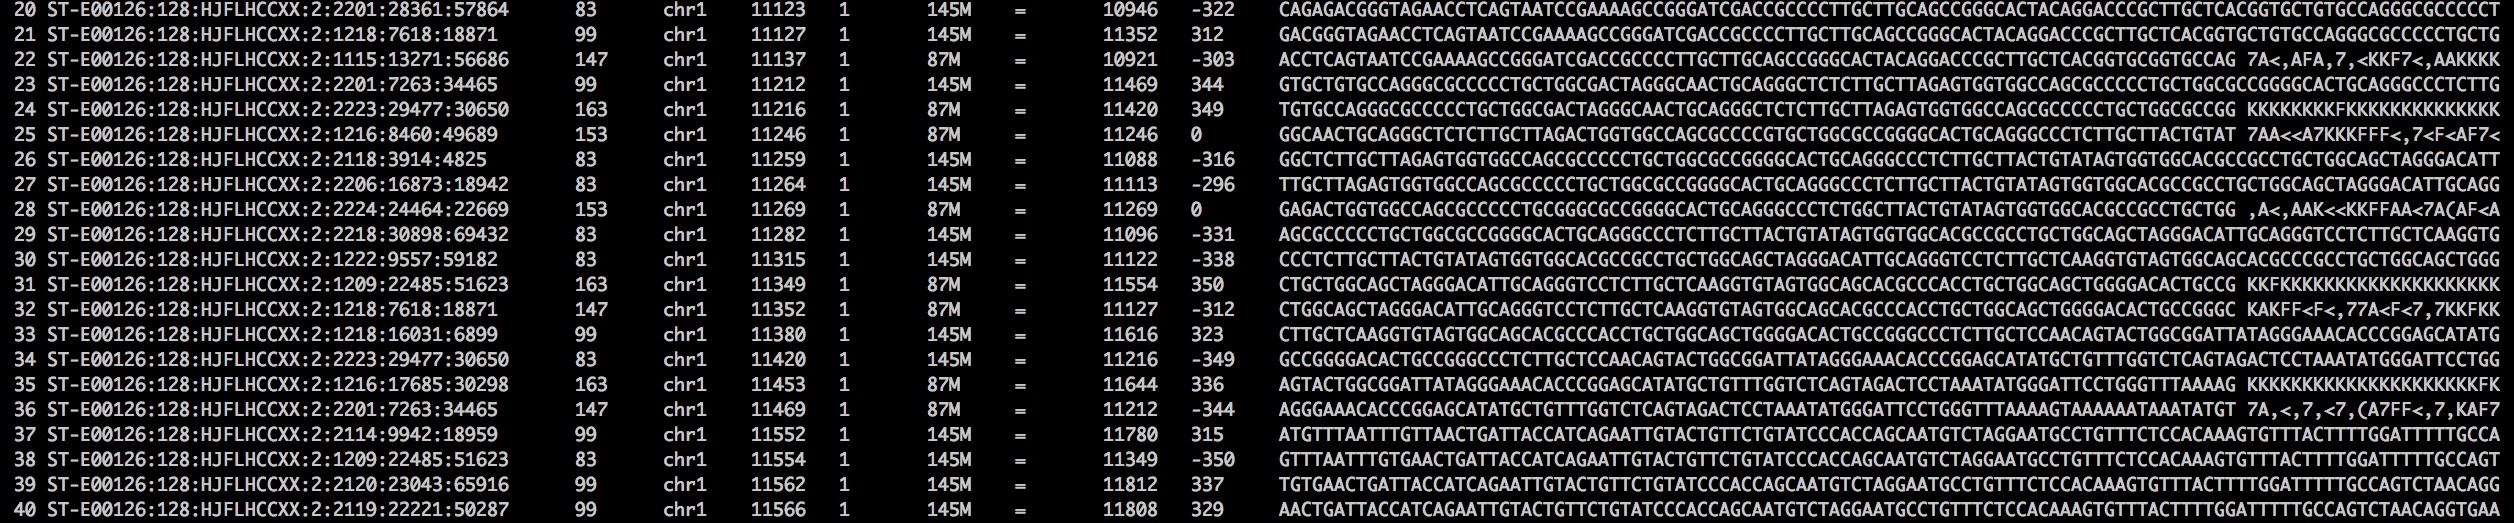
参考解答:第 20 行记录的下游 read 起点为 11123,CIGAR 为 145M,因此最后一个比对碱基的坐标为 \(11123+145-1=11267\)。其 mate 的起点为 10946;按 SAM 的 1-based 闭区间计算,外侧跨度为 \(11267-10946+1=322\)。等价地可写为 \(11123-10946+145=322\);下游 read 的 TLEN 取负值:
\[ -(11123-10946+145)=-322 \](4.5)
计算过程见 图 4.58 。
图注:左端起点为 10946;右端 read 从 11123 起,CIGAR 为 145M,终点为 11267。外侧跨度为 322 bp,左端 TLEN 为 +322,右端为 −322。图采用 IGV 风格,左端 read 长度仅作示意。
问题 1:如果 mapping 时输入的是 FASTA 文件(而不是 FASTQ),第 5 列 MAPQ 还有意义吗?第 11 列 QUAL 呢?
参考解答:都没有意义。FASTA 不包含测序质量信息:MAPQ 无法结合碱基质量计算,常用 255 占位;第 11 列本身是测序质量值,同样无从谈起。
问题 2:不同的比对软件(比如 BWA 与 Bowtie 2)计算出来的 MAPQ 意义相同吗?
参考解答:不能直接比较。BWA 与 Bowtie2 的核心索引思想相同,但比对策略和评价体系不同。不能认为 BWA 的 MAPQ=42 就好于 Bowtie2 的 MAPQ=40,反之亦然。
TAG 可选字段
11 列之后的内容称为可选字段(optional fields),不同比对软件会附加不同的标签。所有可选字段的格式必须是 TAG:TYPE:VALUE——比如 MD:Z:145 就是一个符合规范的值。三条规则:
- 所有的 TAG 都是 2 个字母,一般为大写,且在一行比对结果中只能出现 1 次;
- 所有的 TYPE 都是单字母、大小写敏感,定义后面 VALUE 的类型(对照见 表 4.6 ,最常用的是 i 带符号整数和 Z 可含空格的字符串);
- VALUE 可长可短,但必须与 TYPE 对应。
| 字母 | 类型 | 说明与示例 |
|---|---|---|
| A | 字符 | 可打印 ASCII 字符,如 A |
| i | 整数 | 带符号整数(32 位),如 NM:i:2 里的 2 |
| f | 浮点数 | 单精度浮点数 |
| Z | 字符串 | 可打印字符串,可以包含空格,如 MD:Z:145 里的 145 |
| H | 字节数组 | 十六进制字节串,如 1A2B |
| B | 数值数组 | 逗号分隔的数值数组,首字母 c/C/s/S/i/I/f 指定元素类型 |
查询 TAG 含义一定要从所用比对软件的官方文档中查找:SAM 文件头部的 @PG 字段记录了产生文件的软件与命令行,用 samtools view -H 就能看到。比如下面这个 @PG 说明文件由 Bowtie 2 2.2.5 产生:
@PG ID:bowtie2-5DEB9F7A PN:bowtie2 VN:2.2.5 CL:"/home/biotools/bowtie2-2.2.5/bowtie2-align-s --wrapper basic-0 -p 4 --phred33 -x /lustre/user/reference/hg19/hg19_combine -S ./tmp.data/fastq/genome-sequence.sam -1 ./tmp.data/fastq/genome-sequence_L3_1_trim5.fastq -2 ./tmp.data/fastq/genome-sequence_L3_2_trim5_92.fastq"下面是一条 Bowtie 2 产生的真实比对记录(human 全基因组比对,图 4.59 是它在文件中的样子)。请对照 Bowtie 2 官方手册的 SAM output 一节(2026 年 10 月核对可访问),解释每个字段与标签。
ST-E00126:128:HJFLHCCXX:2:2107:22820:18520 99 chr1 11682 1 145M = 11920 325 GGAGATTCTTATTAGTGATTTCGGCTGGTGCCTGGCCATGTGTATTTTTTTAAATTTCCACTGATGATTTTGCTGCATGGCCGGTGTTGAGAATGACTGCGCAAATTTGCCGGATTTCCTTTGCTGTTCCTGCATGTAGTTTAAA KKKKAAKKAFFKKKKKKFKFKKKFKKKKKKKKKKFKFKKKKKKKKKKKKKKFKFFKKKKKKFAAKAKKKKKKKKKKKKFFKKKFFFKKFKFFKKKKKKKKFFFFFKKKKKKK7<FFKKKKKKAFK<F<<7<AA,,7AA<7F7AA< MD:Z:21G6G116 XG:i:0 NM:i:2 XM:i:2 XN:i:0 XO:i:0 AS:i:-12 XS:i:-12 YS:i:-6 YT:Z:CP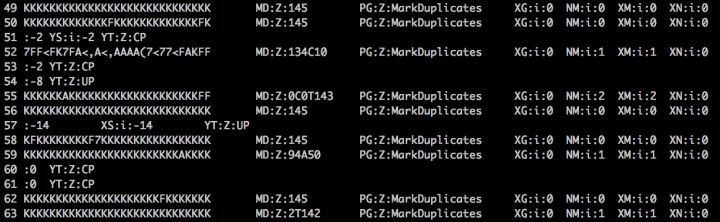
参考解答:
ST-E00126:...:18520:read 名称,通常含测序平台信息;99:FLAG(=1+2+32+64:双端、正确配对、mate 在负链、read1);chr1、11682:比对到的染色体与位置;1:MAPQ,\(\mathrm{MAPQ}=-10\log_{10}\Pr\{\text{mapping 出错}\}\);145M:CIGAR;=、11920:mate 比对到同一染色体及其位置;325:TLEN;- 序列与质量值(第 10、11 列);
MD:Z:21G6G116:比对中发生编辑的位置串——前 21bp 匹配,第 22 位 read 为 G(与参考不同),随后 6bp 匹配,再一位为 G,最后 116bp 匹配;XG:i:0:gap 延长次数(与 XO 的 gap 打开次数配合);NM:i:2:编辑距离(把 read 比对到参考所需的最少编辑次数);XM:i:2:错配数目;XN:i:0:覆盖区内参考上不确定碱基(N)的数目;XO:i:0:gap 打开次数;AS:i:-12:本条比对得分(Bowtie 2 全局模式得分常为负,local 模式不小于 0);XS:i:-12:除本条外最佳候选比对的得分(second-best,通常小于等于 AS;AS 与 XS 接近说明比对位置存在歧义);YS:i:-6:配对 read 的比对得分;YT:Z:CP:配对类型:UU未配对、CPconcordant、DPdiscordant、UP配对的另一条未比对上。
samtools 常用操作
在 Linux 中查看和处理 SAM/BAM 最好用的工具是 samtools(可用 conda install -c bioconda samtools 安装)。查看 SAM 文件的常用操作:
SAM 与 BAM 互转
SAM 是文本文件,比对结果动辄几 G,会占用较多磁盘空间。压缩能减小体积,转成二进制格式还能进一步节省空间,因此有了用于存储相同内容的 BAM 格式。区分两者时,可以借英文单词帮助记忆:s 对应 string,即字符、文本;b 对应 binary,即二进制。
BAM 是二进制文件,不能直接像文本那样用 less 查看。李恒为 SAM/BAM 开发的 samtools 可以处理这类文件,先来安装:
conda install -c bioconda samtools安装完成后,先在命令行将 SAM 文件转换为 BAM:
# 将sam文件转换为bam文件
samtools view -b ERR188245.sam > ERR188245.bam

# 同样的,我们可以把bam文件转为sam文件
samtools view -h ERR188245.bam > ERR188245.sam
要查看转换后的 BAM,可以先用 samtools 转为 SAM,再通过管道交给 less:
BAM文件的排序
全基因组测序数据进入下游分析前,需要对 BAM 文件排序。samtools、Picard 和 GATK 都能完成这一步。
使用samtools对bam文件进行排序:
如果是Picard的话,可以参考下面的命令:
java -jar picard.jar SortSam I=ERR188245_chrX.bam O=ERR188245_chrX.sorted.bam SORT_ORDER=coordinate如果使用GATK工具,对bam文件进行排序,可以参考:
BAM文件的index的建立
BAM 文件排序后就可以建立索引;未经排序直接建立索引会报错。命令如下:
samtools index ERR188245_chrX.sorted.bam运行后会得到索引文件,默认文件名通常是在 BAM 文件名后加上 .bai 后缀,本例为 ERR188245_chrX.sorted.bam.bai。对排序后的 BAM 进行某些操作时,通常需要将索引与 BAM 放在同一目录,否则可能报错。
对比对结果进行过滤
如果要按 mapping 质量或比对情况过滤,使用 samtools 的命令较为简洁。
注意:-F 只应出现一次;要同时过滤多个 FLAG 位,就把数值相加成一个数(例如 4+256=260)传入,前后写两个 -F 并不能自动合并。
对比对结果进行统计
下面的命令可以生成基础统计报告,包括 BAM 中测序片段的数量、整体突变情况和基因组覆盖度等。
samtools flagstat ERR188245_chrX.sorted.bam结果文件包含 reads 的比对情况,如比对成功的 reads 数量等。统计内容较丰富,但绘图还需要另写 R 或 Python 程序。因此,如果不追求运行速度,我仍建议使用 Qualimap 2。
顺带一提,SAM 不仅记录比对,还保留了 reads 的原始序列,所以也能反向提取 FASTQ:
samtools view -b -h filter_MAPQ20.sam > filter_MAPQ20.bam
samtools bam2fq filter_MAPQ20.bam > filter_MAPQ20.fastq
准备一个很小的测试文件 test.sam(约 4MB,可从百度网盘下载,密码 2drn;分享链接若失效,可按 4.2.1 的方法自行比对生成小数据),然后用 samtools 完成下面的操作。
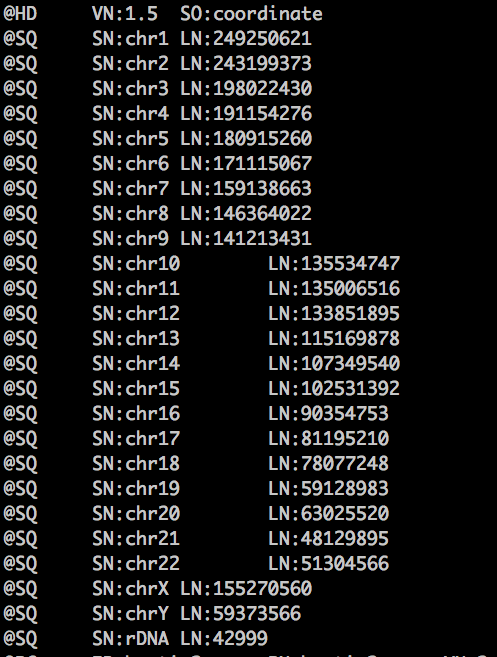
问题 1:用 samtools view 查看 test.sam 的 header,记录各条染色体的长度;这个文件是用哪种 mapping 软件产生的?
参考解答:查看 header 中的 @PG ID,显示使用的软件是 Bowtie 2;各条染色体的长度见 图 4.60 。
问题 2:把 test.sam 转换成 test.bam(保留 header),写出命令并比较两个文件的大小。
参考解答:samtools view -b -h test.sam > test.bam(-b 输出 BAM 格式,-h 包含 header)。结果显示 test.sam 约 3.9M,test.bam 约 660K,BAM 小很多。
问题 3:用 less 分别打开 test.sam 和 test.bam,为什么 BAM 文件是乱码?再用 samtools view 试试。
参考解答:less 只能正常查看文本;BAM 是二进制文件,需要 samtools view test.bam 查看。
问题 4:用 samtools sort 对 test.bam 排序,输出 test_sort.bam,并记录文件大小。
参考解答:samtools sort -o test_sort.bam test.bam。排序前后文件大小基本不变(约 660K)。sort 的常用参数:
| 参数 | 含义 |
|---|---|
-l INT |
输出文件压缩等级,0-9 |
-m INT |
每线程运行时的内存,可用 K/M/G 表示 |
-n |
按 read 名称排序 |
-o FILE |
排序后的输出文件名 |
-T PREFIX |
临时文件前缀 |
-O FORMAT |
输出格式(bam/sam/cram,默认 bam) |
-@ INT |
排序和压缩的线程数 |
问题 5:用 samtools index 给 test_sort.bam 建立索引,写出命令并记录索引文件大小。
参考解答:samtools index test_sort.bam,生成 test_sort.bam.bai(约 4.0K)。
问题 6:用 samtools tview 查看 chr1:160000-160100 区域的比对情况。
参考解答:
samtools tview -p chr1:160000-160100 test_sort.bam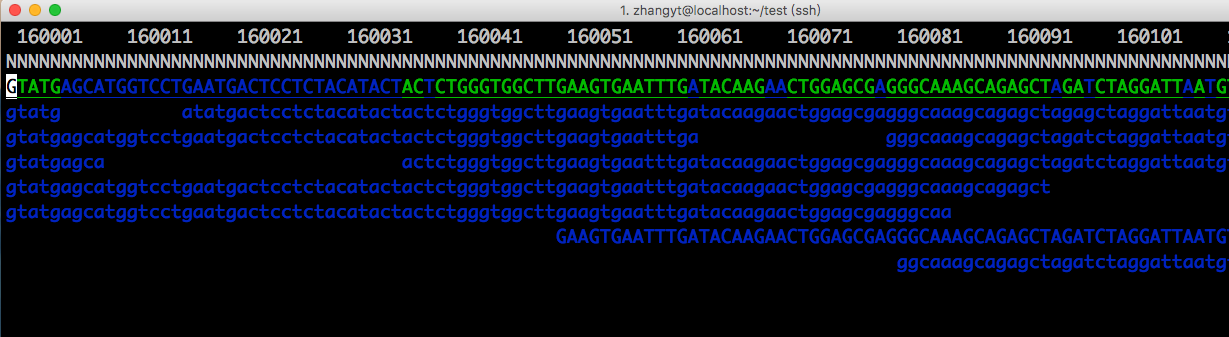
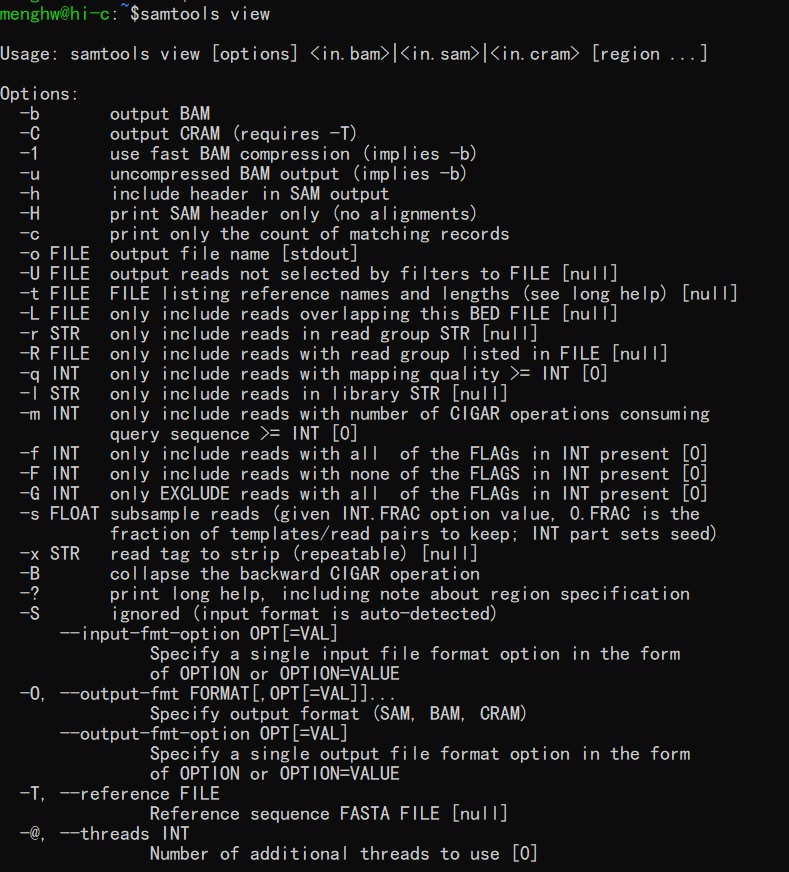
小技巧:想查某个子命令的用法,直接在命令行敲 samtools view 回车就会打印说明( 图 4.62 );完整手册见 samtools manual page(2026 年 10 月核对可访问)。
以后会不断遇到没用过的软件,不必事先学完所有工具。可以从熟悉的操作出发,比较新软件的 input 和 output,弄清它做了什么。刚入门时可以参考他人的教程;有了一定基础后,建议多读官方文档,查清具体用法。
4.7 测序深度与复杂度
能区分数据量、有效信息量和覆盖不足。
覆盖度估算
如果基因组文库没有区域偏好,即测序片段来自各区域的概率相等,就可以估计特定建库方式下,一定 library size 的序列能够覆盖多少基因组区域。
已知目标基因组的长度为\(G\),测序片段长度(read size)为\(S\),library size为\(N\),则某一条read来自于一个长度为\(L\)的基因组区段的概率为\(\frac{L}{G}\)
此时,设随机变量:
\[ D=\text{起始于一个长度为}L\text{的区段的reads数} \](4.6)
则D服从二项分布:
\[ D \sim Binomial(N,\frac{L}{G}) \](4.7)
令\(L=S\),则起始于该长度为S的区段的reads,均覆盖该区段的最后一个碱基,即此时D就是该碱基位置的测序深度
我们知道,对于二项分布,当其实验次数\(N\to \infty\),概率\(P\to 0\)时,二项分布近似于泊松分布,在这里,因为\(S<<G\),则\(P=\frac{S}{G} \to 0\),且\(N\)非常大,可以用泊松分布近似,即:
\[ D \sim \text{Poisson}(\lambda), \quad \lambda=N\frac{S}{G} \](4.8)
因此,我们获得了全基因组各碱基位点的测序深度的概率分布(概率质量分布PMF)估计,如下图(以\(\lambda=40\)为例):
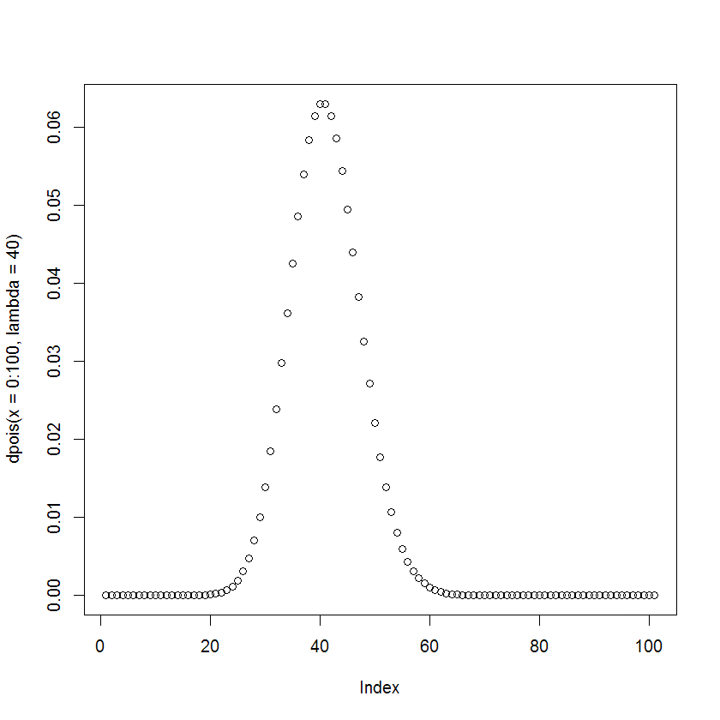
图注:测序深度取整数,图示为概率质量分布。
根据测序深度的概率分布,可以进一步求出深度大于指定阈值 \(d\) 的基因组区域比例:
\[ P(D\ge d) = \sum_{i=d,...,\infty}P(D=i) \](4.9)
不过实际的基因组测序深度分布与泊松分布并不完全一致:由于GC偏好性等因素的影响,“全基因组各区域来源等概率”的假设并不完全成立,实际分布相对于理论分布存在明显的过度离散(overdispersion,即 \(Var(D) > E(D)\))。实测深度分布见 图 4.64 :实测分布(柱)比同均值的泊松分布(线)更“胖”,说明有些区域深度远高于预期、有些远低于预期。以 Bentley 等人 2008 年的整基因组测序数据为例,实测方差约为同均值泊松分布的 2.26 倍7。
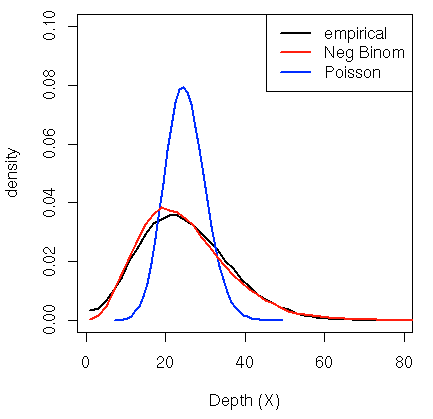
图注:实测分布呈现过度离散。
该图引自 Shen 等人 2008 年提出的 SNP 检测方法中的分析8。
本节内容待补充。
重复 reads 与文库复杂度
避免对所有实验套用同一去重复策略。
duplicate 的来源
duplicate 主要来自建库与测序过程,常见来源有四种,图示见 图 4.65 。
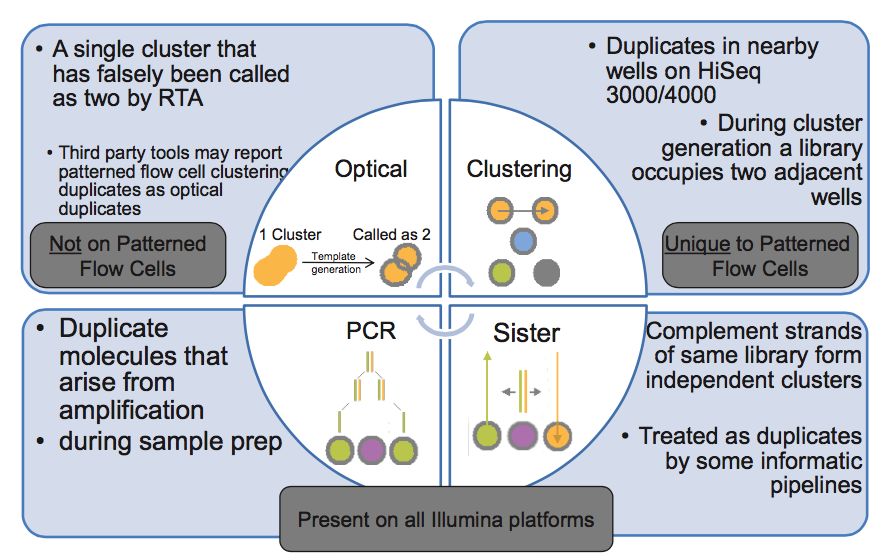
PCR duplicates(PCR重复):PCR 扩增时,同一个 DNA 片段会产生多个相同的拷贝;测序时,这些来源于同一个模板分子的片段会结合到 Flowcell 的不同位置上,生成序列完全相同的 cluster 被测出来,这些相同的序列就是 duplicate。
Cluster duplicates:生成测序 cluster 的时候,某一个 cluster 中的 DNA 序列可能搭到旁边的另一个位点上,又重新长成一个相同的 cluster。使用图案化 Flowcell(patterned flowcell)的机型(如 HiSeq 4000 之后与 NovaSeq 系列)更容易出现这类 duplicate。
Optical duplicates(光学重复):来自同一模板分子的两个片段恰好结合在 Flowcell 上非常接近的位置,形成相邻的两个 cluster;由于它们在成像坐标上紧挨着,可由坐标邻近性识别,因而得名“光学”重复。
Sister duplicates:文库分子的两条互补链同时与 Flowcell 上的引物结合,分别形成各自的 cluster 被测序,产生的这对 reads 完全反向互补;比对到参考基因组时位于正负链的相同位置,在有些分析中也会被认作 duplicate。
duplicate 的产生主要是因为 Illumina 建库过程中一般会使用 PCR 来扩增文库:如果 PCR 扩增轮数过大,同一个模板分子就会产生一模一样的若干条序列(来源见上一小节)。FastQC 的“Sequence Duplication Levels”模块( 图 4.66 )就是用来刻画 duplicate 情况的。
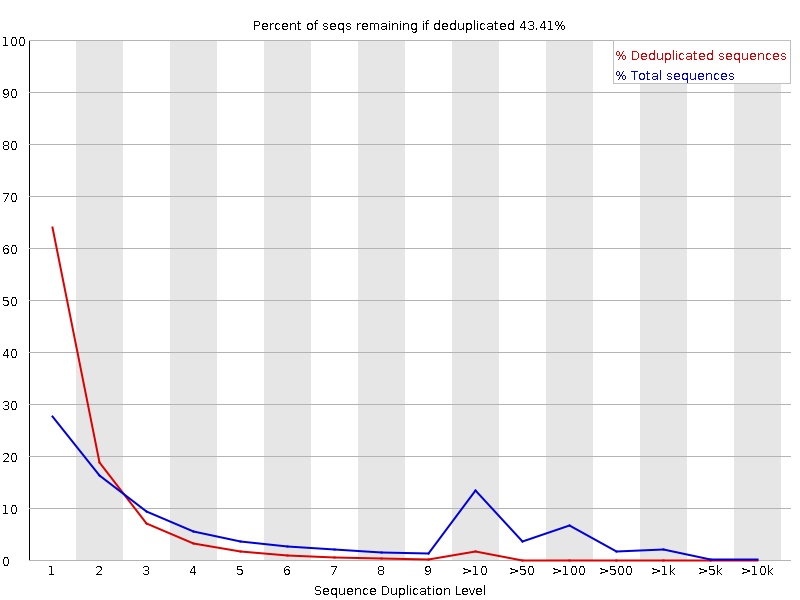
问题 1:图中横坐标、纵坐标分别是什么意思?
参考解答:横坐标代表序列重复水平(一条序列在文件中出现的份数);纵坐标代表各重复水平的序列占全部序列的百分比。
问题 2:红线和蓝线分别代表什么意思?
参考解答:蓝线代表全部序列的重复性分布;红线代表去除 duplicate 之后的分布。
问题 3:图中的 duplicate 是对全部序列统计的吗?还是抽了一部分?为什么这样做?
参考解答:是抽样计算的:旧版 FastQC 取每个文件最前面的 100,000 条序列,新版改为随机抽样(具体数目随版本调整)。样本已经足以代表整个文件的重复性,全量计算反而太慢。
问题 4:如果让你写程序判断一个 fastq 文件中 duplicate 的比例,思路是什么?
参考解答:先按序列排序,再顺序统计相邻相同的序列。伪代码:
# Python风格的伪代码:

# 第1步对序列进行排序
sort the FASTQ file by the sequence, and save as sorted_file;

# 第2步对排序后的序列统计是否为duplicate
total_num = 0
duplication_num = 0

reads_1 = sorted_file.readline()
total_num = total_num + 1
for reads_2 in sorted_file:
    if reads_1 == reads_2:
        duplication_num = duplication_num + 1
    else:
        reads_1 = reads_2
    total_num = total_num + 1
print(total_num)
print(duplication_num)
去除 duplicate:MarkDuplicates 实操
这一步常称为 remove duplication。建库时,PCR 会对片段进行多次扩增;如果来自同一个原始片段的多条测序结果都比对到基因组上,可能影响下游分析。因此,某些情况下需要去除 BAM 中的这类冗余,它通常称为 duplication。
去除duplication的常用工具是 GATK/Picard 的 MarkDuplicates(按坐标排序后运行)。早期常用 samtools rmdup,它对双端数据的处理有已知问题;官方目前保留它仅为向后兼容,明确推荐改用 samtools collate + samtools fixmate + samtools markdup 流程(依据 samtools 官方 NEWS,2026 年 10 月核对)。去重工具本书以 GATK 的 MarkDuplicates 为例。
MarkDuplicates 最常见的用法是只标记、不删除:duplicate 会被打上 FLAG 1024,供后续步骤按需过滤(这是推荐做法,保留的信息最完整):
gatk MarkDuplicates -I ERR188245_chrX.sorted.bam -O ERR188245_chrX.sorted.mkdup.bam -M ERR188245_chrX.metrics --CREATE_INDEX如果确有必要直接删除 duplicate,在同一条命令里加 REMOVE_DUPLICATES=true 即可(注意不要对已标记过的文件重复运行 MarkDuplicates,二次运行会重复计数):
gatk MarkDuplicates REMOVE_DUPLICATES=true -I ERR188245_chrX.sorted.bam -O ERR188245_chrX.sorted.rmdup.bam -M ERR188245_chrX.metrics也可以使用Picard完成同样的工作:
java -jar picard.jar MarkDuplicates I=ERR188245_chrX.sorted.bam O=ERR188245_chrX.sorted.mkdup.bam M=ERR188245_chrX.metrics ASO=coordinate REMOVE_DUPLICATES=true这里介绍了 samtools 最常用的几个命令,其他组学分析中的用法见后续各章。
GATK 去重复实操
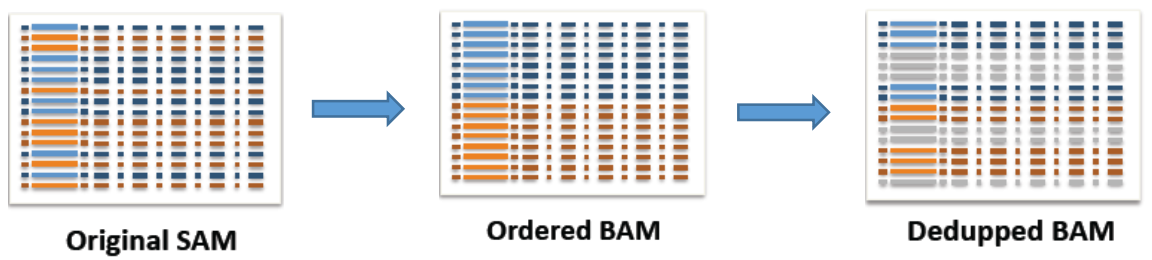
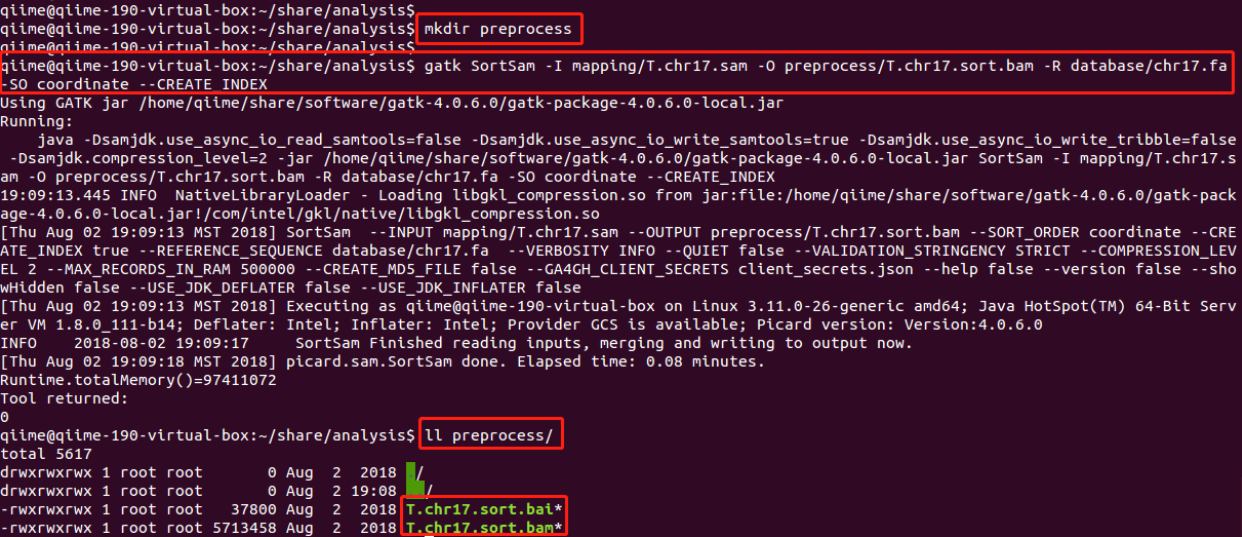
1. 排序(SortSam)
- 对sam文件进行排序并生成bam文件,将sam文件中同一染色体对应的条目按照坐标顺序从小到大进行排序。
- 排序本身用上一节讲过的
samtools sort也可以完成,两种工具都会在头信息里写入SO:coordinate标签说明文件已按坐标排序;GATK 流程推荐统一用 Picard/GATK 的 SortSam,主要是为了与后续 GATK 工具链保持一致。 - 工具文档:Picard/GATK SortSam(2026 年 10 月核对可访问;也可在 GATK.broadinstitute.org 的 Tool Documentation 中查找同名工具)。
如何检查是否成功排序?
samtools view -H /path/to/my.bam这份示例来自一份较早参考版本的文件,部分染色体长度与 hg19/GRCh37 的标准值不同(例如 GRCh37 的 chr1 长度是 249,250,621);查看自己的文件时,以 header 实际内容为准:
@HD     VN:1.0  GO:none SO:coordinate
@SQ     SN:1    LN:247249719
@SQ     SN:2    LN:242951149
@SQ     SN:3    LN:199501827
@SQ     SN:4    LN:191273063
@SQ     SN:5    LN:180857866
@SQ     SN:6    LN:170899992
@SQ     SN:7    LN:158821424
@SQ     SN:8    LN:146274826
@SQ     SN:9    LN:140273252
@SQ     SN:10   LN:135374737
@SQ     SN:11   LN:134452384
@SQ     SN:12   LN:132349534
@SQ     SN:13   LN:114142980
@SQ     SN:14   LN:106368585
@SQ     SN:15   LN:100338915
@SQ     SN:16   LN:88827254
@SQ     SN:17   LN:78774742
@SQ     SN:18   LN:76117153
@SQ     SN:19   LN:63811651
@SQ     SN:20   LN:62435964
@SQ     SN:21   LN:46944323
@SQ     SN:22   LN:49691432
@SQ     SN:X    LN:154913754
@SQ     SN:Y    LN:57772954
@SQ     SN:MT   LN:16571
@SQ     SN:NT_113887    LN:3994
...若随后的比对记录中的contig那一列的顺序与头文件的顺序一致,且在头信息中包含SO:coordinate这个标签,则说明,该文件是排序过的
2. 标记重复(Markduplicates)
- 标记文库中的重复。
- 工具文档:Picard/GATK MarkDuplicates(2026 年 10 月核对可访问)。
gatk MarkDuplicates -I preprocess/T.chr17.sort.bam -O preprocess/T.chr17.markdup.bam -M preprocess/T.chr17.metrics --CREATE_INDEX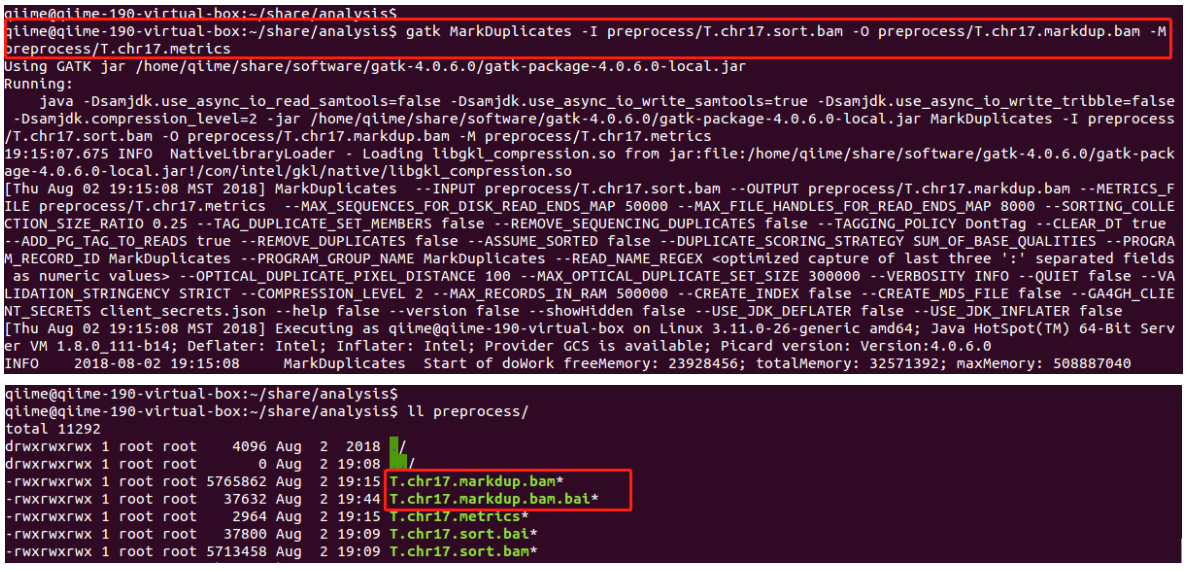
用泊松分布解释 duplicate rate
求解 duplicate rate,相当于回答这样一个问题:
对于已经建好的测序文库,其中有 N 种序列片段,每条片段长度均为 l,每种片段的拷贝数为 \(k_i(i=1,...,N)\),文库大小(library size)为 M,即 \(M=\sum_{i=1}^{N}k_i\)。现在从这个文库中随机抽取 \(m\) 条序列(\(m \ll M\))进行测序,问 duplicate rate 是多少?
先给结论:
\[ duplicate\,rate \approx 1-\frac{\lambda N}{M} \](4.10)
其中 \(\lambda=Ml/G\)。当测序对象 G、片段长度 l 和总文库大小 M 都确定时,\(\lambda/M\) 是常数,此时 duplicate rate 只与原始文库中序列片段的种类数 N 有关,且是负相关——文库复杂度越高(N 越大),duplicate rate 越低。这个结论与直觉一致:文库越复杂,随机抽到同一条片段的概率越小。
完整推导过程较长,放在下面的拓展阅读中,有兴趣的读者可以展开验证。
采用逆向思维:假设 m 条序列中总共有 n 种片段,则 duplicate rate \(d=1-\frac{n}{m}\)。问题转化为“从 M 条中抽 m 条,理论上能抽中多少种片段”。
对于原始文库中的任意一种片段 i,设随机变量
\[ X_i = \left\{ \begin{array}{ll} 1 & 该片段被至少抽中一次 \\ 0 & 该片段未被抽中 \end{array} \right. \](4.11)
(按这种形式设定的随机变量称为示性函数。)则总共被抽中的片段种类数 \(n=\sum_{i=1}^{N}X_i\),见 公式 4.12 。
\[ n=\sum_{i=1}^{N}X_i \](4.12)
我们需要 \(n\) 的期望,由期望的线性性质,见 公式 4.13 :
\[ E(n)=E(\sum_{i=1}^{N}X_i)=\sum_{i=1}^{N}E(X_i) \](4.13)
于是只需求 \(E(X_i)\) 的通式。再设 \(\theta_i=\) 该种片段被抽中的次数,则 \(\theta_i \sim Binomial(m, \frac{k_i}{M})\);由于 \(\frac{k_i}{M} \to 0\)、m 较大,可用泊松分布近似:\(\theta_i \sim \text{Poisson}(\lambda_i)\),其中 \(\lambda_i=\frac{m\cdot k_i}{M}\)。于是
\[ \begin{aligned} &\quad E(X_i) \\ &= P(X_i=1) \\ &= P(\theta_i\ge 1) \\ &= 1-P(\theta_i=0) \\ &= 1-e^{-\lambda_i} \\ &= 1-e^{-m\cdot k_i/M} \end{aligned} \](4.14)
这是已知拷贝数 \(k_i\) 时的结果;若不知道 \(k_i\),可设 \(k_i \sim \text{Poisson}(\lambda)\),其中 \(\lambda=\frac{M\cdot l}{G}\), 公式 4.14 就变成了对 k 求期望,见 公式 4.15 :
\[ E(X_i)=E(1-e^{-m\cdot k_i/M})=\sum_{k=0}^{\infty} (1-e^{-m\cdot k_i/M})\cdot p_k \](4.15)
每种片段被抽中的可能性都满足 公式 4.15 ,所以
\[ E(n)=\sum_{i=1}^{N}E(X_i)=N\cdot E(X_i)=N\cdot \sum_{k=0}^{\infty} (1-e^{-m\cdot k_i/M})\cdot p_k \](4.16)
把 \(d=1-\frac{E(n)}{m}\) 代入展开,见 公式 4.17 :
\[ \begin{aligned} &\quad d \\ &=1-\frac{E(n)}{m} \\ &=1-\frac{N}{m}\sum_{k=0}^{\infty} (1-e^{-m\cdot k_i/M})\cdot p_k \\ &=1-\frac{N}{m}\sum_{k=0}^{\infty} (1-e^{-m\cdot k_i/M})\cdot \frac{\lambda^k}{k!}e^{-\lambda} \\ &=1-\frac{N}{m}+\frac{Ne^{-\lambda}}{m}\sum_{k=0}^{\infty} \frac{1}{k!}(\lambda e^{-m/M})^k \end{aligned} \](4.17)
公式 4.17 中的 \(\sum_{k=0}^{\infty} \frac{1}{k!}(\lambda e^{-m/M})^k\)(其中 \(\lambda e^{-m/M} \to 0\))正是指数函数 \(e^x\) 的泰勒展开式,见 公式 4.18 :
\[ e^x=\sum_{n=0}^{\infty} \frac{x^n}{n!} \](4.18)
因此可以得到
\[ \begin{aligned} &\quad d \\ &=1-\frac{N}{m}+\frac{Ne^{-\lambda}}{m}\sum_{k=0}^{\infty} \frac{1}{k!}(\lambda e^{-m/M})^k \\ &\approx1-\frac{N}{m}+\frac{Ne^{-\lambda}}{m}\cdot e^{\lambda e^{-m/M}} \\ &=1-\frac{N}{m}\left(1-e^{-\lambda}\cdot e^{\lambda e^{-m/M}}\right) \\ &=1-\frac{N}{m}\left(1-e^{\lambda (e^{-m/M}-1)}\right) \end{aligned} \](4.19)
由于 \(m \ll M\),则 \(-m/M \to 0^-\),且 \(e^x\) 在 \(x=0\) 处的一阶泰勒展开为 \(e^x=1+x+o(x)\),故 \(e^{-m/M} \approx 1-m/M\)。 公式 4.19 可以化简为:
\[ \begin{aligned} &\quad d \\ &\approx 1-\frac{N}{m}(1-e^{-\lambda m/M}) \\ &\approx 1-\frac{N}{m}[1-(1-\lambda m/M)] \\ &=1-\frac{N}{m}\frac{\lambda m}{M} \\ &=1-\frac{\lambda N}{M} \end{aligned} \](4.20)
故最终得到
\[ d\approx 1-\frac{\lambda N}{M} \](4.21)
PCR bias 的影响
DNA 在打断等实验步骤中会发生损伤与化学修饰(例如脱氨),带来假的变异信号;PCR 过程会放大这些信号,使最后的检测结果混入假阳性。
PCR 反应过程本身也会引入新的碱基错误,且发生在前几轮的 PCR 错误会在后续扩增中被放大。
对真实的变异,PCR 可能对包含某个等位基因的模板扩增更剧烈(PCR bias)。如果反应体系对含 reference allele 的模板扩增偏向强烈,变异碱基的支持 reads 会变少,从而导致假阴性。
图注:上图中的 6 对同端点 reads 设定为同一个原始片段的 PCR 拷贝;下图标记并过滤重复后保留 1 份。两图采用 IGV 风格,使用相同坐标与覆盖度刻度。
图中成组的 reads 左右端点一致,提供了识别重复的线索;这些拷贝增加了测序条数,却没有增加独立原始片段数。实际数据中,仅凭堆叠外观不能确定重复来自 PCR,还需要结合建库方式和重复标记结果。Picard 的 MarkDuplicates 默认在 BAM 中标记重复;图中下半部分展示的是随后过滤这些标记后的视图。9
先自己想一想,再看参考解答(后续章节还会专题讨论)。
参考解答:
- DNA-Seq 中随机打断建库的样本需要考虑 deduplication;酶切建库的样本一般不需要考虑这个问题;
- RNA-Seq 一般不考虑 remove duplication(有专门论文讨论过这个问题);
- 单细胞测序建库过程中会添加 random barcode(UMI),必须结合 barcode 考虑 duplication。
4.8 IGV 可视化查看比对结果
确认数据足以支持目标分析,并发现流程中的明显错误。
IGV 工具的介绍
samtools 的 flagstat 或 Qualimap 2 能告诉我们总体比对情况。如果要查看染色体上的某个区域或编码区的比对细节,可以使用基因组浏览器 IGV(Integrative Genomics Viewer)。它把 BAM 中每条 read 的位置、正负链、错配和插入缺失画在基因组坐标上,既可检查比对问题,也可准备组会或论文配图。
IGV 的下载与安装
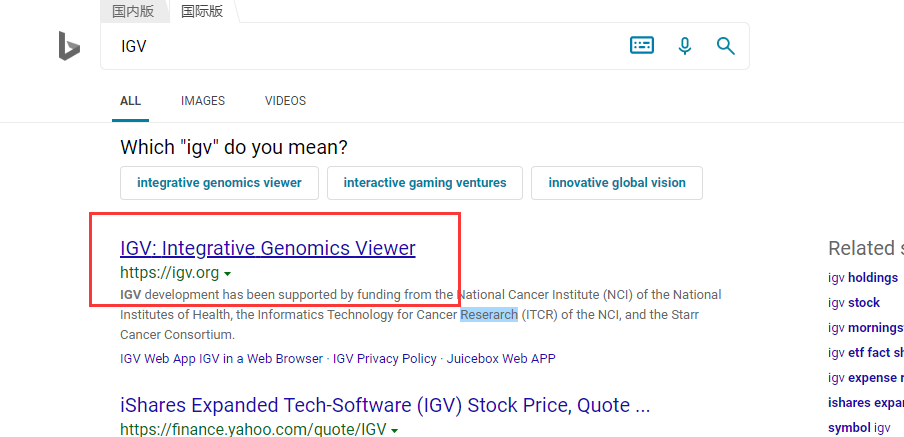
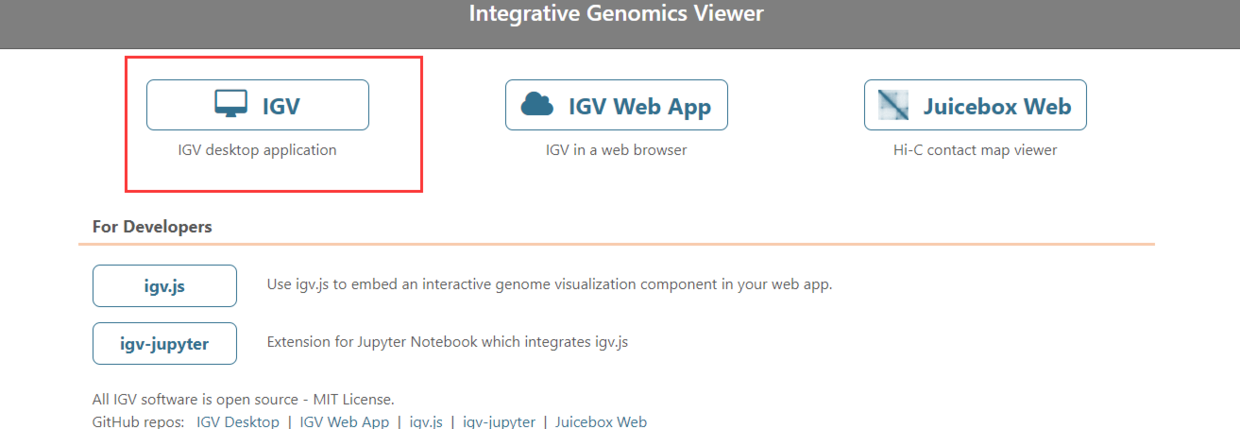
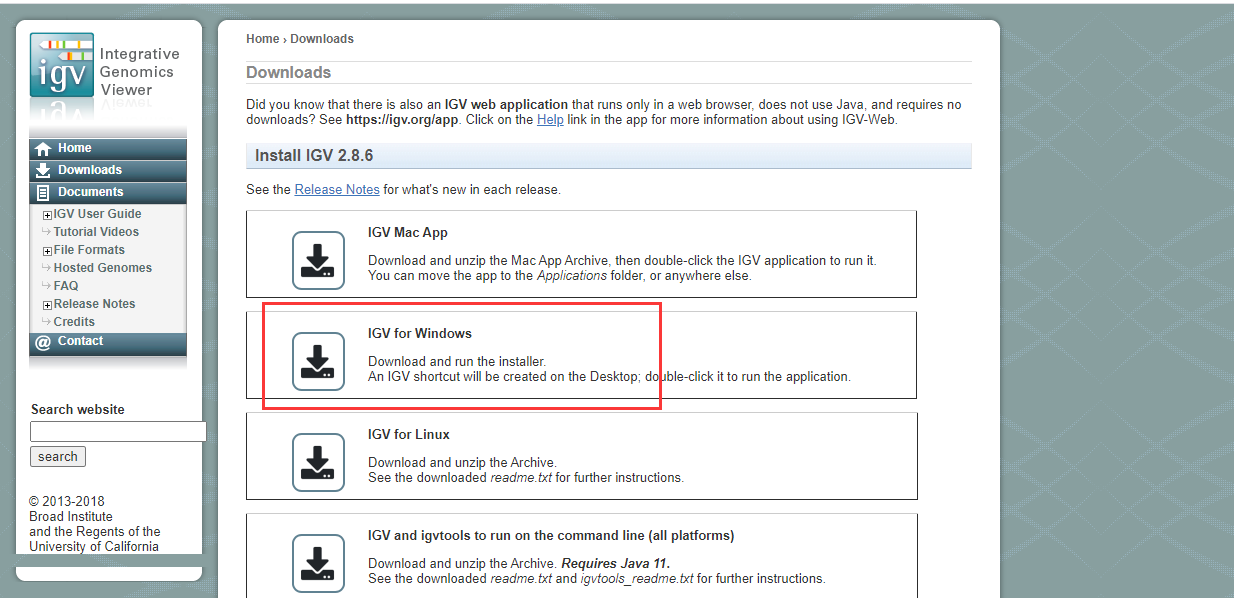
在搜索引擎中搜索 IGV 并进入官网( 图 4.71 ;官网地址 https://igv.org,2026 年 10 月核对可访问)。这里使用桌面版( 图 4.72 ),按提示安装即可( 图 4.73 )。以下截图摄于 2019 年前后,官网界面可能已有调整,但仍可按相同思路找到桌面版安装包。
使用 IGV 载入 BAM 文件
IGV 载入 BAM 的前提是已排序、已建索引(4.6.4 已经做过;如果还没有,先补上):
#如果还没对序列排序,记得先排序
samtools sort -@ 2 -o ERR188245_chrX.sorted.bam ERR188245_chrX.bam

#排好序之后,对bam文件建立index
samtools index -@ 2 ERR188245_chrX.sorted.bam ERR188245_chrX.sorted.bai
打开安装好的 IGV( 图 4.74 ),选择 File –> Load from File 加载想要查看的 bam 文件( 图 4.75 )。导入成功后选择染色体——我们的测序只测了 chrX,故而选择 chrX( 图 4.76 、 图 4.77 )。
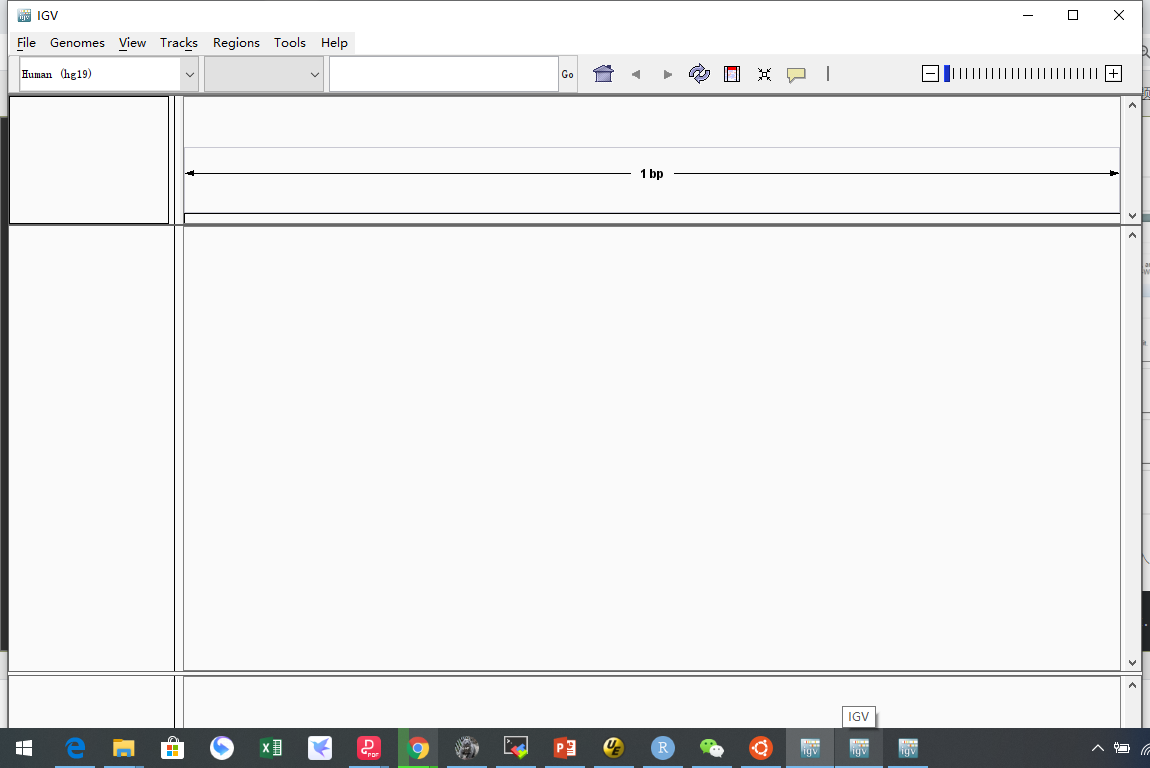
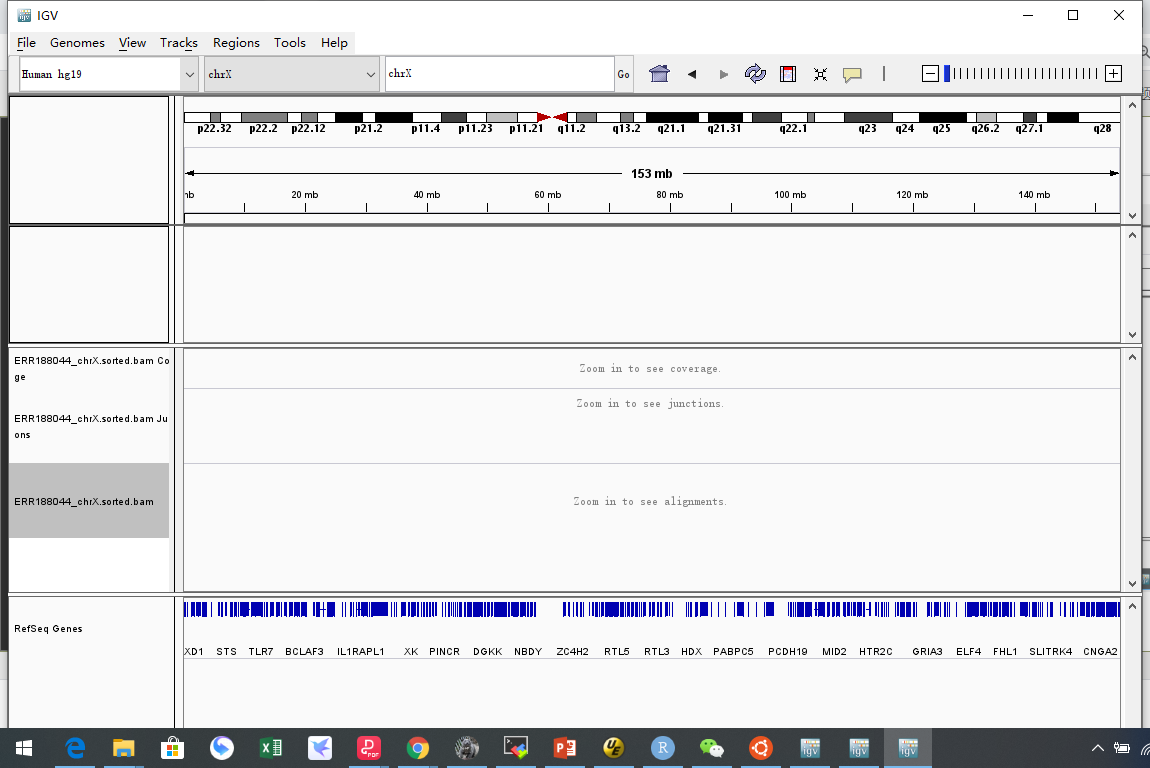
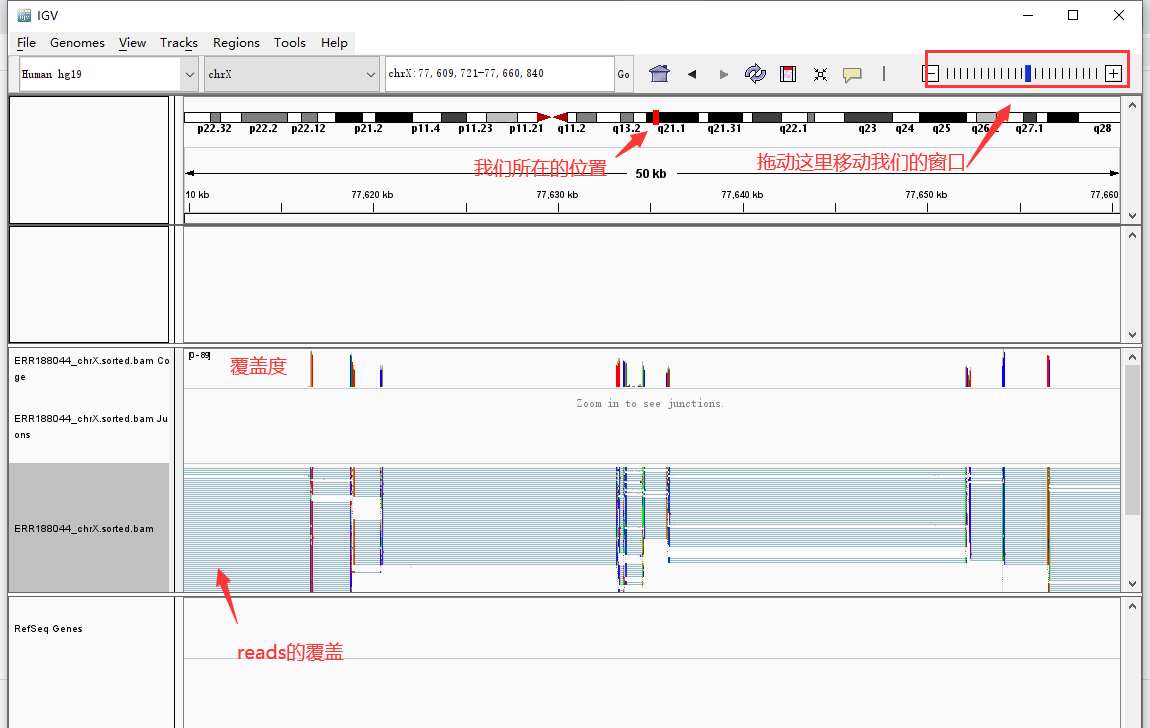
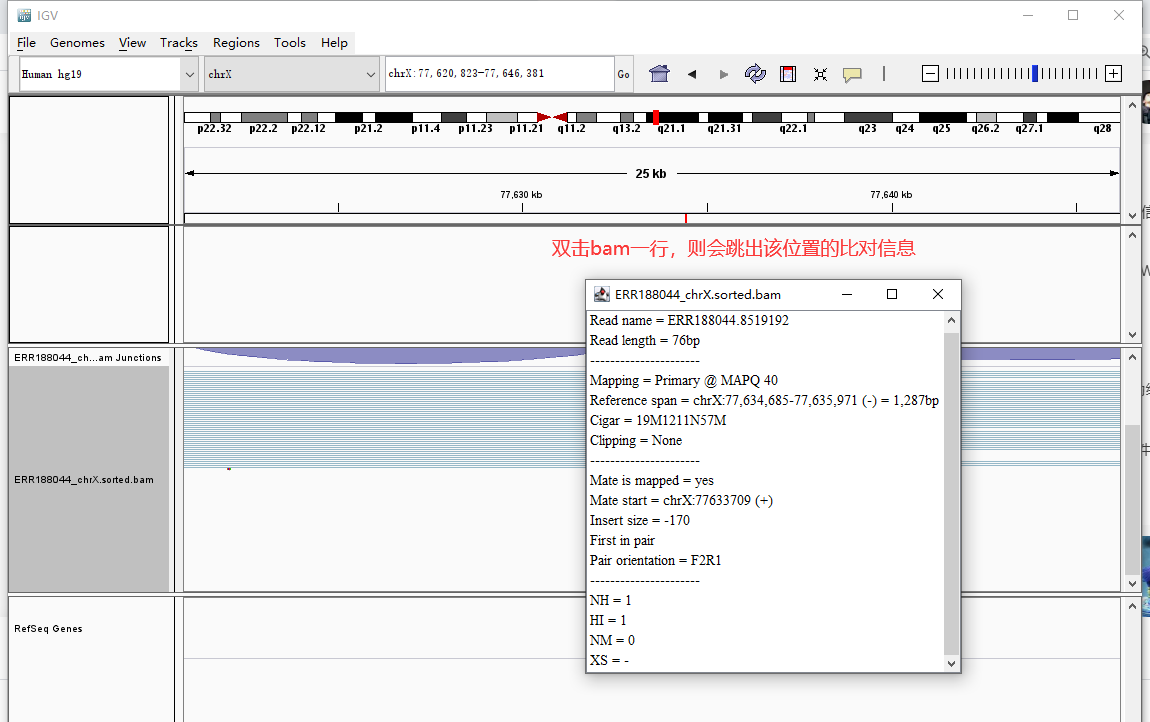
不断双击想查看的位置,即可放大到 reads 级视图( 图 4.78 ):每条 read 一行,与参考一致的碱基不显示颜色,错配会标出彩色字母,插入缺失也有对应标记。
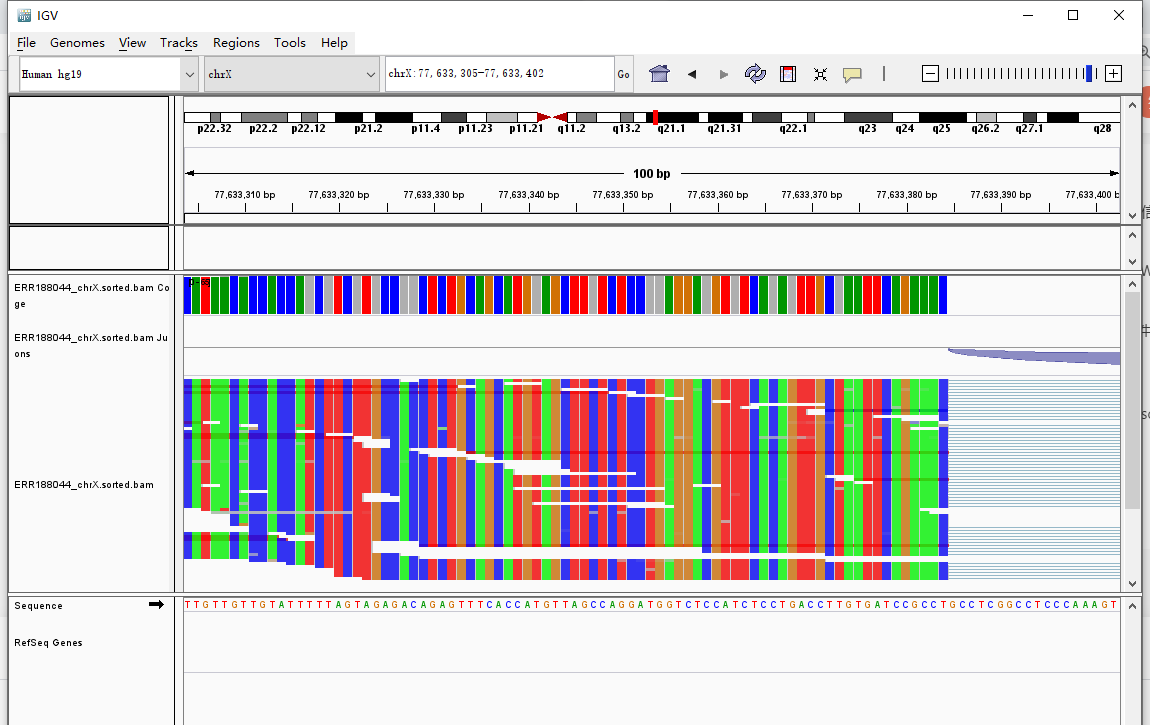
使用 IGV 进行截图
检查中发现值得保存的画面,可以直接在 IGV 里导出图片:菜单选择 File –> Save PNG Image…(部分版本在视图右键菜单中也有 Save Image),把当前视图保存为 PNG。几个实用建议:
- 导出前先用上方的缩放控件调好视野:组会汇报适合基因级视图(含基因模型 track),核查具体 read 适合 reads 级视图;
- 截图里保留坐标轴与基因 track,让读者知道位置;多个样本比较时把各样本 BAM 依次载入、对齐同一坐标再导出;
- PNG 适合日常记录与幻灯片;如期刊要求矢量图,可选 Save SVG Image。
使用 IGV 查看局部比对时,可以同时检查 reads 与参考的位置关系,并保存需要展示的结果。
4.9 项目实战:下载公共数据进行分析
能将论文中的数据编号转化为清晰的分析输入。
本节内容待补充。
NCBI Insights(2021-04-30):Assembly 数据库装配数突破 100 万(https://ncbiinsights.ncbi.nlm.nih.gov/2021/04/30/assembly-surpasses-one-million/);NCBI 帮助文档记载原核基因组归档已超 200 万(https://support.nlm.nih.gov/kbArticle/?pn=KA-03578)。均于 2026 年 10 月核对可访问。↩︎
Hjelmen CE. Genome size and chromosome number are critical metrics for accurate genome assembly assessment in Eukaryota. Genetics, 2024. PubMed 38869251。↩︎
Heng Li、Richard Durbin. Fast and accurate short read alignment with Burrows-Wheeler transform. Bioinformatics, 2009.↩︎
Ben Langmead、Cole Trapnell、Mihai Pop、Steven L Salzberg. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biology, 2009.↩︎
Mohammed Alser、Jeremy Rotman、Dhrithi Deshpande、Kayla Taylor、Sriram P Chockalingam、Onur Mutlu. Technology dictates algorithms: recent developments in read alignment. Genome Biology, 2020.↩︎
依据 SAM 规范的官方示例绘制。↩︎
D R Bentley 等. Accurate whole human genome sequencing using reversible terminator chemistry. Nature, 2008. 实测方差约为泊松分布 2.26 倍的结论出自该文。↩︎
Yufeng Shen 等. A SNP discovery method to assess variant allele probability from next-generation resequencing data. Genome Research, 2008.(原稿将出处误记为 Nature 2008,已按论文实际发表信息更正。)↩︎
Broad Institute. MarkDuplicates (Picard) 官方说明:识别并标记 PCR 或测序过程产生的重复,默认标记而非删除。本图为说明原理构造的 read pairs,不是实际 IGV 截图。↩︎