3 测序技术基础
本章提要
本章围绕测序技术和原始数据展开:先理解不同实验究竟测到了什么,再沿技术发展认识 Sanger 测序与高通量测序、以 Illumina 为代表的第二代测序、MGI,以及 PacBio 与 Nanopore 长读长技术。随后把高通量文库构建与 FASTA/FASTQ 数据存储、质量编码联系起来,学习逐模块阅读 FastQC 报告,掌握去接头、质量裁剪与 seqkit 等常见数据清理操作。通过这些内容,希望你能说明原始数据的来源,读懂质量信息,并解释每一次数据处理的目的。
3.1 不同测序实验究竟测到了什么
不同实验产生的 reads,代表的生物学测量并不相同。
拿到一份测序数据时,最先要回答的问题不是“用什么软件分析”,而是“这份样本里究竟测到了什么分子”。测序仪输出的 reads 形式上都一样——一串 A、T、C、G 和对应的质量值——但它们背后的生物学对象可以完全不同:有的测的是基因组 DNA,有的测的是逆转录后的 mRNA,有的测的是被蛋白质“拉下来”的 DNA 片段,还有的只测外显子区域。如果不清楚 reads 的来源,后面的每一步分析都可能答非所问。
理解一份测序数据,可以从三个问题入手:样本是什么(组织、细胞还是单个细胞);文库怎么建(片段如何打断、是否逆转录、是否富集特定区域);测的是哪一段(基因组全序列、外显子、转录本还是结合位点片段)。下表列出本书后续章节会详细分析的常见实验类型。
| 实验类型 | 测到的分子 | 回答的生物学问题 | 详见 |
|---|---|---|---|
| 全基因组测序(WGS) | 基因组 DNA 片段 | 群体与个体变异、基因组组装 | 第 7 章 |
| 全外显子测序(WES) | 富集到的外显子区域 DNA | 罕见病与癌症中的编码区变异 | 第 7 章 |
| 转录组测序(RNA-seq) | mRNA 逆转录成的 cDNA | 基因表达水平与差异表达 | 第 5 章 |
| 单细胞转录组测序 | 单个细胞内的 mRNA | 细胞类型、状态与发育轨迹 | 第 9 章 |
| ChIP-seq | 蛋白质结合的 DNA 片段 | 转录因子或组蛋白的结合位置 | 第 6 章 |
| ATAC-seq | 开放染色质区域的 DNA | 染色质可及性变化 | 第 6 章 |
| 长读长测序 | 长片段 DNA 或 RNA | 结构变异、复杂区域、转录本异构体 | 本章 3.5 节 |
同一个样本采用不同实验,得到的 reads 含义会完全不同;建库方案也会改变数据的偏向和噪声特性。接下来,我们先看这些 reads 是怎样测出来的,再介绍文库构建、数据存储格式与质量评估。
3.2 从 Sanger 到高通量测序
理解每一代测序技术解决了什么问题、又付出了什么代价。
Sanger 测序:双脱氧链终止法
Sanger 法即双脱氧链终止法,是第一代测序技术的代表。它利用 DNA 复制原理,在反应中加入双脱氧核苷三磷酸(ddNTP):ddNTP 缺少 3′ 羟基,一旦掺入延伸中的链,反应就无法继续,DNA 链便在对应位置终止。四种 ddNTP 分别反应(或以荧光标记区分)后,依据不同长度的终止片段判断每个位置的碱基类型。
Sanger 测序的读长可达 500—1000 bp,单条序列的准确率很高,至今仍是验证少量序列的“金标准”。它的通量较低,因为每条序列都需要独立反应,再通过电泳分离(早期为凝胶电泳,后来是毛细管电泳),一次能并行处理的序列数量有限。实验室常用它验证质粒、PCR 产物或克隆单条序列;但若用它测一个人类基因组,就需要极其大量的独立反应,成本无法承受。
第二代测序的兴起
第二代测序(Next Generation Sequencing,NGS)的核心突破不是把单条序列读得更准,而是并行化:把亿万条模板片段固定在芯片上同时测序,用“空间换通量”。发展过程中出现过几条技术路线:Roche 454 采用焦磷酸测序,Ion Torrent 用半导体芯片检测合成时释放的氢离子,而 Illumina(源于 Solexa 公司 2006 年发布的 Genome Analyzer)采用荧光可逆终止化学,凭借通量和成本的平衡最终占据主导。我们接触到的很多生物信息学技术,比如 RNA-seq、ChIP-seq、Hi-C 等,都建立在 NGS 之上。
第二代测序的特点是高通量、单碱基成本低,但读长短(通常 50—300 bp)。本章 3.3 节以 Illumina 为例讲解原理,其他短读长平台的思路相近。
机型与通量:随时代变化
分析数据前需要知道它出自什么仪器。Illumina 的机型差不多每三到五年更新一代,单次运行通量从 GA 时代的几十 Gb 增长到如今 NovaSeq X Plus 的 16 Tb——二十年提高了约三个数量级,而读长始终停留在几百 bp。下表按年代列出各时代的代表机型与规格页通量(均为 2×150 等最长读长下的上限口径,实际产出随试剂版本与样本质量浮动)。
| 时代 | 代表机型 | 单次运行通量(规格口径) |
|---|---|---|
| GA 时代(2006—2010) | Genome Analyzer IIx | ~85—95 Gb |
| HiSeq 时代(2011—2017) | HiSeq 2000/2500 | 0.2—1 Tb |
| HiSeq 3000/4000 | 0.75—1.5 Tb | |
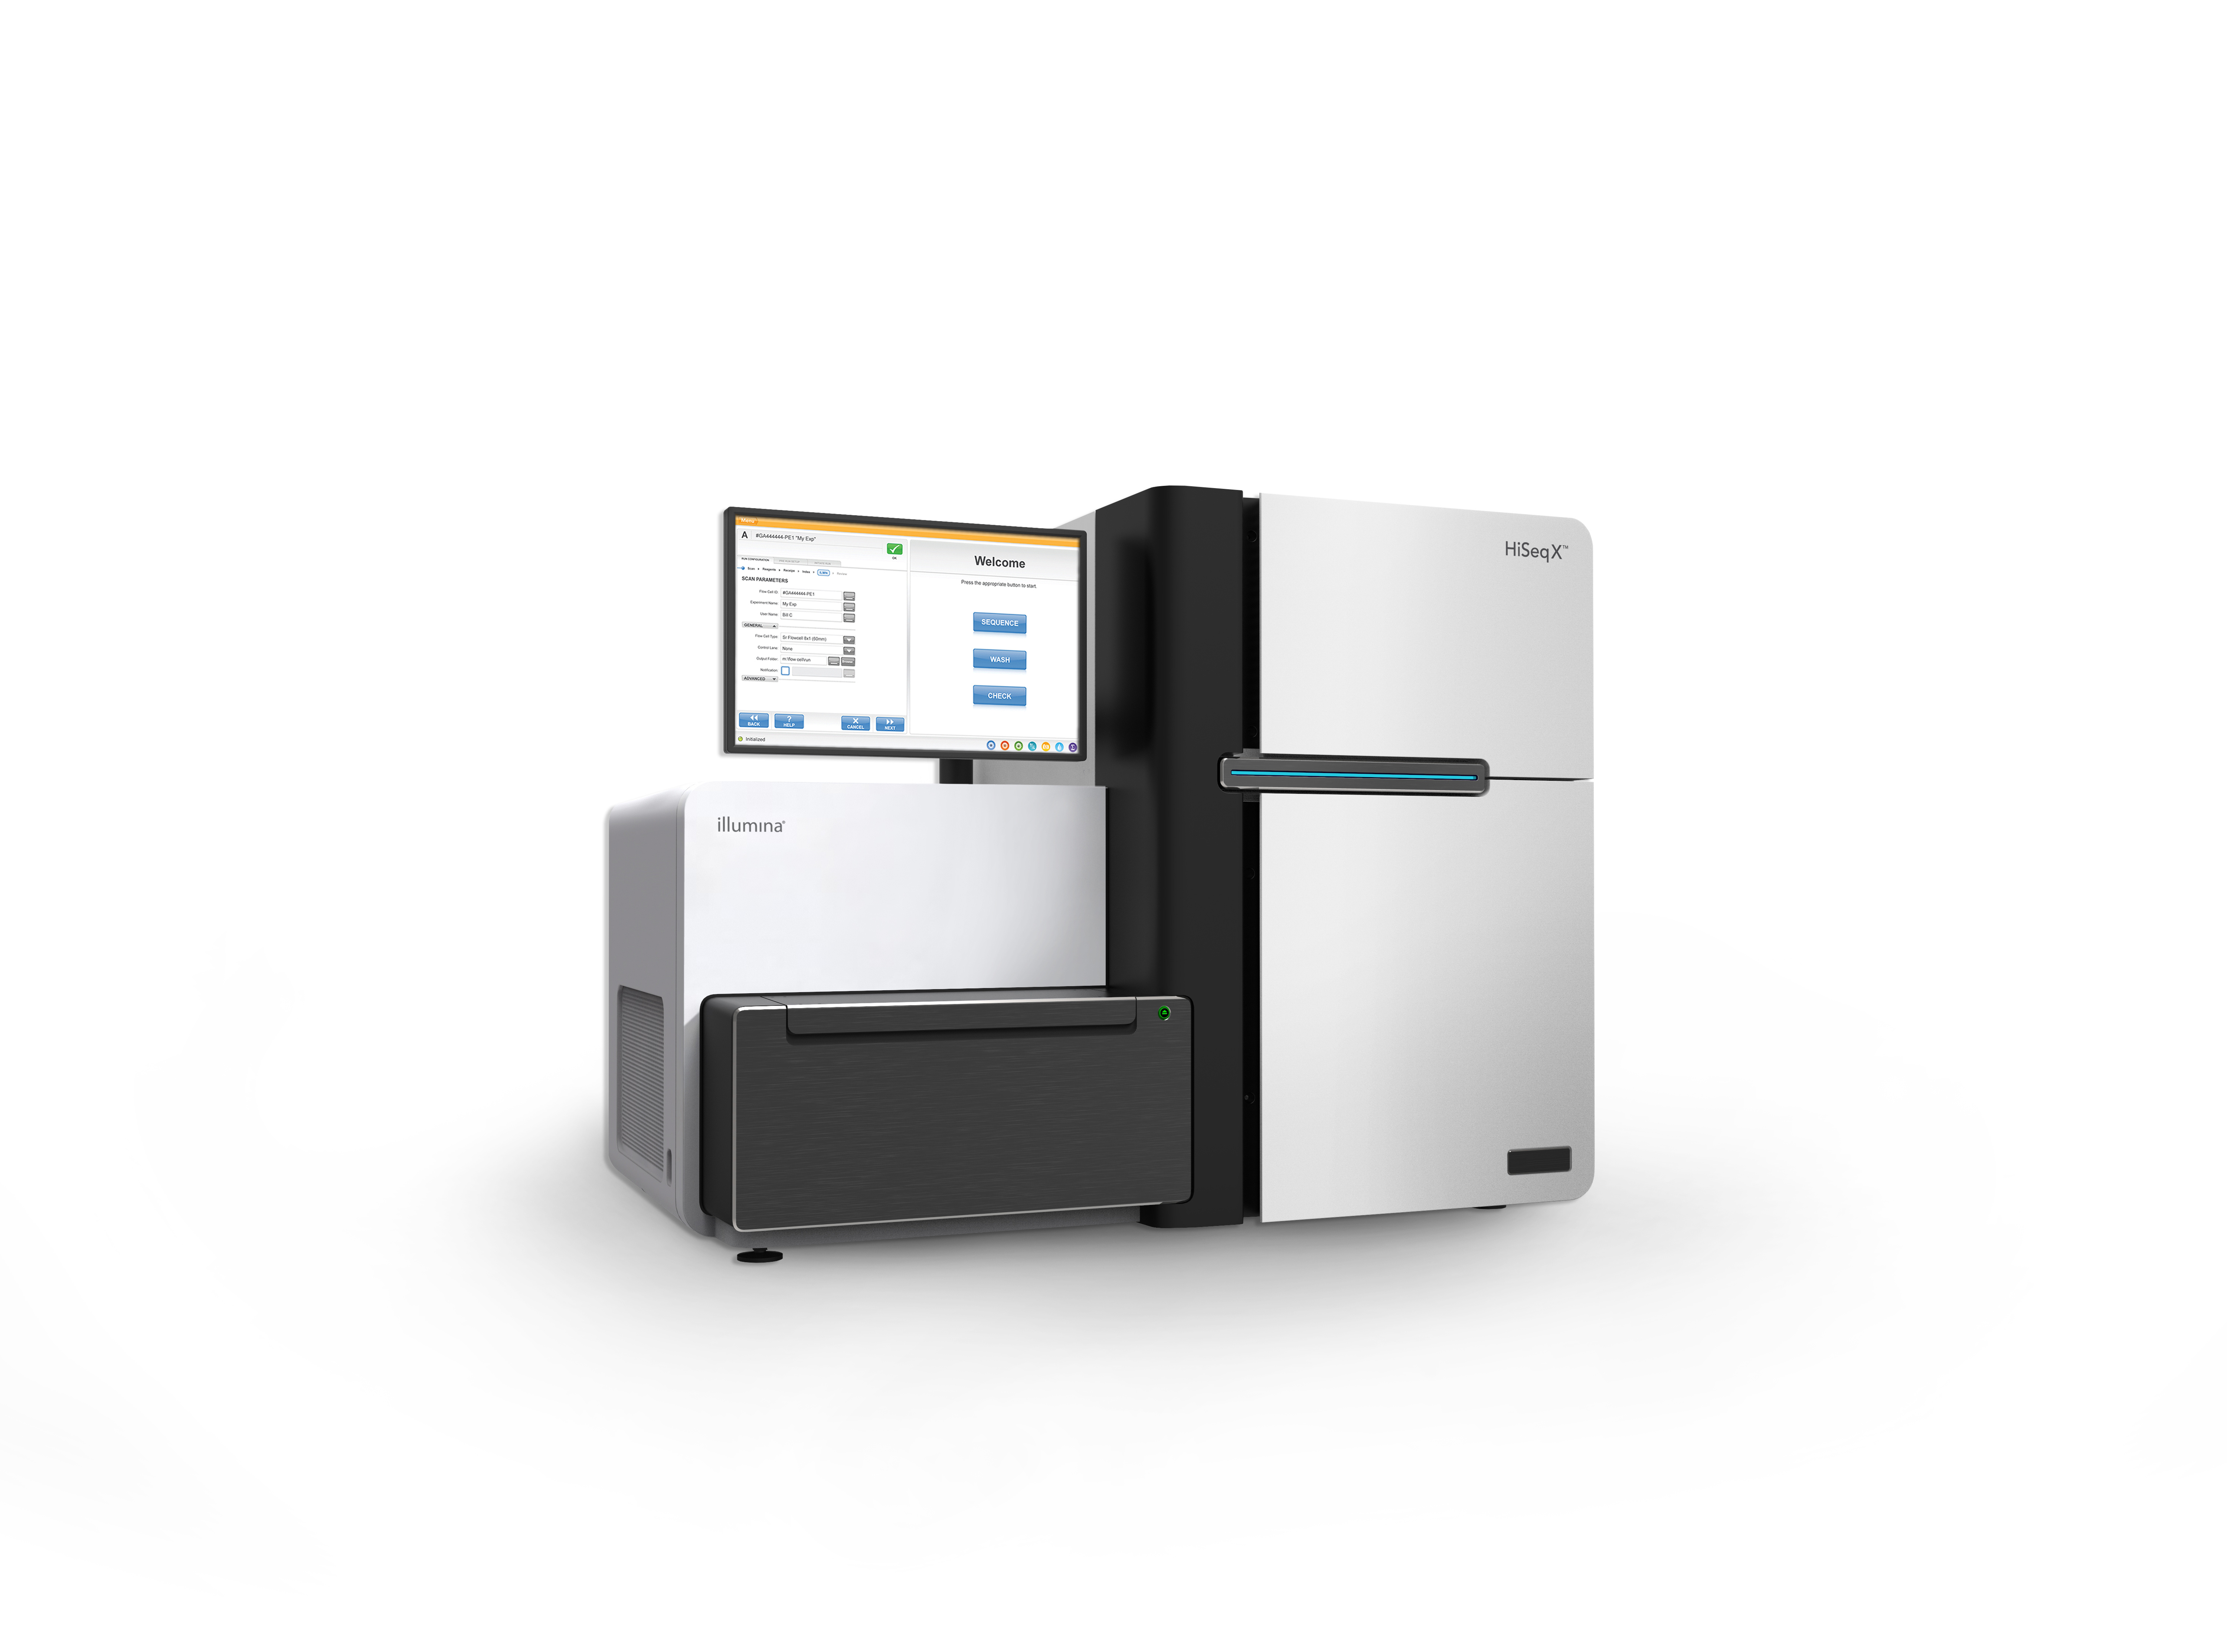
| HiSeq X Five/X Ten | 1.6—1.8 Tb | |
| NovaSeq 时代(2017—2022) | NovaSeq 6000(双 S4 流动槽) | ~5—6 Tb |
| NextSeq 550、MiSeq | 15—120 Gb | |
| NovaSeq X 时代(2023 至今) | NovaSeq X / X Plus | ~8 Tb / 16 Tb |
| NextSeq 2000 | 最高 540 Gb |
专利到期与国产测序仪。 Illumina 边合成边测序的核心化学专利(如可逆终止子专利 US 7,541,444 及其同族)在 2022—2024 年间陆续到期。此后国内出现了一批采用 SBS/可逆末端终止化学路线的测序仪企业:真迈生物(SURFSeq 系列,GenoLab M、FASTASeq 300 等机型)、赛陆医疗(Salus Pro,4—600 Gb/run,超高通量的 EVO 可达 1.8 Tb)和赛纳生物(荧光发生 SBS 加纠错编码)等。它们的共同点是数据格式与生信流程和 Illumina 高度兼容,但仪器、芯片与试剂均为自研,与 Illumina 设备互不通用;华大智造则走自有的 DNBSEQ 体系(见 3.4 节),不属于 SBS 兼容路线。这些机型多在 2024—2025 年取得医疗器械注册证并快速进入临床与科研市场。
上表数字是各时代规格页的宣传口径;同一机型换用不同试剂版本,通量区间也会变化。分析具体数据前,应以测序公司或平台提供的实际参数(读长、通量、Q30 比例)为准,不要凭印象套用其他机型的数字。
3.3 Illumina 测序原理
理解接头、索引、双端测序和测序错误如何影响数据。
一些常用基本概念的介绍
- flowcell(流动槽)是测序反应发生的位置;lane 数目随仪器和流动槽型号变化
- lane(泳道)是流动槽内的反应区域,具体结构取决于平台
- tile 每一次测序荧光扫描的最小单位
- read 指一次读取获得的序列,复数为 reads
- bp base pair 碱基对,用于衡量序列长度
- 双端测序 指从同一插入片段的两端分别读取,例如一个 500 bp 的插入片段两端各读 150 bp
- 未读取区间 在上述例子中,中间还有约 200 bp 未被两端的 reads 覆盖;这段区间不称为 junction。RNA 比对中的 splice junction 通常指剪接连接位点
- adapter 建库时连接到片段两端的人工序列,包含测序引物结合位点等功能元件
- primer PCR 或测序反应中的引物
桥式 PCR 与簇生成
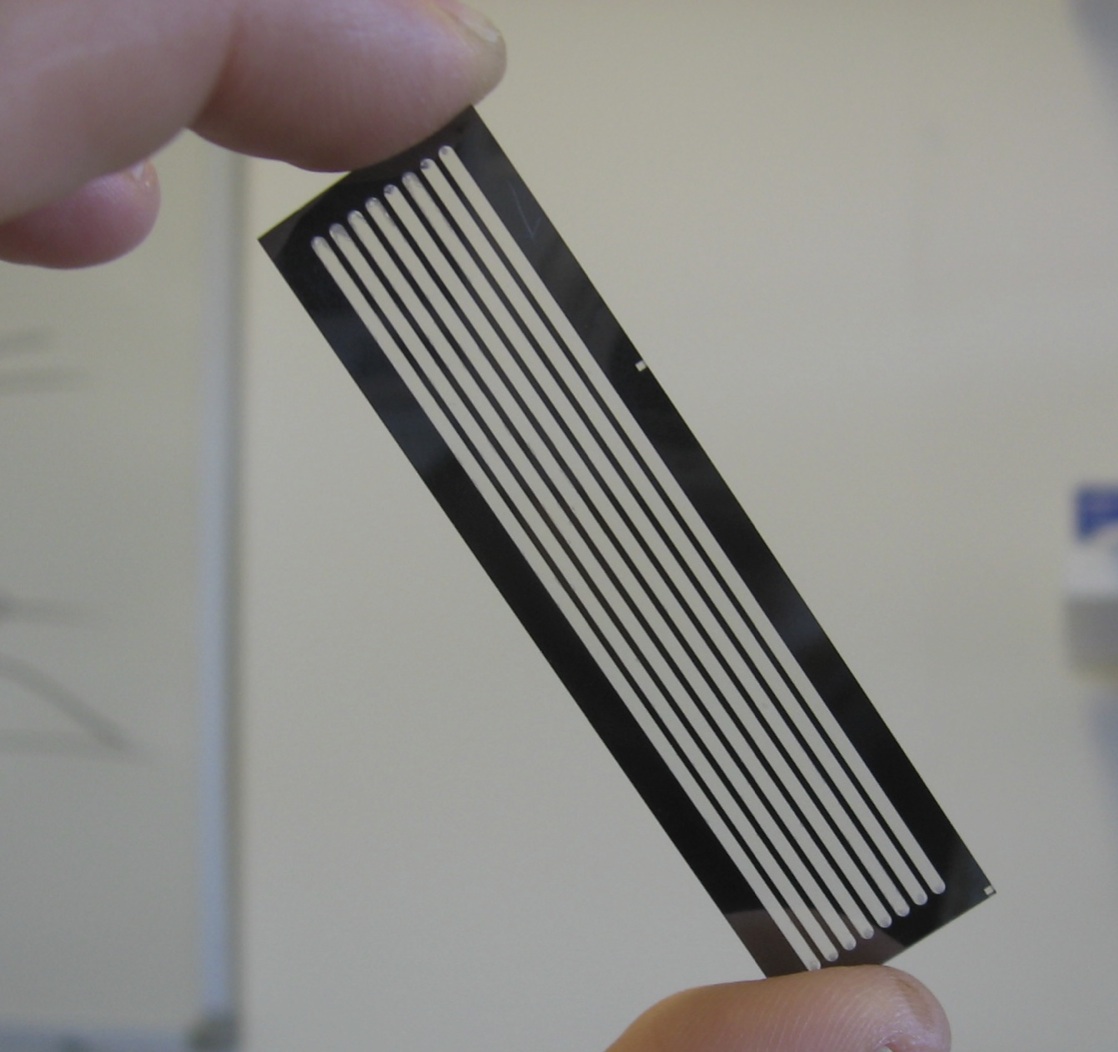
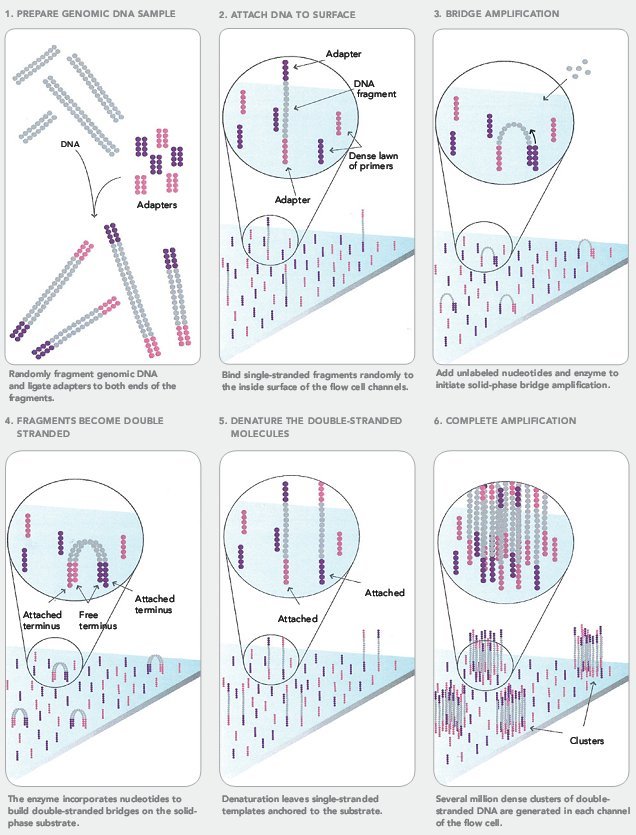
单分子发出的荧光太弱,无法直接检测,因此测序前要先在流动槽表面把每个模板扩增成“簇”。将调整到合适浓度的 DNA 文库加入 flowcell,文库片段末端的 adapter 与流动槽表面固定的寡核苷酸互补配对,通过共价连接固定。随后开始桥式 PCR:第一轮扩增把单链补成双链;加入 NaOH 碱性溶液变性、洗脱——由于最初的连接是共价键,模板不会被洗掉;再加入缓冲液,序列自由端与表面相邻的寡核苷酸配对,弯成“桥”状进行一轮扩增。如此循环,每个原始分子就扩增成一个由完全相同序列组成的簇(cluster)。
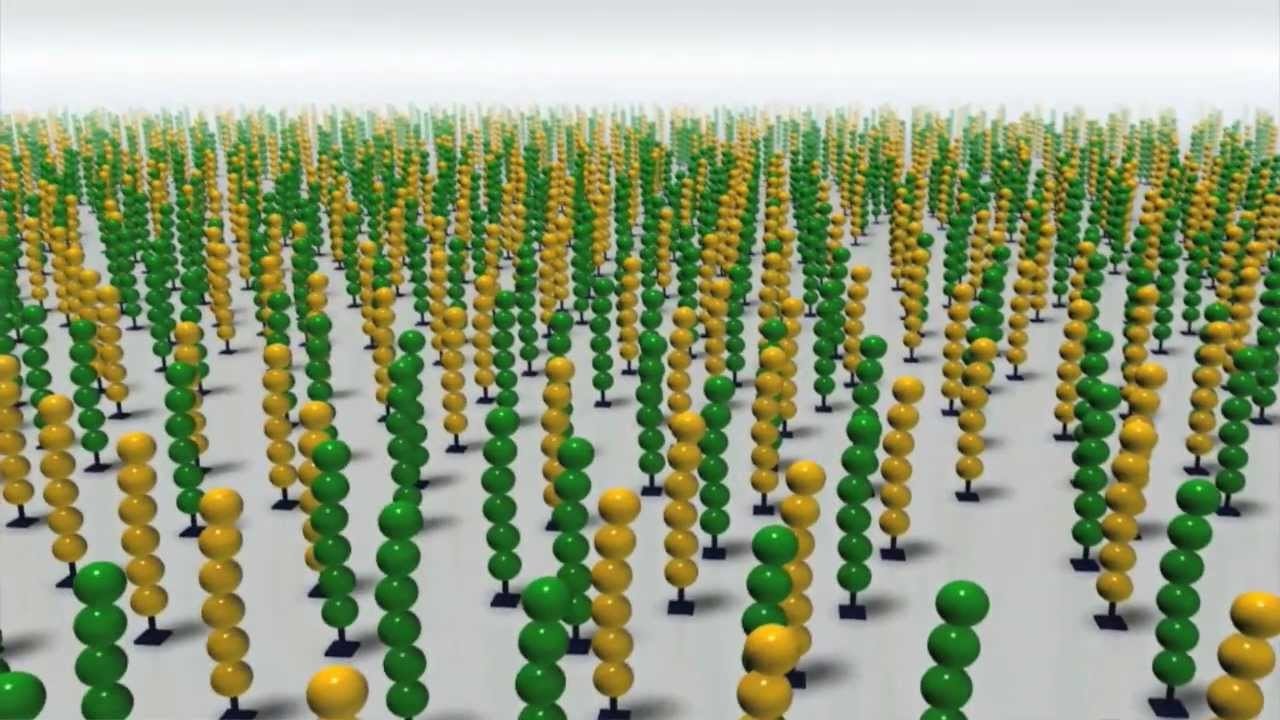
这样,整个 flowcell 上就形成了一个个彼此独立的 cluster。测序时,每个 cluster 作为一个“单分子”参与信号读取,二代测序便可以同时读取大量序列。
边合成边测序(SBS)
测序时,聚合酶沿模板延伸引物,加入带有可逆终止基团的核苷酸,使一轮反应只延伸一个碱基。仪器根据荧光信号判断本轮加入的碱基,再解除终止并进入下一轮。不同代际平台的荧光编码和化学体系有所不同,不能都理解为四种碱基各自发出一种颜色。
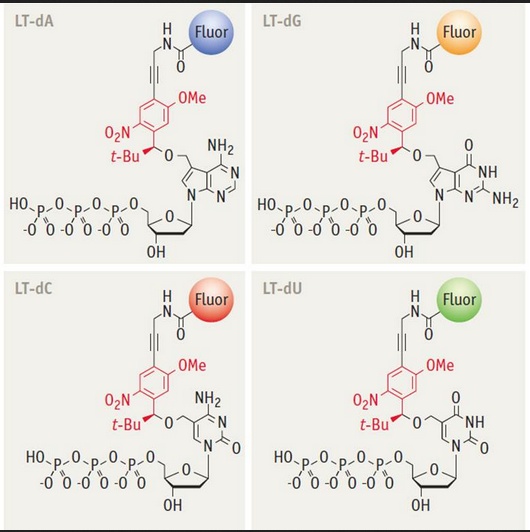
Illumina 边合成边测序(Sequencing by Synthesis,SBS)的关键是可逆终止子核苷酸:先暂时封闭核苷酸的 3′ 羟基,让链在掺入一个碱基后停下来;读出信号后再解除封闭,恢复下一轮延伸所需的 3′-OH。早期四通道体系还在碱基上连接可切除的荧光染料。下面先看测序过程,本节末的拓展阅读框再用一个早期化学实例解释这两处修饰。
以早期四通道体系为例,每轮循环包含三步:聚合酶掺入一个带荧光标记的可逆终止子,仪器扫描 cluster 并记录信号,随后去除染料并解除 3′ 封闭,再进入下一轮。一个 cluster 中的模板拷贝理想情况下同步延伸,因此这一轮的信号主要对应同一种碱基;仪器逐 tile 扫描,把连续多轮信号转换为碱基序列。染料编码与脱保护条件取决于所用化学体系,不能把一个历史实例的试剂配方套到所有平台。
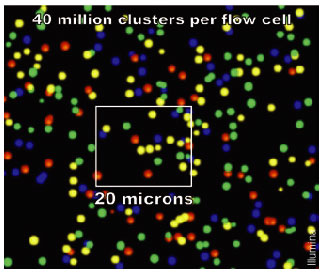
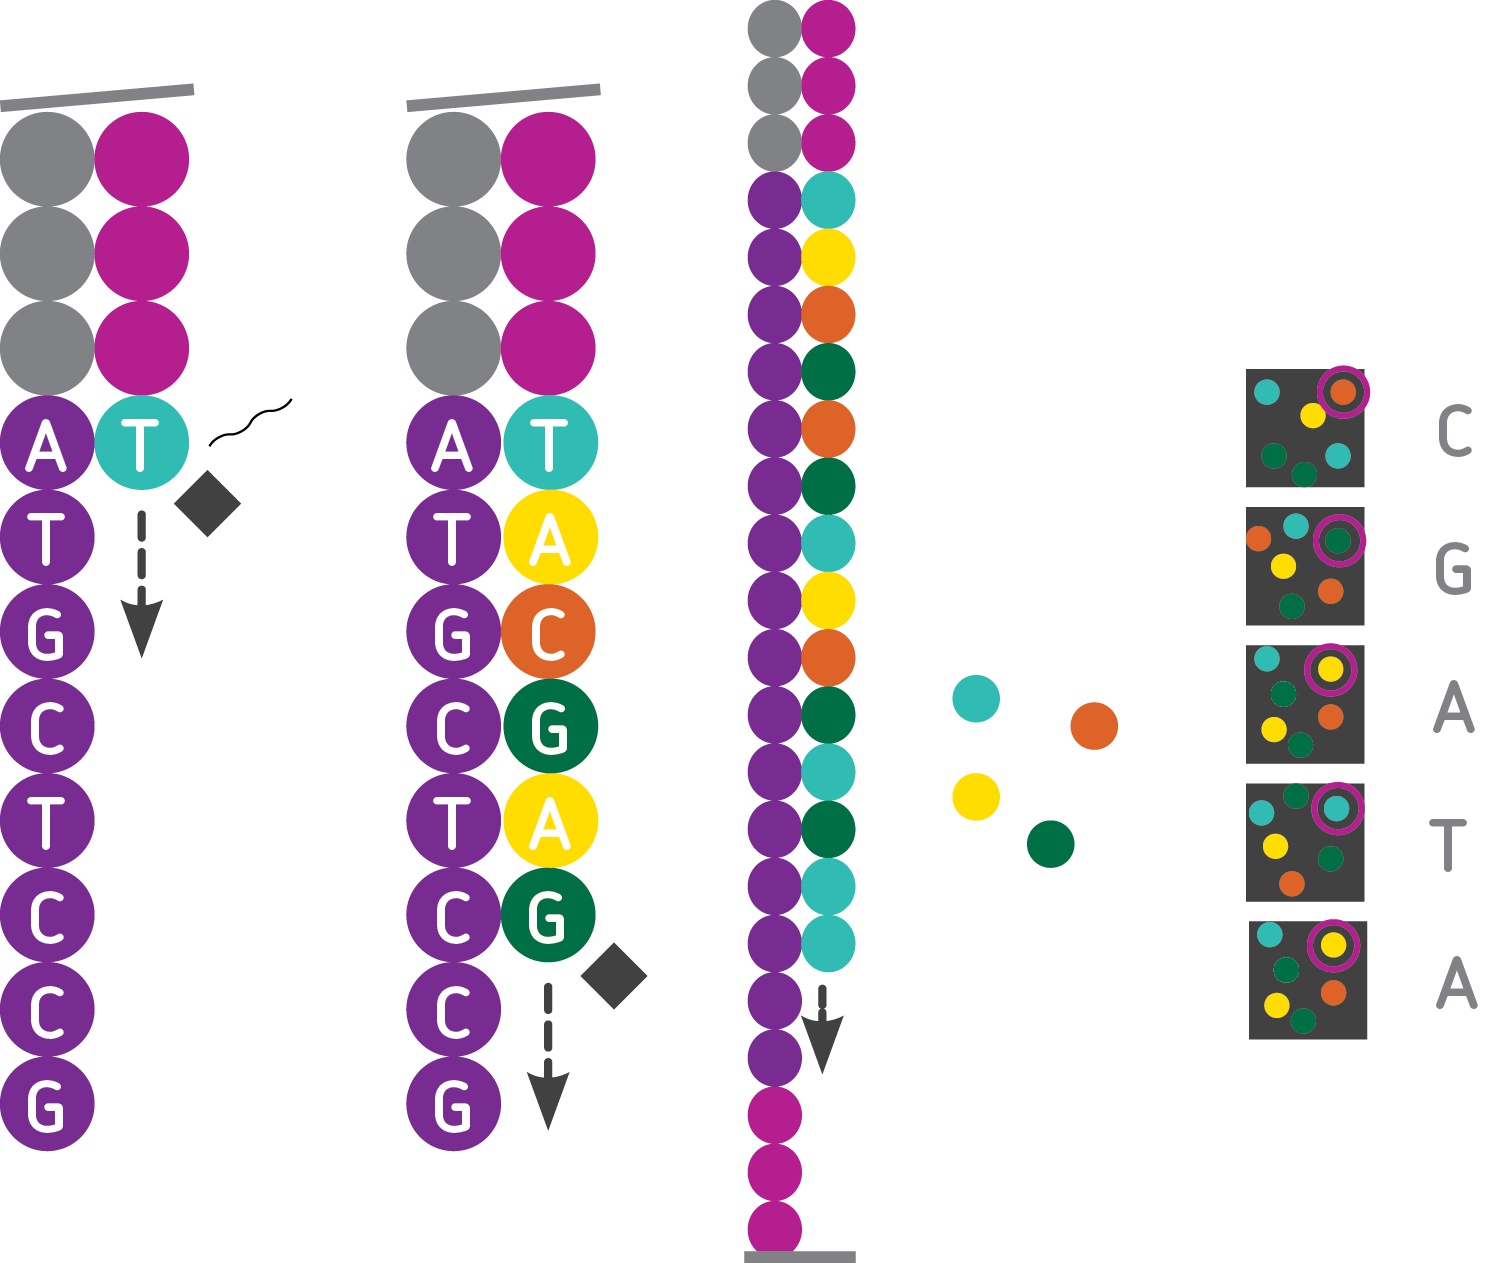
图 3.8 采用早期 Solexa/Illumina 专利中的一个 dCTP 实例。先沿着脱氧核糖看三个位置:5′ 端连着三磷酸,1′ 位与胞嘧啶的 N1 相连,3′ 位的羟基则被暂时封闭。碱基的 C5 位另接一条含二硫键的连接子,末端连接染料。图中将染料部分简写为 Dye;这是关键结构图,并未展开完整染料分子。可打开原尺寸结构图查看各处键线。
- 为什么每轮只加入一个碱基? 该实例的 3′ 位带有 –O–CH₂–N₃,即 3′-O-叠氮甲基。聚合酶把核苷酸接到正在延伸的 DNA 链后,新链末端没有可供下一次反应的游离 3′-OH,延伸便暂时停止。
- 为什么还能继续测下一个碱基? 成像之后,以 TCEP 为例的还原处理可使叠氮甲基经 Staudinger 型反应脱除,恢复 3′-OH;连接子中的二硫键也可以被还原,从碱基上切除染料。糖上的封闭被解除,而碱基上仍可留有一段连接子残基,不能把整个核苷酸说成恢复了天然结构。
- 三磷酸去了哪里? 图 A 画的是尚未掺入的底物。聚合反应保留与糖相连的 α 磷酸形成磷酸二酯键,另外两个磷酸以焦磷酸形式释放;图 B 的链末端因此不再带着完整三磷酸。
这里要理解的是“暂停延伸—识别信号—恢复延伸”的机制。不同代际试剂的染料、连接子、封闭基团与处理条件可以变化,不能仅从光学通道数判断分子的化学结构。
早期 Illumina 平台四种碱基各带一种染料,需要四个光学通道。NovaSeq 等新平台改用两色编码:G 不带染料(“暗碱基”),一个碱基带双染料,其余两种各带一种染料——例如 NovaSeq 6000 上 A 为红绿双染、C 红、T 绿、G 暗;NovaSeq X/XLEAP 化学则改为蓝绿双通道,C 为双染。减少通道可以提高成像速度和密度,代价是需要靠“有无信号”的组合来推断碱基,对信号质量的要求更高。
读长的限制:phasing 与 pre-phasing
Illumina 单端读长通常不超过 300 bp,主要有两方面原因。
第一,测序循环中不同模板链的延伸会逐渐失去同步,即 phasing(落后:本该加的碱基没加上)与 pre-phasing(超前:一轮加了不止一个碱基)。通俗地讲,一个 cluster 起初是 100 条完全相同的链;某轮如果 99 条加了碱基、1 条没加,整体信号仍是那种颜色,还能正确判断;但随着循环数增加,不同步的链越来越多,杂信号越来越强,最后可能出现“50 红 50 绿”,无法判断到底是哪种碱基。造成 phasing 的主要原因是部分链没有正常延伸(如聚合酶活性下降);pre-phasing 则可能来自可逆终止基团提前脱落或不完全终止。
第二,测序使用的核苷酸带有很大的荧光修饰基团,聚合酶长时间反应后活性下降;实际读长还受化学稳定性、信号质量和解码方法等因素影响,不能把所有平台归为同一种“荧光淬灭原理”。
相比之下,Sanger 测序的每条序列独立反应、独立电泳读出,不受 cluster 同步性限制,因此单条序列可以读到 500 bp 以上。
3.4 MGI 测序技术
MGI 是另一个主流短读长平台。我们来看它怎样生成信号并读取序列。
华大智造测序仪
华大智造(MGI)的 DNBSEQ 技术同样实现大规模并行短读长测序,但簇生成和测序化学与 Illumina 不同。
文库片段先环化,再通过滚环复制(rolling circle replication)反复复制同一个环状分子,形成由大量相同拷贝组成的 DNA 纳米球(DNB,DNA Nanoball)。这一步是溶液中的线性扩增:每轮复制都从原始环重新读取,复制错误不会像链式反应那样指数放大。制备好的 DNB 被加载到芯片上规则排列的结合位点,每个位点只容纳一个纳米球,形成规则阵列。
测序采用 cPAS(联合探针锚定聚合测序):每轮反应中加入带荧光的可逆终止 dNTP,在锚定探针和聚合酶的作用下延伸一个碱基并成像,随后清除荧光、解除终止进入下一轮。reads 输出同样是 FASTQ 格式,与 Illumina 数据的下游分析流程高度兼容。
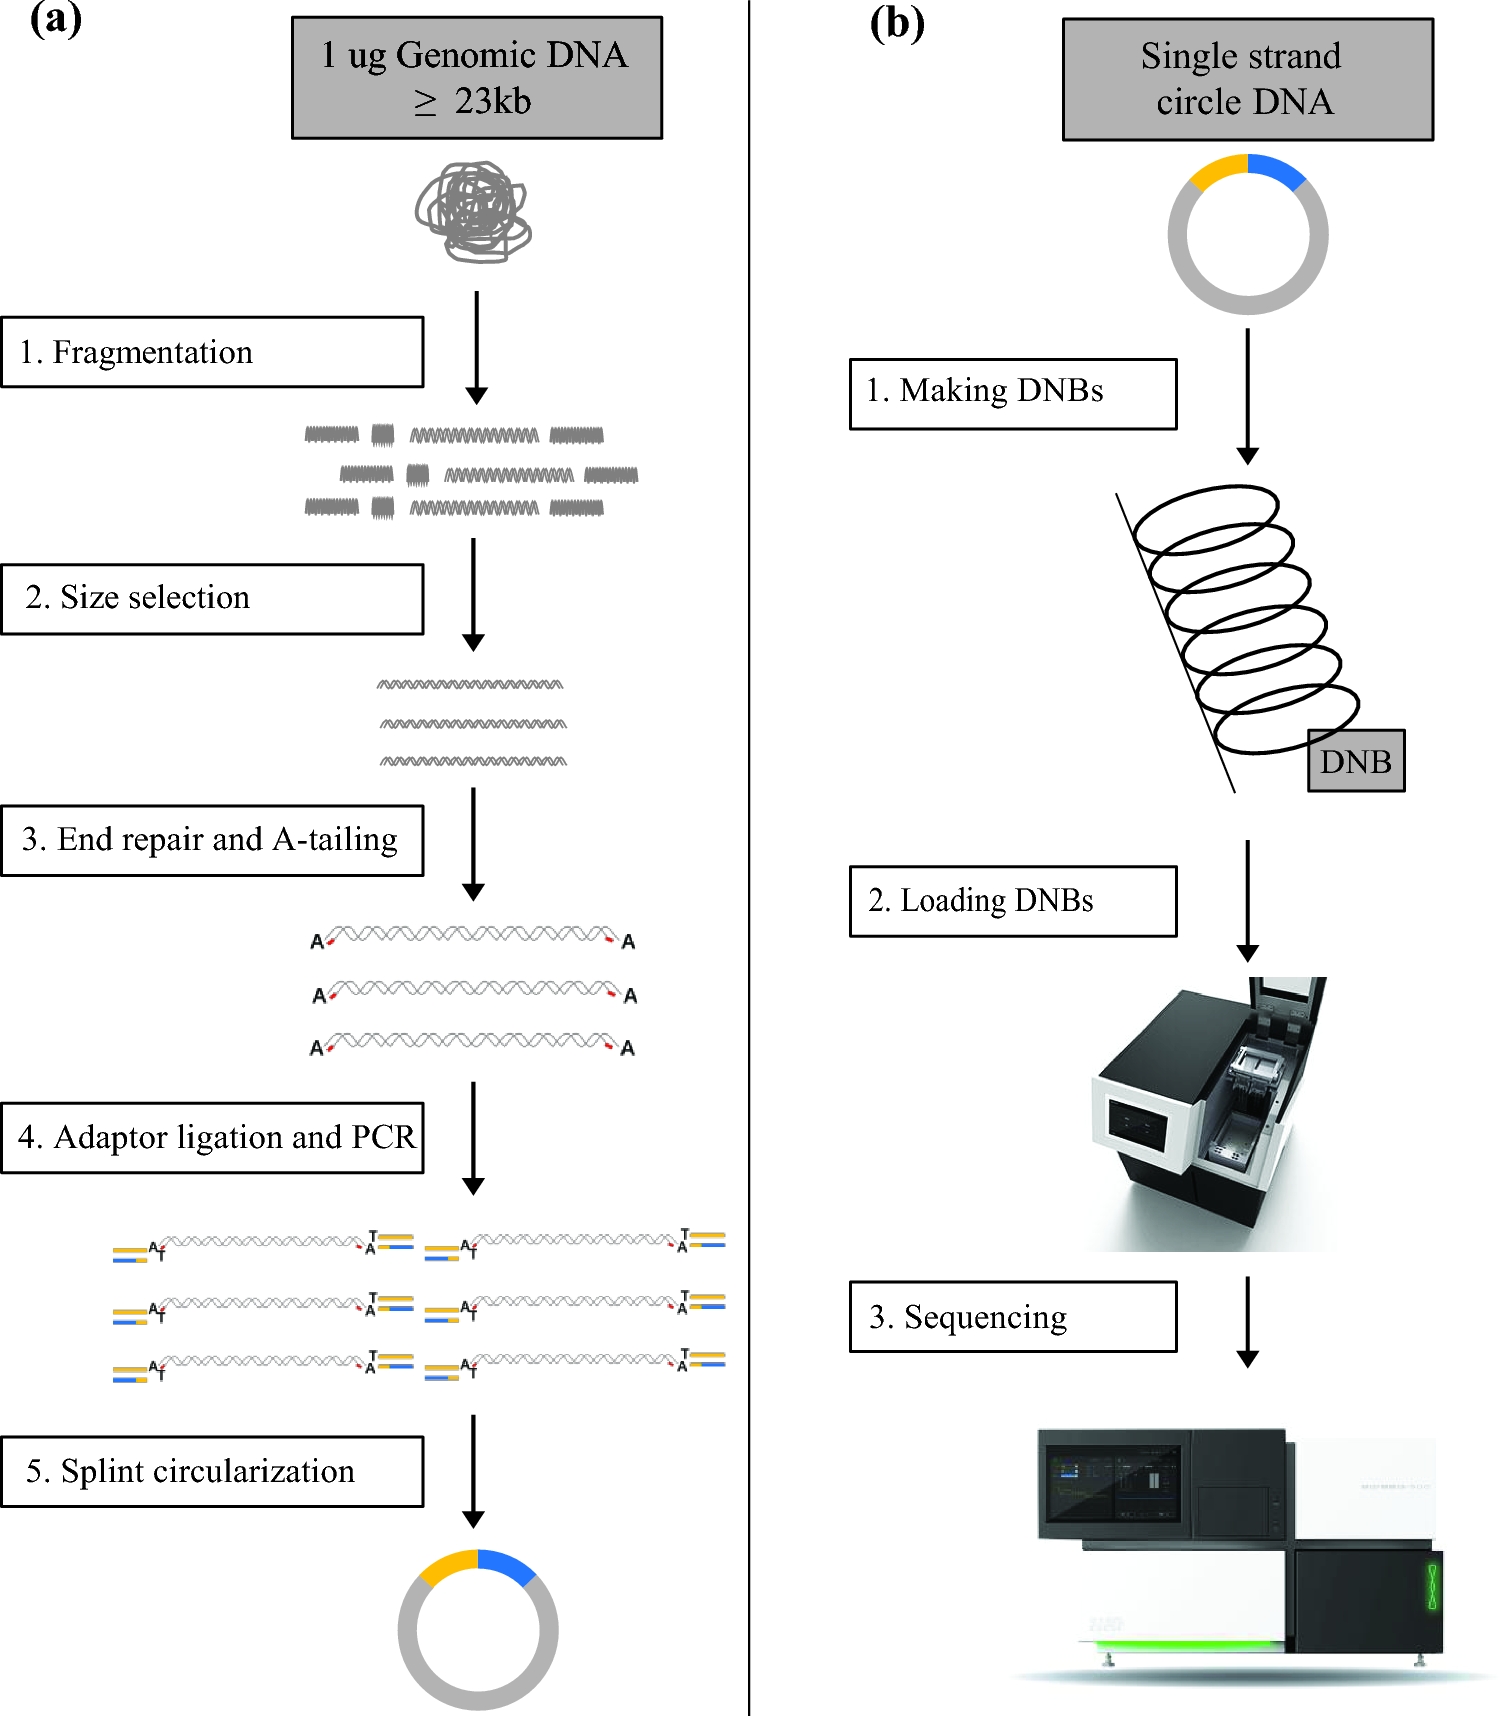
常见机型覆盖不同通量:DNBSEQ-T7 与 T20×2 面向超大人群测序,MGISEQ-2000/DNBSEQ-G400 等常用于科研与临床。选型时同样应查对应型号的实际参数,而不是凭印象套用其他平台的数字。
3.5 长读长测序:PacBio 与 Nanopore
短读长有哪些不足,长读长技术又能提供什么数据?
短读长 reads 难以跨越重复序列、结构变异和全长转录本,这时需要长读长技术。与短读长平台不同,长读长测序不依赖簇扩增,而是直接读取单个分子。
PacBio:SMRT 测序与 HiFi 读长
PacBio 的 SMRT(Single Molecule Real-Time)测序把单个聚合酶固定在零模波导孔(ZMW)底部,四种带不同荧光染料的 dNTP(染料标记在磷酸链上,掺入后自动脱离,因此不需要可逆终止)逐个掺入,实时记录荧光脉冲序列( 图 3.10 )。聚合酶可以连续合成,单条读长可达数十 kb。
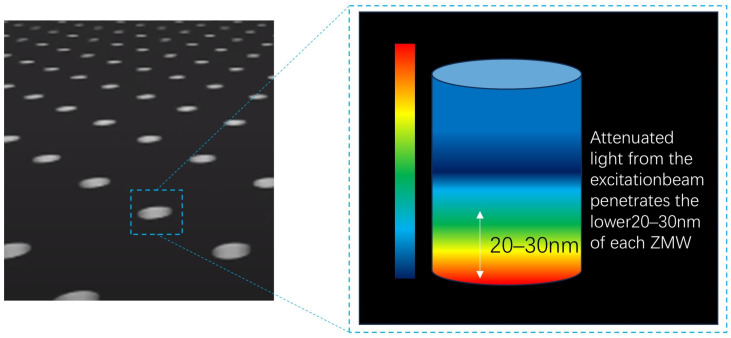
SMRT 的单遍错误率较高(约 10% 量级),但错误基本随机分布。HiFi 测序利用这一点:把同一分子环化后反复读取(至少 3 遍),对多次读取取一致序列,得到既长(15—25 kb)又准(Q30 以上)的 HiFi reads。PacBio 适合解决结构变异、高度重复或复杂区域,以及通过 Iso-Seq 获得全长转录本。
Nanopore:纳米孔电流测序
Oxford Nanopore 的原理完全不同:马达蛋白牵引单链 DNA(或 RNA)穿过嵌在膜上的纳米孔,不同碱基组合对孔道电流的阻滞不同,仪器连续记录电流变化,再由碱基识别算法(basecalling)把电信号翻译成序列( 图 3.11 )。它不依赖合成反应,读长理论上只受样品 DNA 长度限制,可达数百 kb 至 Mb 级;设备从掌上 MinION 到高通量台式机都有,可以现场快速测序。
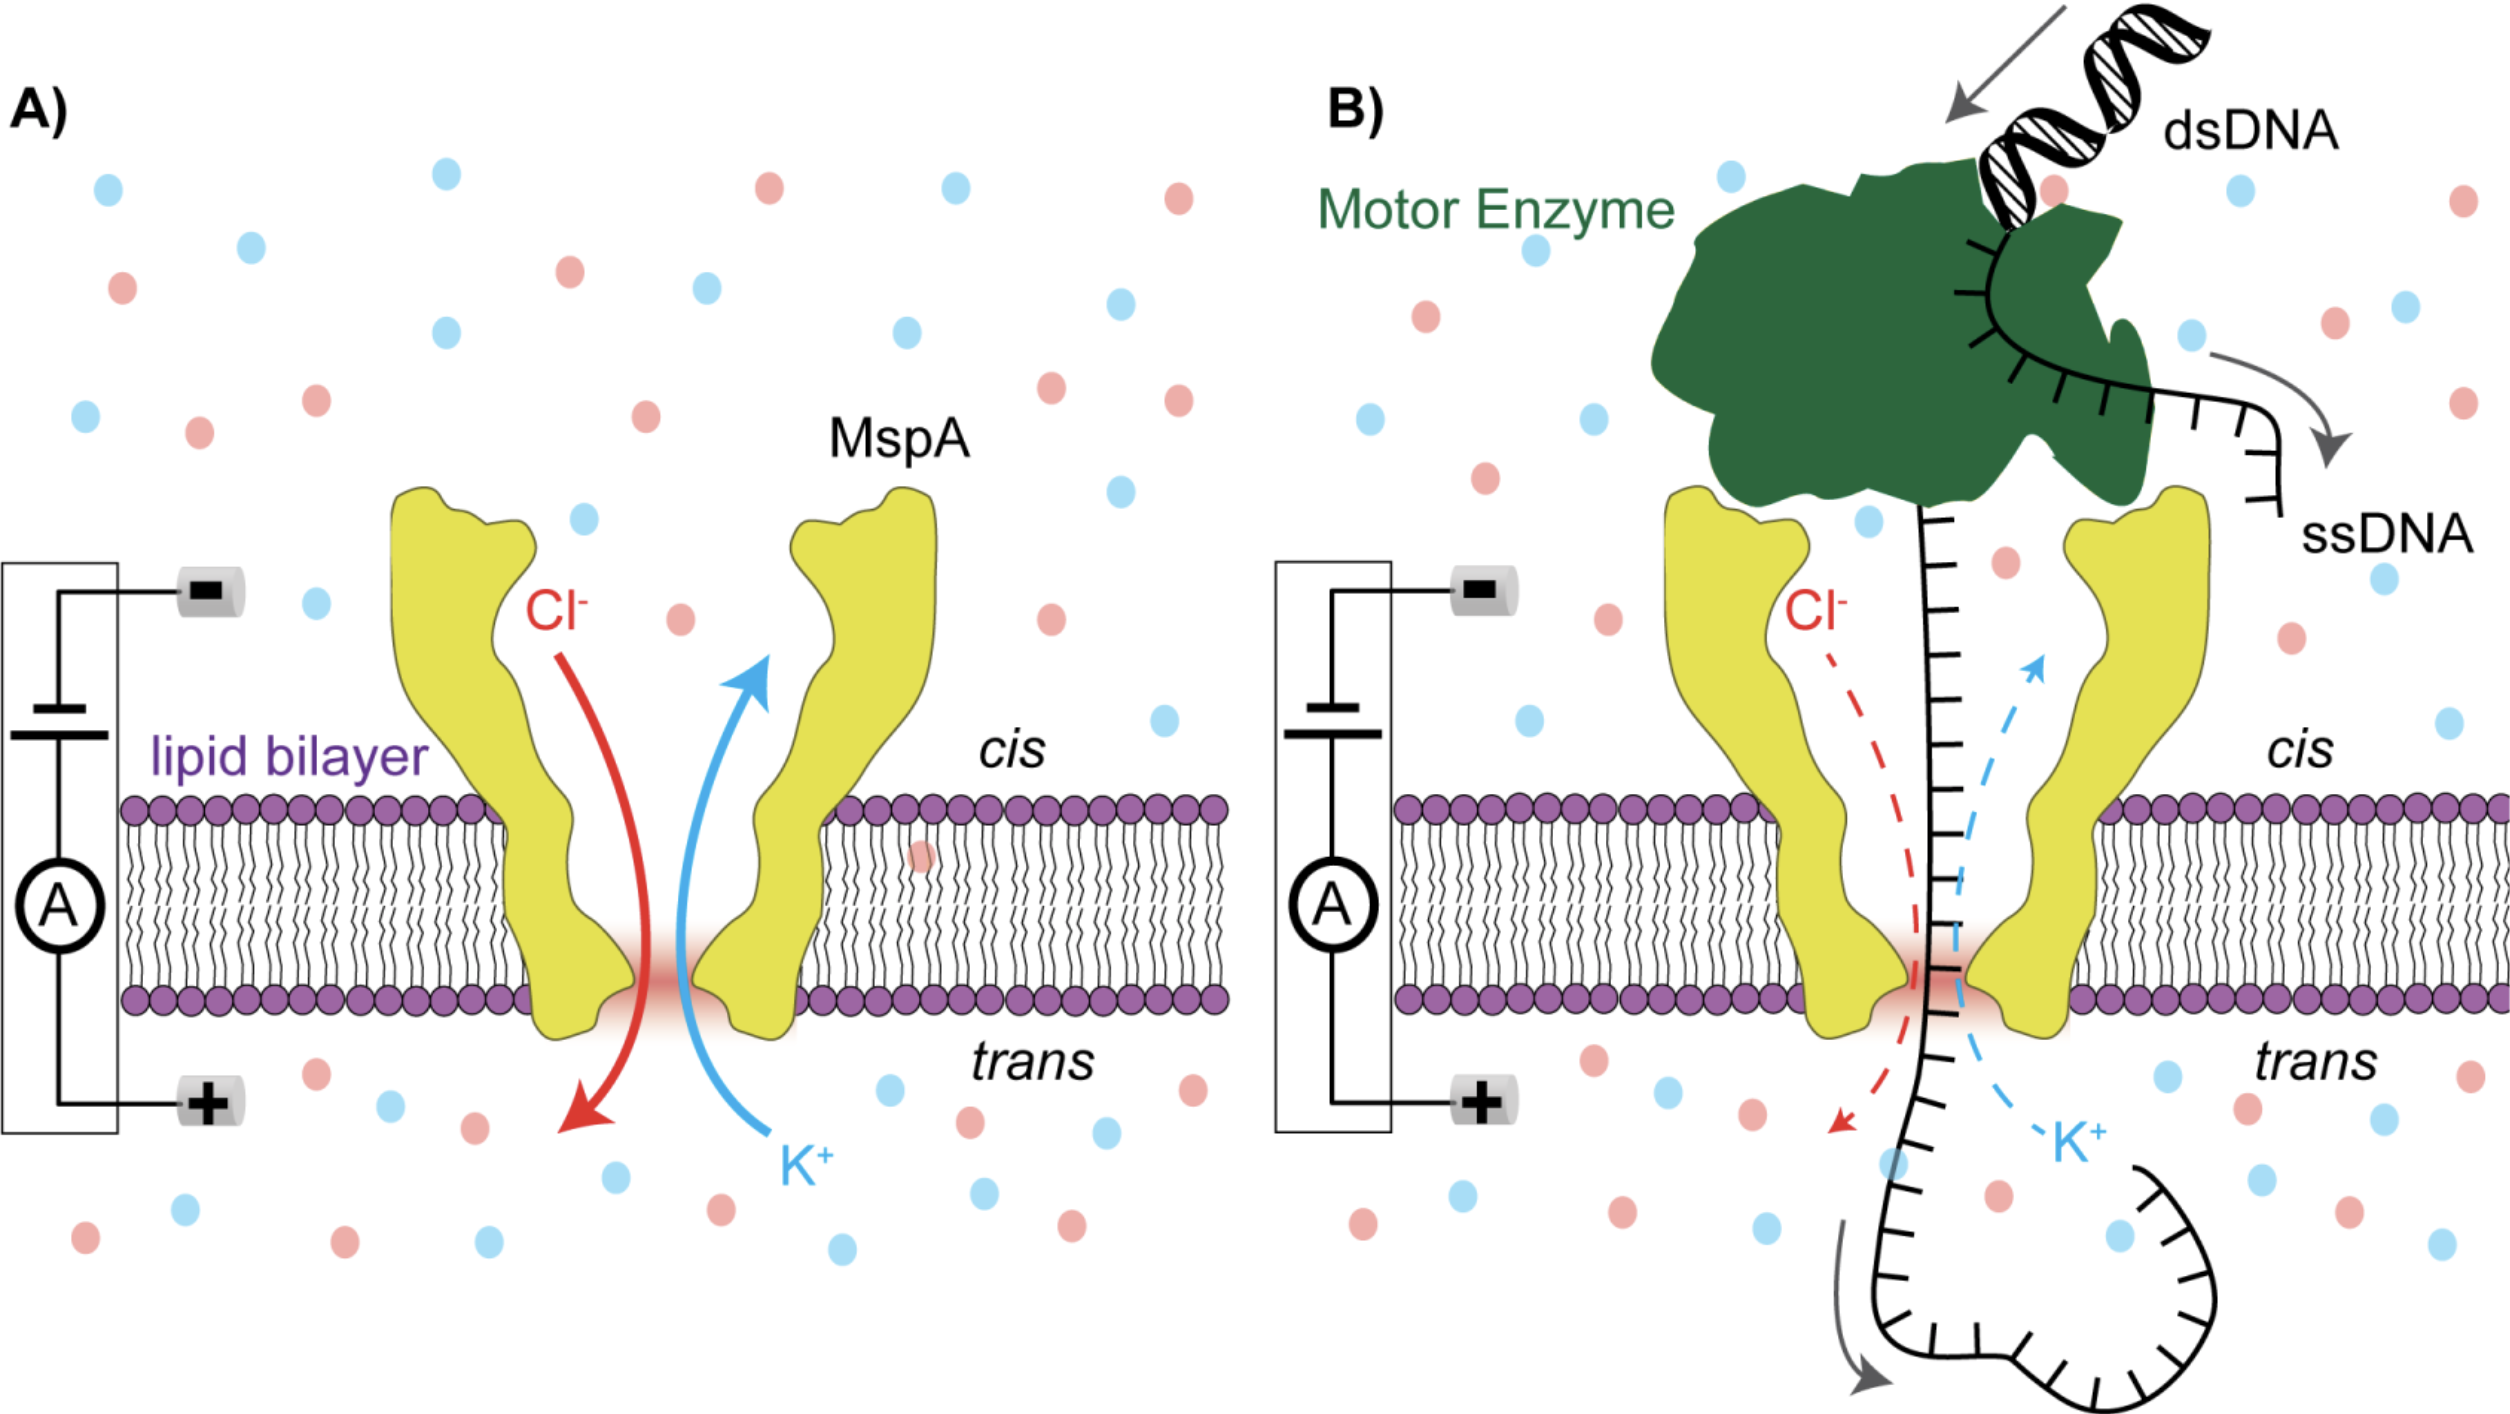
纳米孔的单遍错误率历史上约 5%—10%,且存在非随机的系统偏差;随着化学体系与识别算法改进(如 Q20 化学和新版 basecaller),精度持续提升。它还能对 RNA 直接测序(不经过逆转录),保留碱基修饰信息,这是其他平台做不到的。
长读长 RNA 测序
常规短读长 RNA-seq 通常先把 RNA 逆转录成 cDNA,再构建文库(流程详见第 5 章)。一个转录本被拆成许多短片段后,需要根据这些片段推断原有结构。长读长技术可以减少这方面的困难,因此特别适合用来理解转录本异构体。
PacBio 的 SMRT 测序观察聚合酶合成 DNA 时的荧光信号。Iso-Seq 分析的是由 RNA 逆转录得到的全长 cDNA,不能称为直接 RNA 测序。Oxford Nanopore 则根据核酸链通过纳米孔时的电流变化推断序列,既有 cDNA 测序,也有直接 RNA 测序;其常用平台不依靠外切酶逐个切下碱基再读取。
长读长、准确度、通量和定量性能需要结合具体平台、化学版本和建库方案讨论,不能只用某一代平台的单一数值来概括。PacBio、Nanopore 和直接 RNA 测序的进一步比较、示例数据与练习待完善。
3.6 高通量文库构建
理解文库结构,才能解释 reads 里为什么会有接头和 index。
建库的基本流程
短读长测序每次只能读取有限长度,因此需要先把待测核酸制成适合平台的文库。下面以片段化的 DNA 文库为例:先把较长的 DNA 打断,再通过片段筛选控制长度分布。本书以 300—500 bp 的插入片段举例;实际范围应按建库方案、读长和研究目的确定。
打断后的片段末端往往不平整,需要先用酶补平,再在 3′ 端用酶加上一个特异的碱基 A。此后利用 A 与末端 T 的互补配对,把 adapter 连接到片段两端。
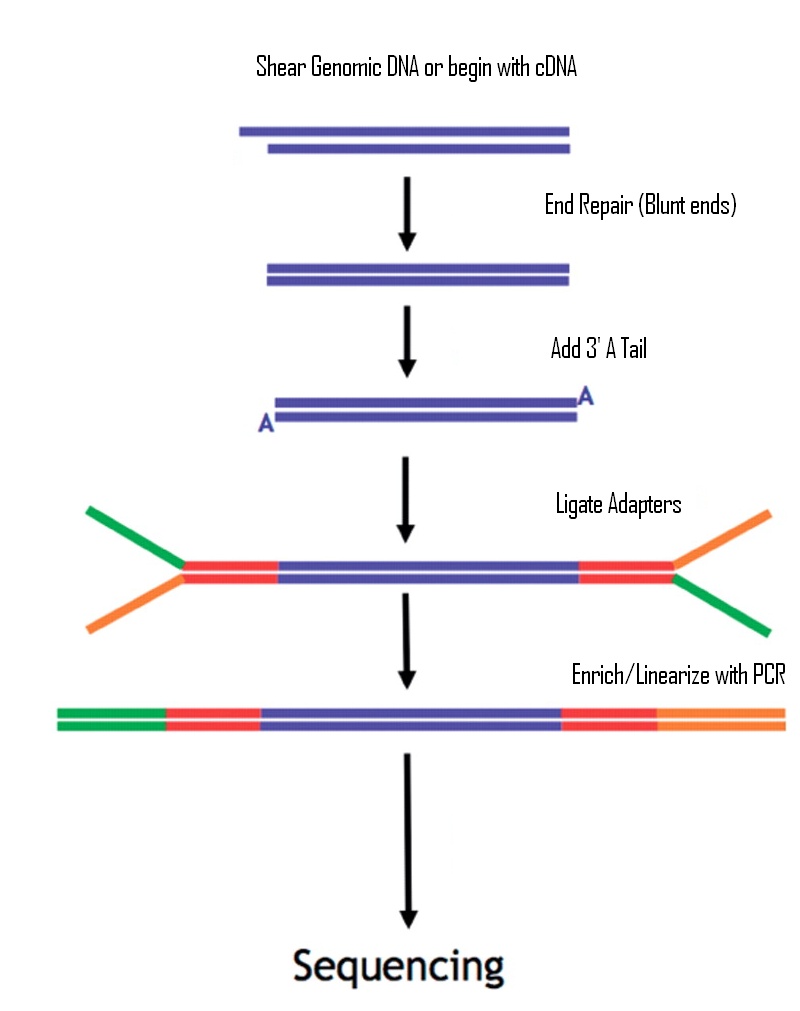
接头(adapter)的结构与作用
adapter 中文常译为适配器或接头,是建库时连接到片段两端的人工序列。它不只是“一段引物”,而是一组功能元件的组合:与 flowcell 表面寡核苷酸互补配对的序列(P5/P7)、桥式 PCR 所需的引物结合位点、测序引物结合位点,以及样本标签(index)位点。
一个典型的双端索引文库结构是:
P5 — adapter1(含 i5 index 位点)— fragment — adapter2(含 i7 index 位点)— P7测序时加入的引物与 adapter 中专门的测序引物结合位点配对;index 序列由独立的 index read 单独读取,并不出现在 R1/R2 的 reads 里。这里要分清 adapter 与 primer:adapter 是连接在分子上的固定序列,primer 是反应时外加的寡核苷酸,二者靠互补配对起作用。
index 与多样本混合上机
一条 lane 的测序能力往往远大于一个样本的需要(早期的 HiSeq 2000/2500 一条 lane 约 30G;如今一条 lane 的产出从几 Gb 到数 Tb 不等,随机型差异极大)。为充分利用通量并节约成本,建库时给每个样本的接头加上不同的标签序列,即 index(也称 barcode)。多个文库可以混合上机(multiplexing),测序后再按 index 把数据拆分回各自的样本。因此拿到数据时,除了 R1/R2,通常还会得到 index read 的 fastq 文件。
测穿与 read 3′ 端的接头序列
read1 从 insert 的一端向内测序。当插入片段比读长短时,聚合会“测穿”片段、读到另一端的 adapter,因此 adapter 序列总是出现在 read 的 3′ 端。这正是后续质控中“Adapter Content”模块要检测的内容:如果大量 reads 的 3′ 端出现接头,说明文库插入片段偏短或测序读长过长,比对前必须去除。
3.7 测序数据的存储:FASTA 与 FASTQ
能够逐行读懂原始序列文件并解释碱基质量。
测序得到的原始数据以 FASTQ 格式储存,纯序列则常用 FASTA 格式。本节先认识这两种文件格式,再解释其中质量值的编码方式。
FASTQ:一条读段的四行记录
FASTQ 文件每 4 行记录一条 read:
- 第 1 行以
@开头,储存这条 read 的名称和测序坐标等信息; - 第 2 行是测序得到的碱基序列,一般用 A、T、C、G、N 表示,N 代表该位置荧光信号无法判断碱基种类;
- 第 3 行以
+开头,可以储存附加信息,目前的测序数据这一行一般是空的; - 第 4 行是质量字符串,与第 2 行的碱基一一对应,每个字符编码对应位置碱基的测序质量,值越大质量越好。
第 1 行的一个典型例子是 @ST-E00126:128:HJFLHCCXX:2:1101:7405:1133,冒号分隔的各字段含义如下:
| 字段 | 示例 | 含义 |
|---|---|---|
| 标记 | @ |
read 名称行的起始符号 |
| 设备名 | ST-E00126 |
测序仪(设备)名称 |
| 运行号 | 128 |
run(运行)编号 |
| 流动槽 | HJFLHCCXX |
flowcell 编号 |
| 泳道 | 2 |
lane 的编号 |
| 扫描区 | 1101 |
tile 的编号 |
| X 坐标 | 7405 |
在 tile 中的 X 坐标 |
| Y 坐标 | 1133 |
在 tile 中的 Y 坐标 |
实际拿到手的 Illumina 数据通常是 .fastq.gz:gz 表示用 gzip 压缩,fastq 表示用 FASTQ 格式存储。双端测序每个样本会有 R1、R2 两个文件(可能还有 index 文件),两者中同名 read 互为配对。
碱基质量与 Phred 编码
质量字符串的每个字符都是 ASCII 字符,其质量值等于 ASCII 十进制值减去一个固定偏移。同一字符在不同偏移下含义不同,历史上常见的两种编码是 Phred+33 与 Phred+64:
\[ \begin{aligned} \operatorname{Phred}_{33}(\text{F}) &= 70-33=37 \\ \operatorname{Phred}_{64}(\text{F}) &= 70-64=6 \end{aligned} \](3.1)
也就是说,同样的字符 F,在 Phred+33 文件里代表质量值 37,在 Phred+64 文件里代表质量值 6,相差整整 31。下表覆盖全部 128 个 ASCII 字符(编号 0—127):左半组为 0—63、右半组为 64—127。质量字符串只会使用可打印字符(33—126),因此控制字符(0—31、127)两列 Q 值均记为“—”;Phred+64 编码历史上只用到 105(Q41)。
| 十进制 | 字符 | Phred+33 的 Q 值 | Phred+64 的 Q 值 | 十进制 | 字符 | Phred+33 的 Q 值 | Phred+64 的 Q 值 |
|---|---|---|---|---|---|---|---|
| 0 | NUL | — | — | 64 | @ |
31 | 0 |
| 1 | SOH | — | — | 65 | A |
32 | 1 |
| 2 | STX | — | — | 66 | B |
33 | 2 |
| 3 | ETX | — | — | 67 | C |
34 | 3 |
| 4 | EOT | — | — | 68 | D |
35 | 4 |
| 5 | ENQ | — | — | 69 | E |
36 | 5 |
| 6 | ACK | — | — | 70 | F |
37 | 6 |
| 7 | BEL | — | — | 71 | G |
38 | 7 |
| 8 | BS | — | — | 72 | H |
39 | 8 |
| 9 | HT | — | — | 73 | I |
40 | 9 |
| 10 | LF | — | — | 74 | J |
41 | 10 |
| 11 | VT | — | — | 75 | K |
42 | 11 |
| 12 | FF | — | — | 76 | L |
43 | 12 |
| 13 | CR | — | — | 77 | M |
44 | 13 |
| 14 | SO | — | — | 78 | N |
45 | 14 |
| 15 | SI | — | — | 79 | O |
46 | 15 |
| 16 | DLE | — | — | 80 | P |
47 | 16 |
| 17 | DC1 | — | — | 81 | Q |
48 | 17 |
| 18 | DC2 | — | — | 82 | R |
49 | 18 |
| 19 | DC3 | — | — | 83 | S |
50 | 19 |
| 20 | DC4 | — | — | 84 | T |
51 | 20 |
| 21 | NAK | — | — | 85 | U |
52 | 21 |
| 22 | SYN | — | — | 86 | V |
53 | 22 |
| 23 | ETB | — | — | 87 | W |
54 | 23 |
| 24 | CAN | — | — | 88 | X |
55 | 24 |
| 25 | EM | — | — | 89 | Y |
56 | 25 |
| 26 | SUB | — | — | 90 | Z |
57 | 26 |
| 27 | ESC | — | — | 91 | [ |
58 | 27 |
| 28 | FS | — | — | 92 | \ |
59 | 28 |
| 29 | GS | — | — | 93 | ] |
60 | 29 |
| 30 | RS | — | — | 94 | ^ |
61 | 30 |
| 31 | US | — | — | 95 | _ |
62 | 31 |
| 32 | 空格 | — | — | 96 | ` |
63 | 32 |
| 33 | ! |
0 | — | 97 | a |
64 | 33 |
| 34 | " |
1 | — | 98 | b |
65 | 34 |
| 35 | # |
2 | — | 99 | c |
66 | 35 |
| 36 | $ |
3 | — | 100 | d |
67 | 36 |
| 37 | % |
4 | — | 101 | e |
68 | 37 |
| 38 | & |
5 | — | 102 | f |
69 | 38 |
| 39 | ' |
6 | — | 103 | g |
70 | 39 |
| 40 | ( |
7 | — | 104 | h |
71 | 40 |
| 41 | ) |
8 | — | 105 | i |
72 | 41 |
| 42 | * |
9 | — | 106 | j |
73 | — |
| 43 | + |
10 | — | 107 | k |
74 | — |
| 44 | , |
11 | — | 108 | l |
75 | — |
| 45 | - |
12 | — | 109 | m |
76 | — |
| 46 | . |
13 | — | 110 | n |
77 | — |
| 47 | / |
14 | — | 111 | o |
78 | — |
| 48 | 0 |
15 | — | 112 | p |
79 | — |
| 49 | 1 |
16 | — | 113 | q |
80 | — |
| 50 | 2 |
17 | — | 114 | r |
81 | — |
| 51 | 3 |
18 | — | 115 | s |
82 | — |
| 52 | 4 |
19 | — | 116 | t |
83 | — |
| 53 | 5 |
20 | — | 117 | u |
84 | — |
| 54 | 6 |
21 | — | 118 | v |
85 | — |
| 55 | 7 |
22 | — | 119 | w |
86 | — |
| 56 | 8 |
23 | — | 120 | x |
87 | — |
| 57 | 9 |
24 | — | 121 | y |
88 | — |
| 58 | : |
25 | — | 122 | z |
89 | — |
| 59 | ; |
26 | — | 123 | { |
90 | — |
| 60 | < |
27 | — | 124 | | | 91 | — |
| 61 | = |
28 | — | 125 | } |
92 | — |
| 62 | > |
29 | — | 126 | ~ |
93 | — |
| 63 | ? |
30 | — | 127 | DEL | — | — |
那质量值 Q 本身是什么?它是错误概率的函数:
\[ Q=-10\log_{10}P \](3.2)
其中 P 是该碱基被判读错误的概率(Probability of incorrect base call)。Q 值为 40 代表错误概率 0.0001;为 30 代表 0.001;为 20 代表 0.01;为 10 则代表 0.1。把 Q 加上偏移量(33 或 64),再取对应的 ASCII 字符,就得到 FASTQ 第四行的质量字符串;反过来,读文件时用字符的十进制值减去偏移量即恢复 Q 值。
早年 Solexa 系列仪器使用过另一种以错误几率定义的质量:
\[ Q_{\text{Solexa}}=-10\log_{10}\frac{P}{1-P} \](3.3)
它在错误率较高时与 Phred 定义差别明显,低错误率时两者趋于一致。实际数据处理中需要注意编码历史:近年产生的数据基本都采用 Phred+33;从 NCBI SRA 下载的早期数据可能是 Phred+64 或 Solexa 编码,交给软件处理时要正确指定,例如 cutadapt 的 --quality-base=64 参数。
FASTA:存储纯序列
FASTA 格式用于储存纯序列信息,可以放 DNA、RNA 和蛋白质序列。第 1 行以 > 开头,是序列描述;从第 2 行起是序列本身。描述行的字段因数据库而异,下面是两个常见例子(UniProt 蛋白质记录与 GenBank mRNA 记录;mRNA 序列中的 U 在文件里写作 T):
>sp|P69905|HBA_HUMAN Hemoglobin subunit alpha OS=Homo sapiens GN=HBA1
MVLSPADKTNVKAAWGKVGAHAGEYGAEALERMFLSFPTTKTYFPHFDLSHGSAQVKGHGKKVADALTNAVAHVDDMPNALSALSDLHAHKLRVDPVNFKLLSHCLLVTLAAHLPAEFTPAVHASLDKLASVSTVLTSKYR
>gi|13650073|gb|AF349571.1| Homo sapiens hemoglobin alpha-1 globin chain (HBA1) mRNA, complete cds
CCCACAGACTCAGAGAGAACCCACCATGGTGCTGTCTCCTGACGACAAGACCAACGTCAAGGCCGCCTGGGGTAAGGTCGGCGCGCACGCTGGCGAGTATGGTGCGGAGGCCCTGGAGAGGATGTTCCTGTCCTTCCCCACCACCAAGACCTACTTCCCGCACTTCGACCTGAGCCACGGCTCTGCCCAGGTTAAGGGCCACGGCAAGAAGGTGGCCGACGCGCTGACCAACGCCGTGGCGCACGTGGACGACATGCCCAACGCGCTGTCCGCCCTGAGCGACCTGCACGCGCACAAGCTTCGGGTGGACCCGGTCAACTTCAAGCTCCTAAGCCACTGCCTGCTGGTGACCCTGGCCGCCCACCTCCCCGCCGAGTTCACCCCTGCGGTGCACGCCTCCCTGGACAAGTTCCTGGCTTCTGTGAGCACCGTGCTGACCTCCAAATACCGTTAAGCTGGAGCCTCGGTGGCCATGCTTCTTGCCCCTTTGFASTA 与 FASTQ 的适用场景
只关心序列本身时用 FASTA,参考基因组、转录本序列和蛋白质序列都以此发布。需要同时保留每个碱基的测序质量时用 FASTQ,测序仪下机数据、交给比对和质控软件的原始数据都是 FASTQ。因此,FASTA 描述“序列是什么”,FASTQ 还记录“每个碱基测得多准”。
3.8 质量评估:FastQC 与 MultiQC
解读质控图时,需要结合实验背景,不能只看报告中的红绿灯。
质量控制包括什么
测序原始数据以 FASTQ 格式存储,包含序列信息和碱基质量。测序过程中存在样本污染或降解、接头污染以及不可避免的测序误差等干扰因素,都会影响数据质量。质量控制的目的,一是评估数据质量、判断能否进入后续分析,二是获得高质量的测序片段。质量控制包括测序质量评估和高质量测序片段的获取两部分。
质控不能等到分析失败才做:拿到数据的第一步就应运行质控软件,先了解数据“长什么样”,再决定用什么参数处理。
FastQC:运行与结果总览
FastQC 是最常用的 FASTQ 质量评估软件( 图 3.14 )。命令行运行方式示例:
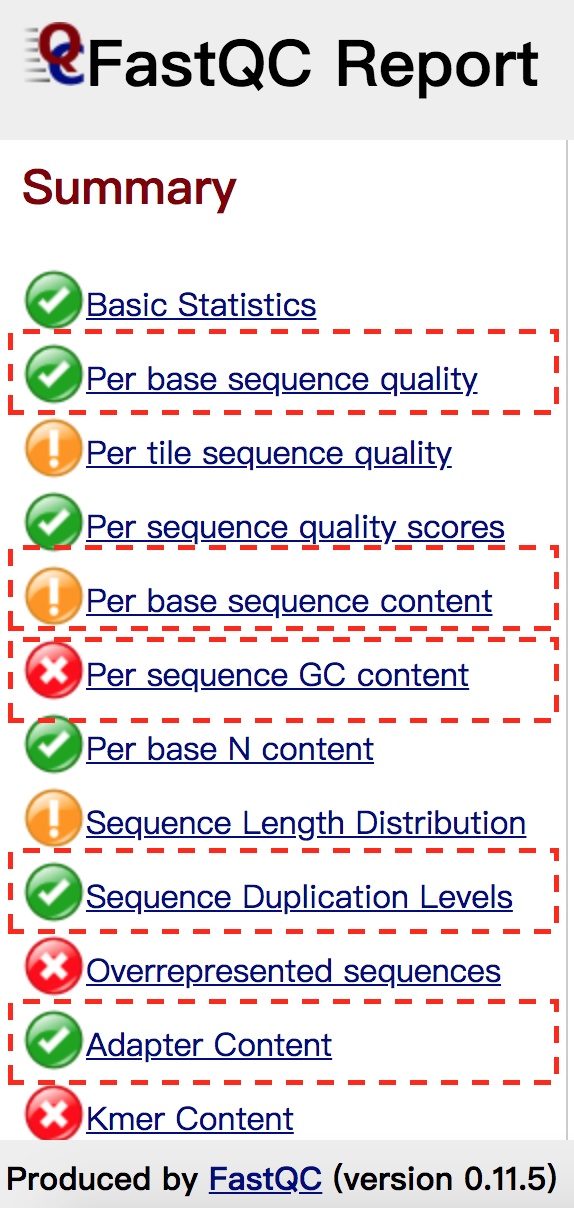
fastqc -t 4 -o fastqc_result sample_R1.fastq.gz sample_R2.fastq.gzFastQC 会对每一个输入文件生成一个 html 网页和一个 zip 压缩包(内含网页中的图片),日常只需要看网页里整理好的内容。它对碱基质量、接头序列、重复序列、GC 含量、N 含量、长度分布等逐项统计,并给出模块级别的判定:
- 基本统计(Basic Statistics)
- 每个位置的碱基质量(Per base sequence quality)
- 每条 reads 的质量分布(Per sequence quality scores)
- 每个位置上四种碱基的比例(Per base sequence content)
- 每条 reads 的 GC 含量分布(Per sequence GC content)
- 每个位置不明碱基 N 的含量(Per base N content)
- 长度分布(Sequence Length Distribution)
- 序列的重复水平(Sequence Duplication Levels)
- 突出的重复序列(Overrepresented sequences)
- 接头序列情况(Adapter Content)
- 特定短序列(k-mer)的富集情况(Kmer Content)
软件对每一项给出判定:绿色对勾代表 pass,黄色叹号代表 warn,红色叉代表 fail。判定只针对“随机文库”这一默认假设,评估为 warn 或 fail 不代表样品一定不能用,必须结合具体测序对象解读。
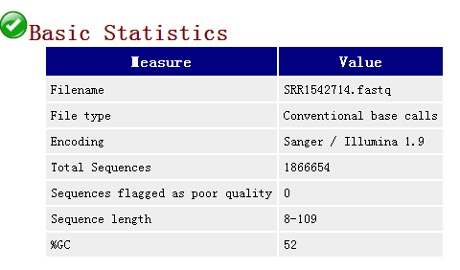
基本统计模块汇总文件类型、编码方式、总 read 数、GC 含量和序列长度等,能最快了解样本概况( 图 3.15 )。
下面逐模块解读最常看的几张图。
逐碱基序列质量(Per base sequence quality)
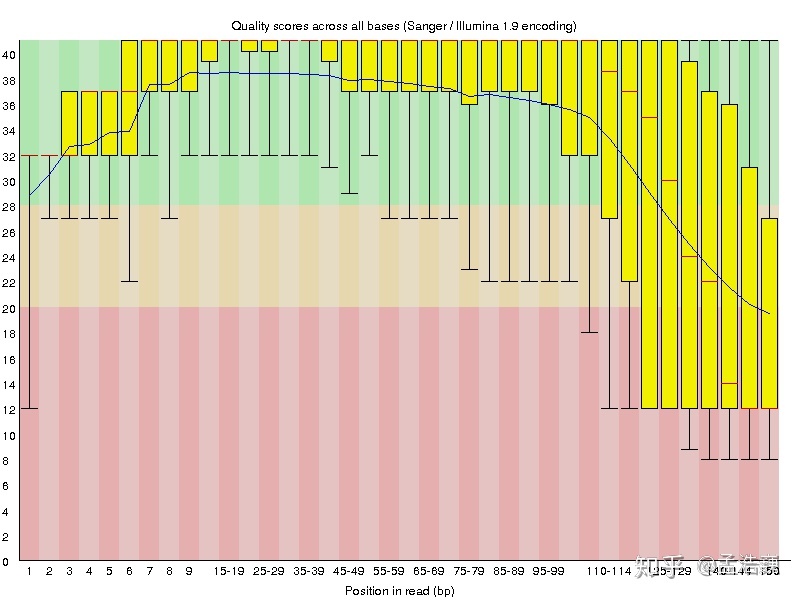
横轴是 read 中的位置(第 1 到第 150 个碱基),纵轴是每个位置所有碱基的质量值( 图 3.17 )。每个位置画一个箱线图:上下横线分别是 90% 和 10% 分位数,箱体上下缘是 75% 和 25% 分位数,箱中横线是中位数;蓝色细线连接各位置的平均质量。分位数的直观解释:若一组数的 25% 分位数是 a,意味着 a 超过了这组数中 25% 的值。判读阈值:任一位置的下四分位数低于 10 或中位数低于 25 时评估为 warn;低于 5 或 20 时评估为 fail。
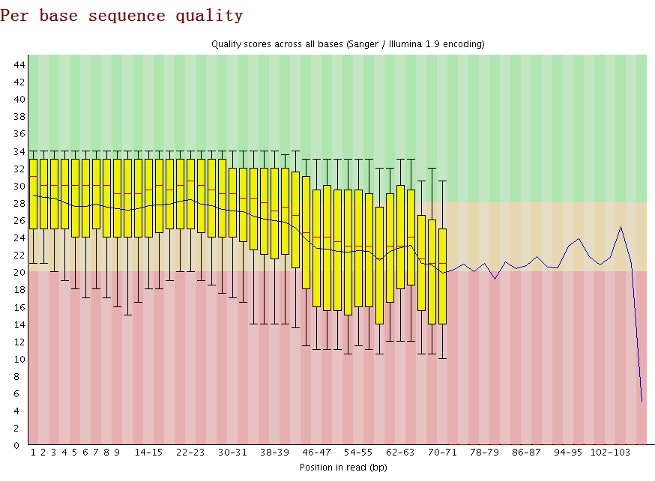
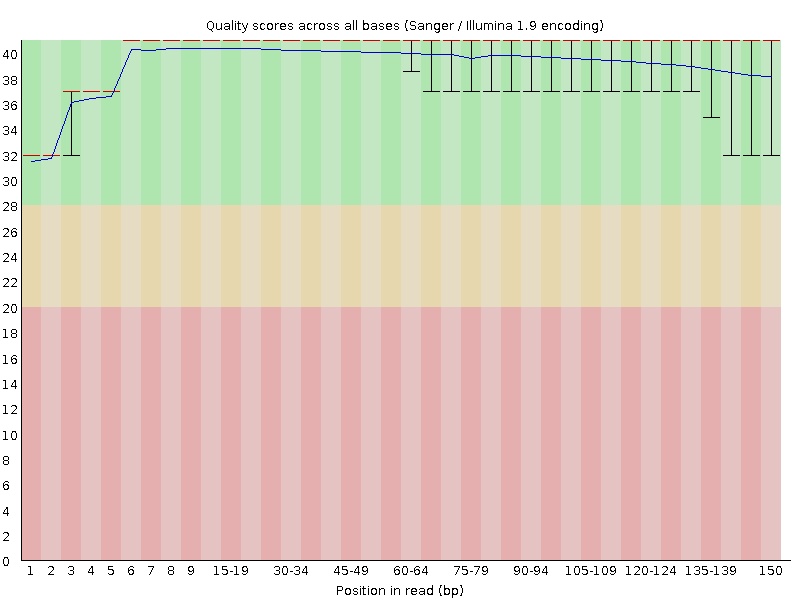
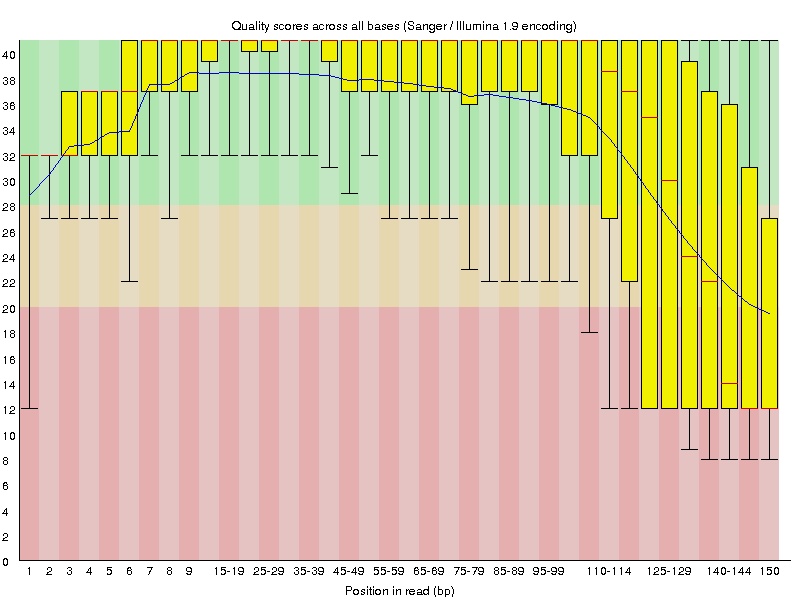
双端数据要把 R1 与 R2 分开看。下面两张图来自同一次测序( 图 3.18 与 图 3.19 ),reads2 的质量均匀性明显差于 reads1。结合本章 3.3 节的原理来看:reads1 的 150bp 测序完成后,要先重新合成互补链,再对 reads2 进行荧光测序。此时合成酶经过长时间反应,活性已经下降,部分链加不上碱基,cluster 内的同步性变差,主要表现为 phasing 错误累积、箱体整体下移、离群点增多。
碱基组成(Per base sequence content)
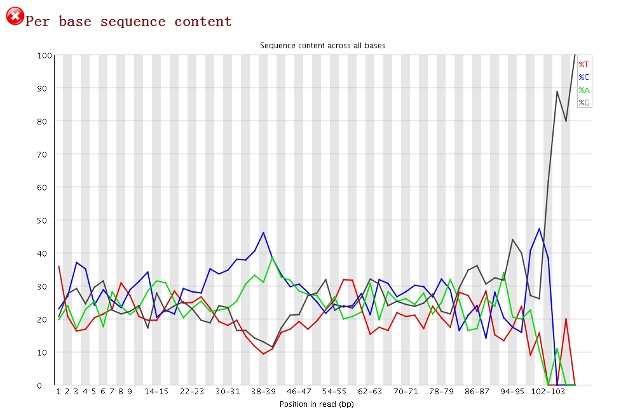
横轴同样是 read 中的位置,纵轴是每个位置 A、T、C、G 各自的百分比( 图 3.20 )。随机文库中每个位置四种碱基的比例应大致相等(Chargaff 法则),四条线应当平行地贴着 25%。判读阈值:任一位置 A 与 T 的比例之差、或 G 与 C 的比例之差超过 10% 评估为 warn,超过 20% 评估为 fail——比较的是互补碱基之间的差值,而不是 A/T 与 G/C 两个比值之间的差。
开头几 bp 出现波动是普遍现象,主要原因是建库引入的序列偏好:RNA-seq 的随机六聚体引物、转座酶片段化都会造成对起始位置的选择偏好。FastQC 官方文档指出,这类文库在约前 12bp 普遍存在偏差,多数 RNA-seq 样本在这一模块都会触发警告,一般不影响下游分析,也无法靠 trim 消除。如果测序质量得分很高,可以不 trim 开头部分;只有得分也差时才考虑 trim。
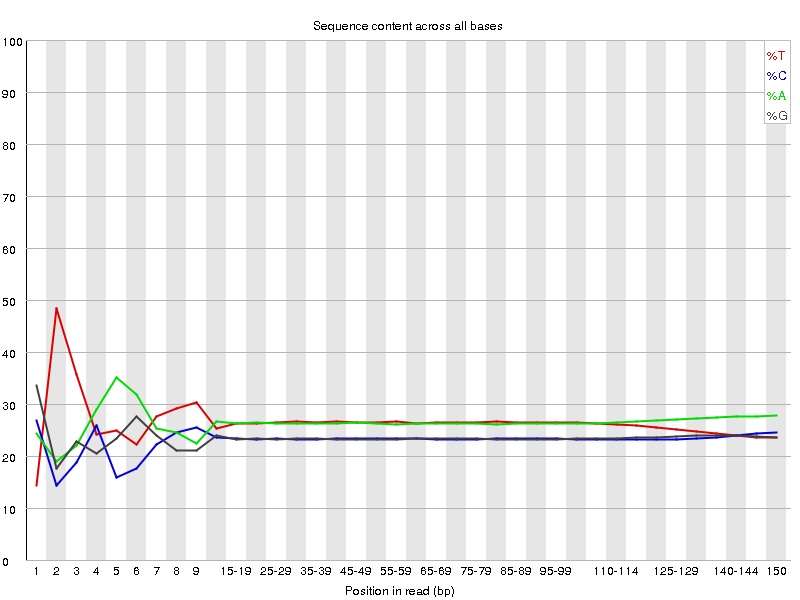
DNA 全基因组测序样本通常呈现“前 10bp 左右波动、之后四线平稳”的形态( 图 3.21 ),平稳区的四条线可以用来读出该物种的 GC 含量——图中 GC 合计约 42%,与人类基因组的已知值一致。GC 含量在同一物种内是相当稳定的量,不同物种间通常不同。
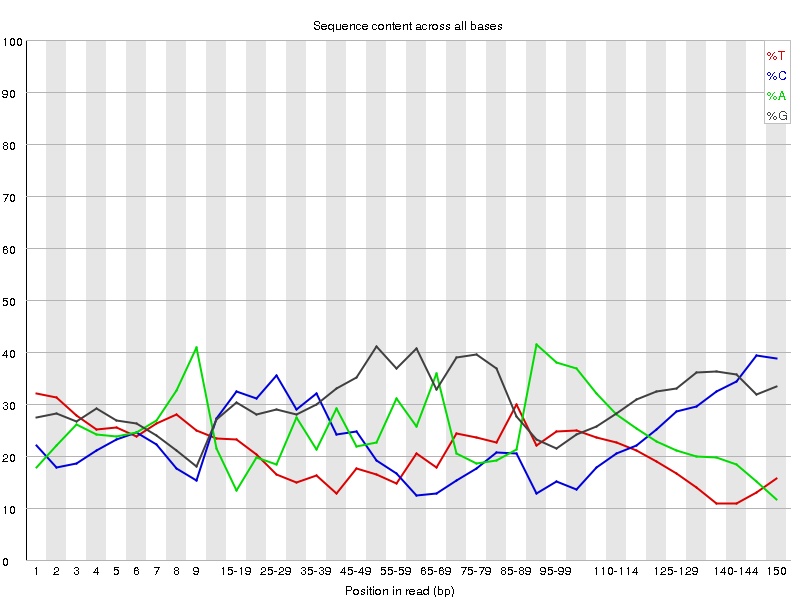
如果四条线全程剧烈波动( 图 3.22 ),说明文库测到的分子群体碱基组成不随机——例如特殊建库富集的 RNA 群体。再如 图 3.20 的小 RNA 样本:文库测到的是 miRNA 等特定的小 RNA 分子,其群体碱基组成本身不随机(例如 miRNA 的第 1 位碱基多为 U),四线不平行、AT 占比偏高属于正常现象。
每序列 GC 含量分布(Per sequence GC content)
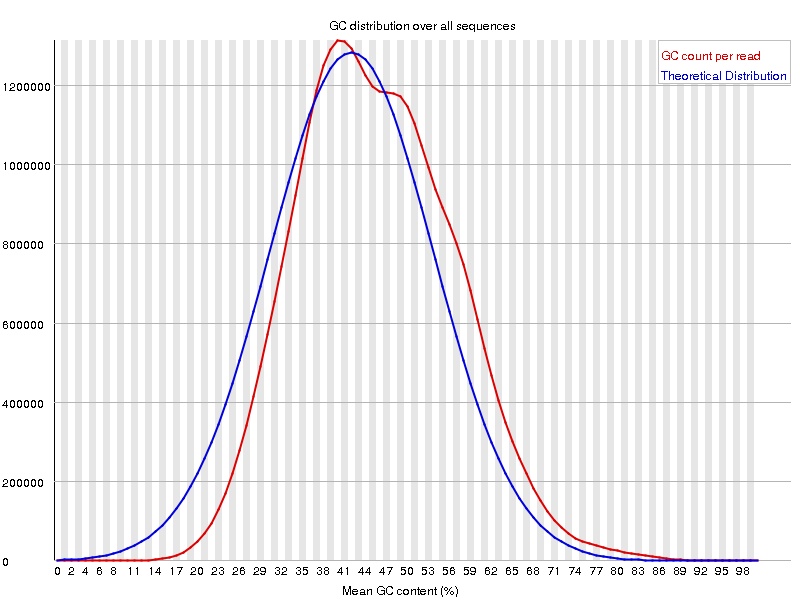
这个模块换了一个视角:对每条 read 计算整体 GC 含量,画所有 reads 的分布曲线( 图 3.23 )。横轴是 GC 含量(0—100%),纵轴是具有相应 GC 含量的 reads 数量;蓝色虚线是根据数据拟合的理论正态分布。随机文库的曲线应是与蓝线基本重合的单峰,峰的位置就是该物种基因组的 GC 含量。
当曲线出现异常形态时需要追问原因。 图 3.24 的曲线出现双峰且偏离理论分布,最常见的解释是混入了其他物种的 DNA(污染),也可能是 rRNA、接头序列或 PCR 过度扩增等造成。
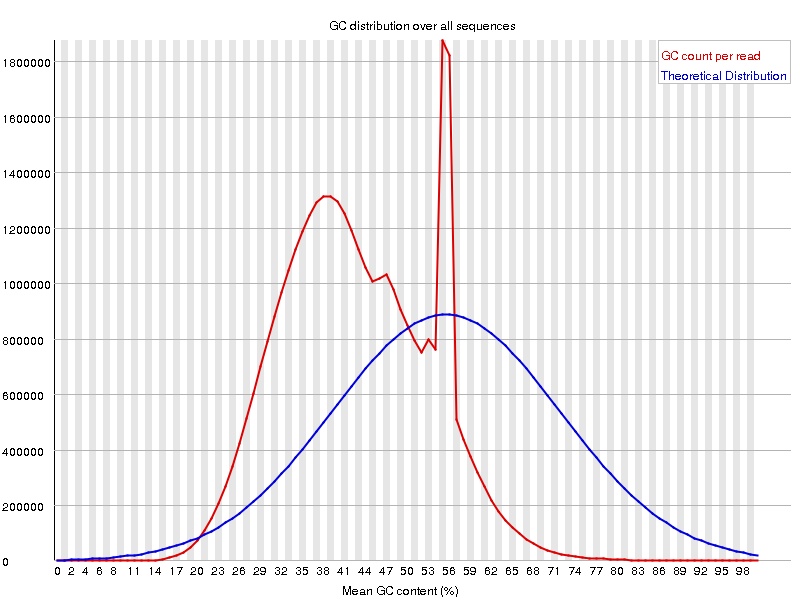
遇到 GC 分布双峰时,可以按下面的思路排查:
- 先把 reads 比对到目标参考基因组,统计 mapping rate;如果比例非常低,说明污染严重,数据基本不可用。
- 如果大部分 reads 比对成功,可把未比对的 reads 拿去做 blast,确认混入的是哪些物种的序列,过滤掉这部分 reads 后一般不影响后续分析。
参考解答要点: 关键量是 mapping rate——它把“分布形状异常”转化为“有多少数据属于目标物种”的可量化判断。
序列长度分布(Sequence Length Distribution)
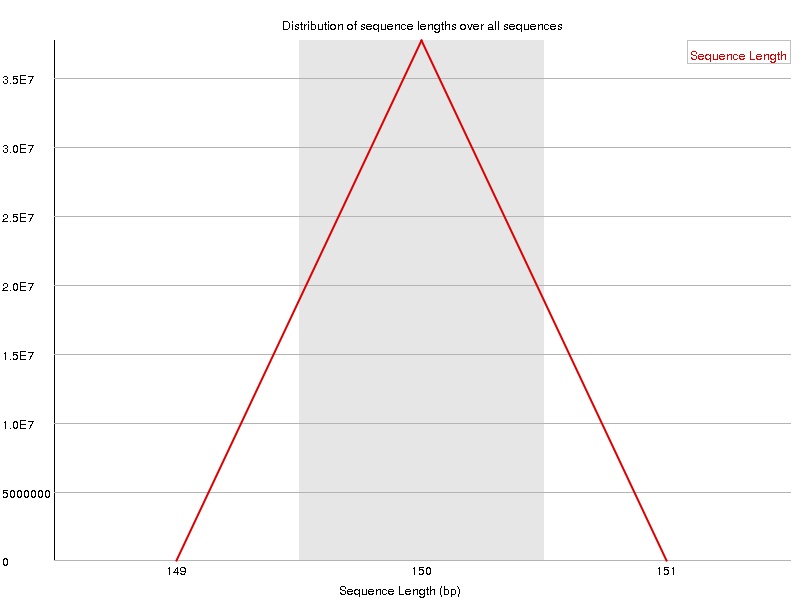
横轴是序列长度,纵轴是相应长度 reads 的数量( 图 3.25 )。刚下机的 Illumina 数据所有 reads 长度一致(如双端 150bp),因为测序循环数固定,图中应是一个尖峰。经过 cutadapt 等工具去除接头后,reads 的长度就会有所不同:有些 insert 被测穿,有些没有,被切掉的长度也不相同。因此,处理后的数据出现长短不一的 reads,通常是正常现象。
重复序列水平(Sequence Duplication Levels)
这个模块统计完全相同(或高度相似)的序列在文库中出现的次数分布:横轴是重复级别(唯一、重复 2 次、重复 3—4 次……),纵轴是相应 reads 的比例。随机片段化的文库应以唯一序列为主;如果高重复级别的比例异常,通常意味着文库复杂度低——样本投入量不足、PCR 扩增轮数过多,或文库本身来源分子有限(如靶向富集、单细胞)。
判定时要区分“重复的原因”。对常规 RNA-seq,duplication 主要来自转录本表达量的天然差异和文库构建,一般不做去重,直接去除反而会破坏表达定量。但对于 PCR 轮数很多的特殊建库(如单细胞 RNA-seq),大量 duplication 是扩增假象,这时需要在建库时加入 random barcode(现在常称 UMI,唯一分子标识符),按 UMI 区分“来自不同原始分子的相同序列”与“同一分子的 PCR 拷贝”,只对后者去重。
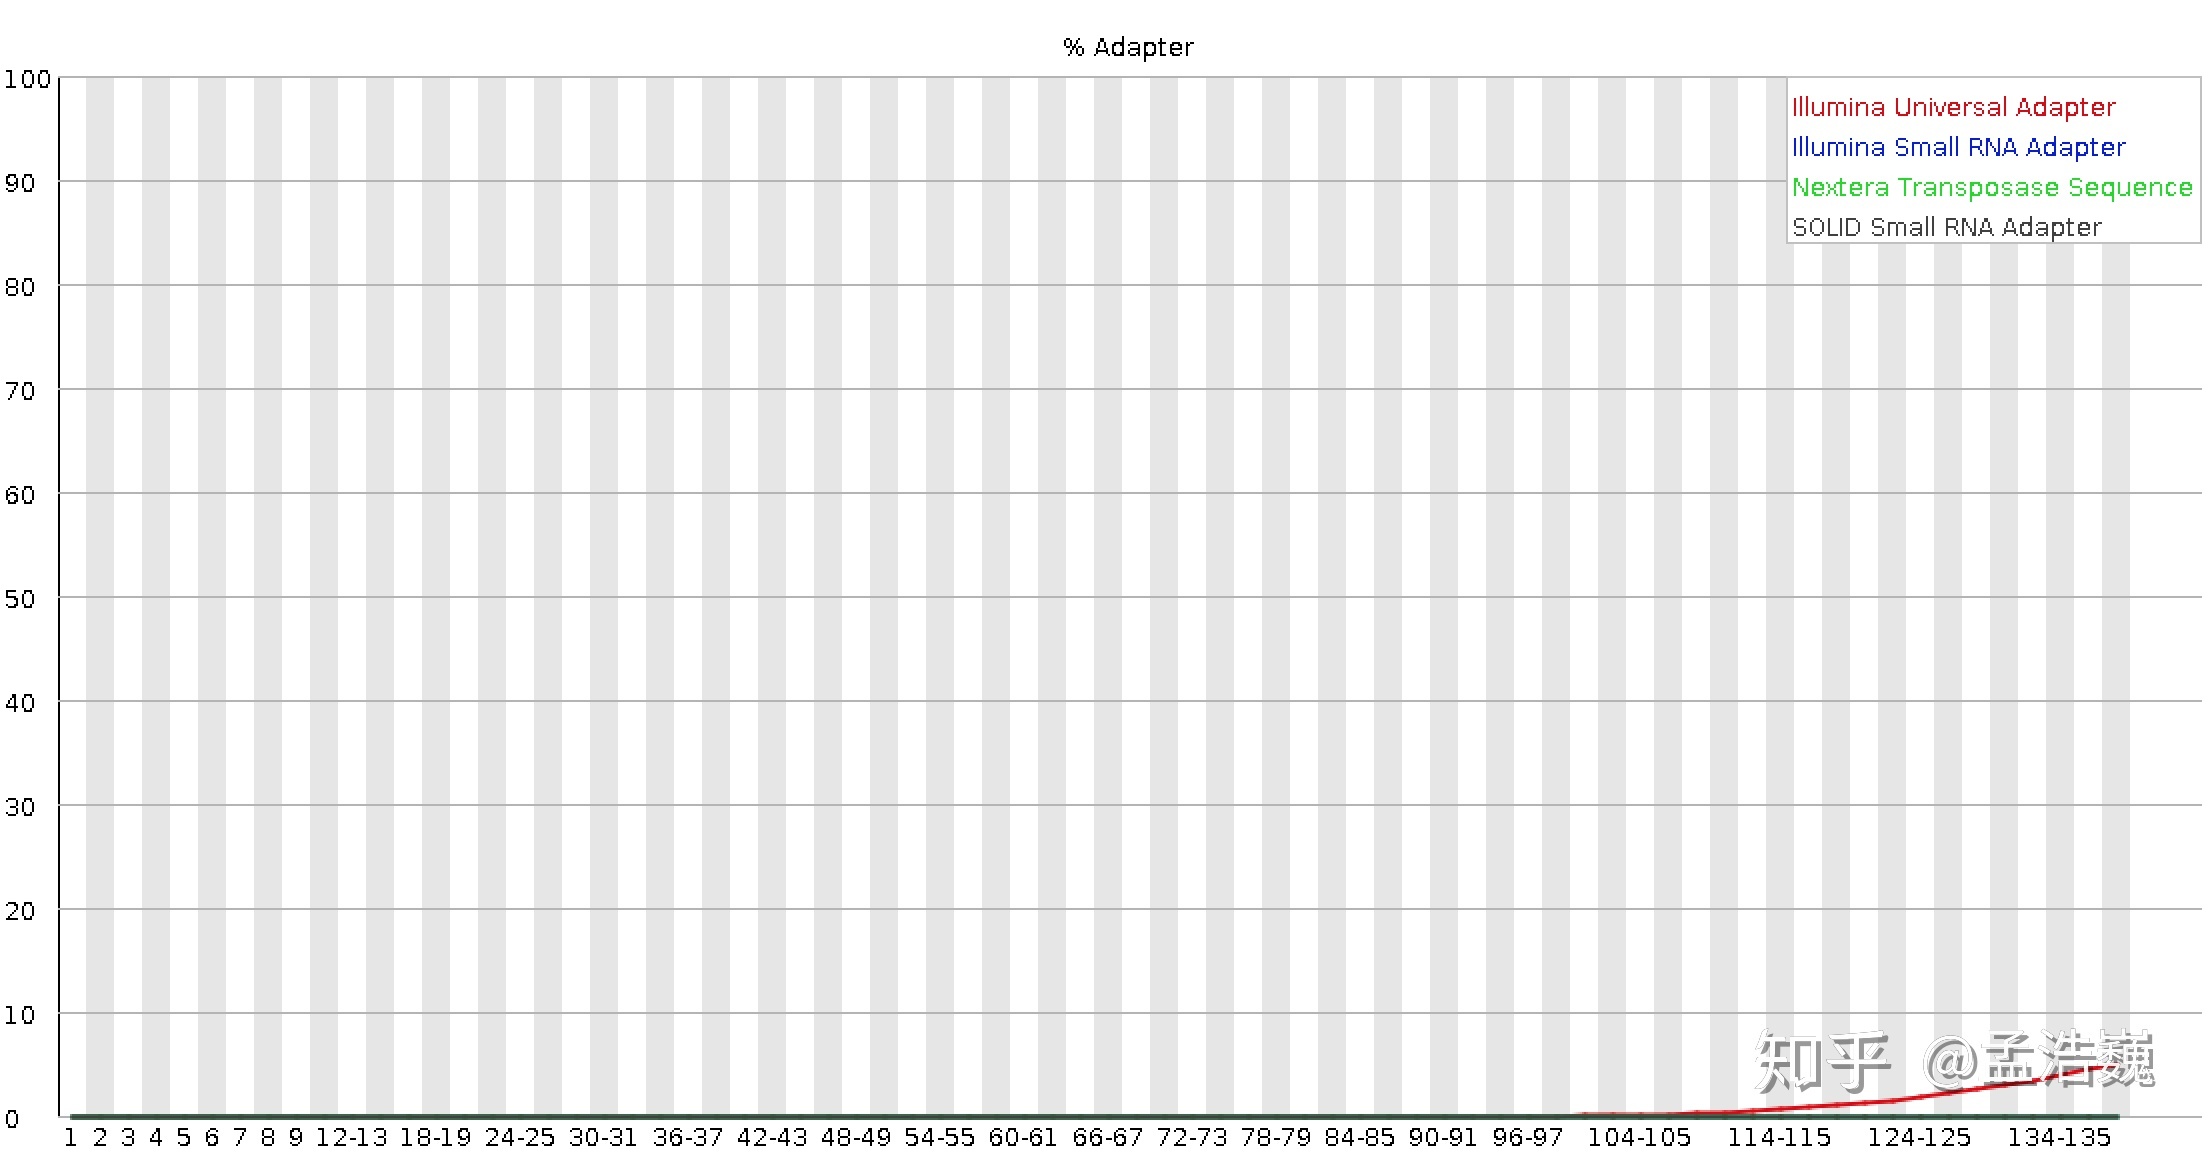
接头含量(Adapter Content)
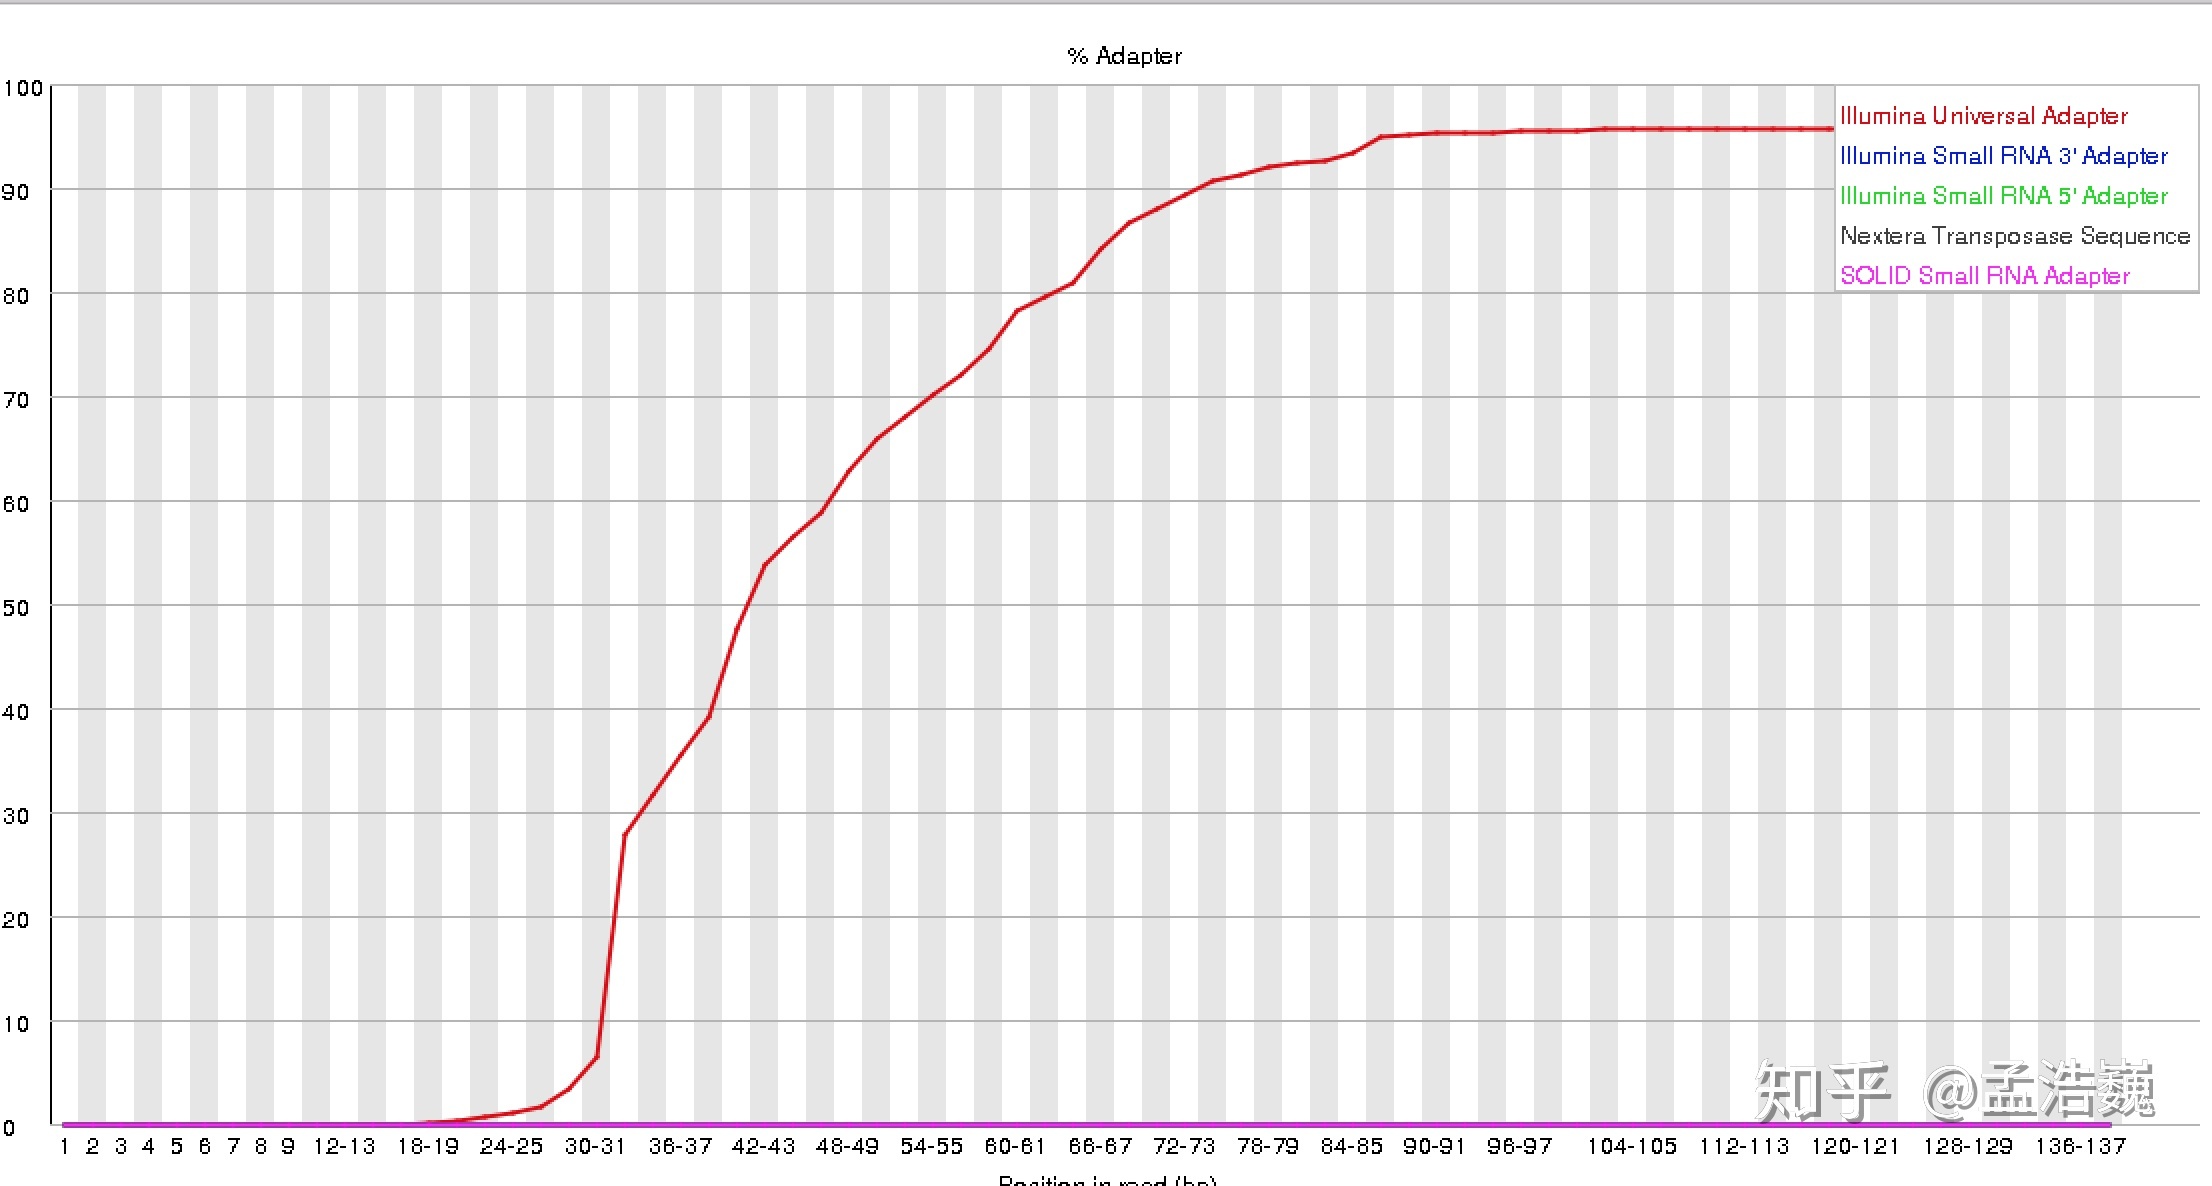
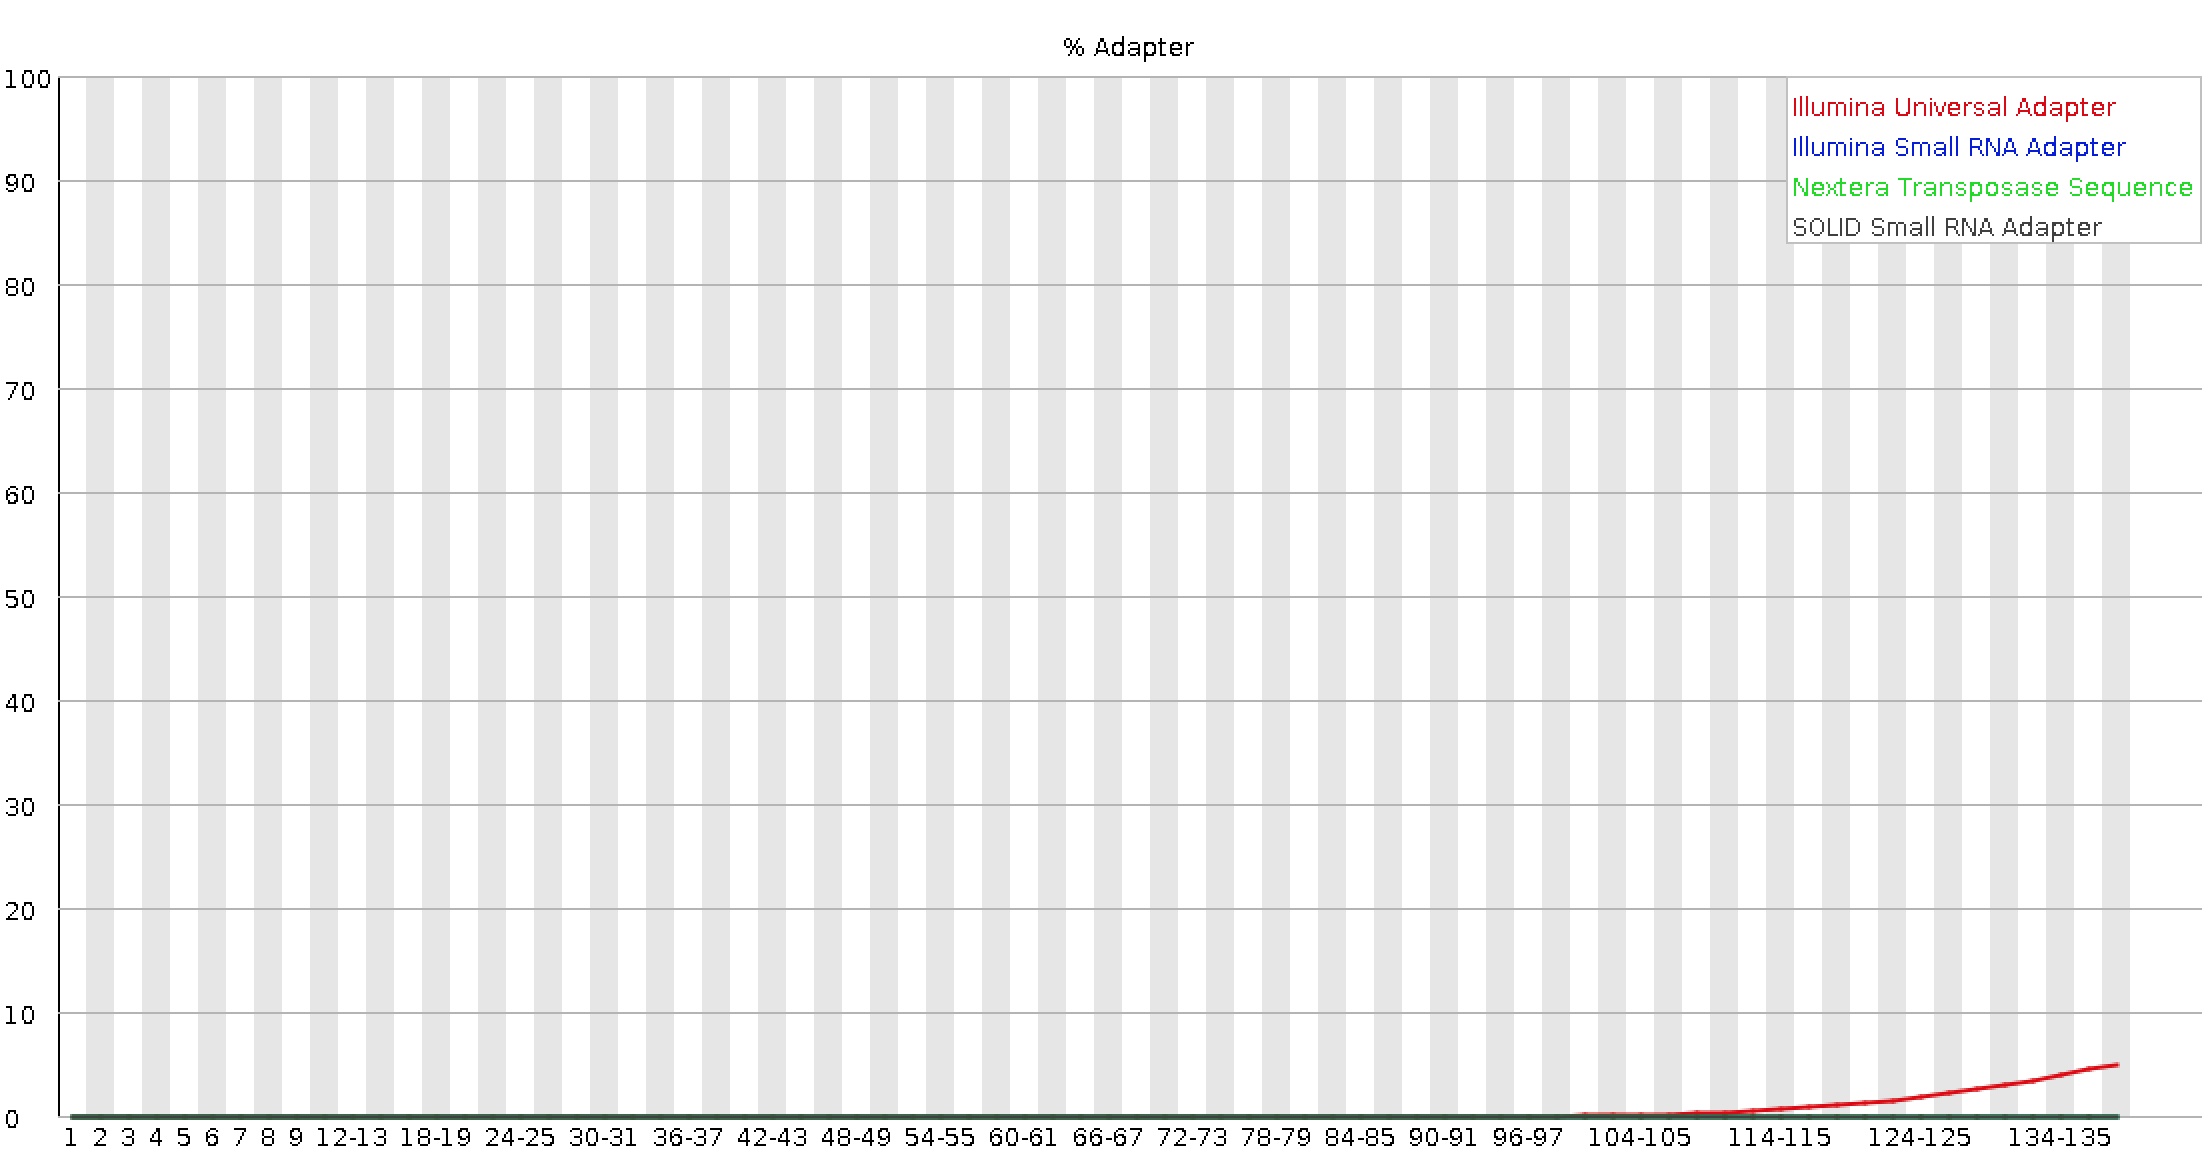
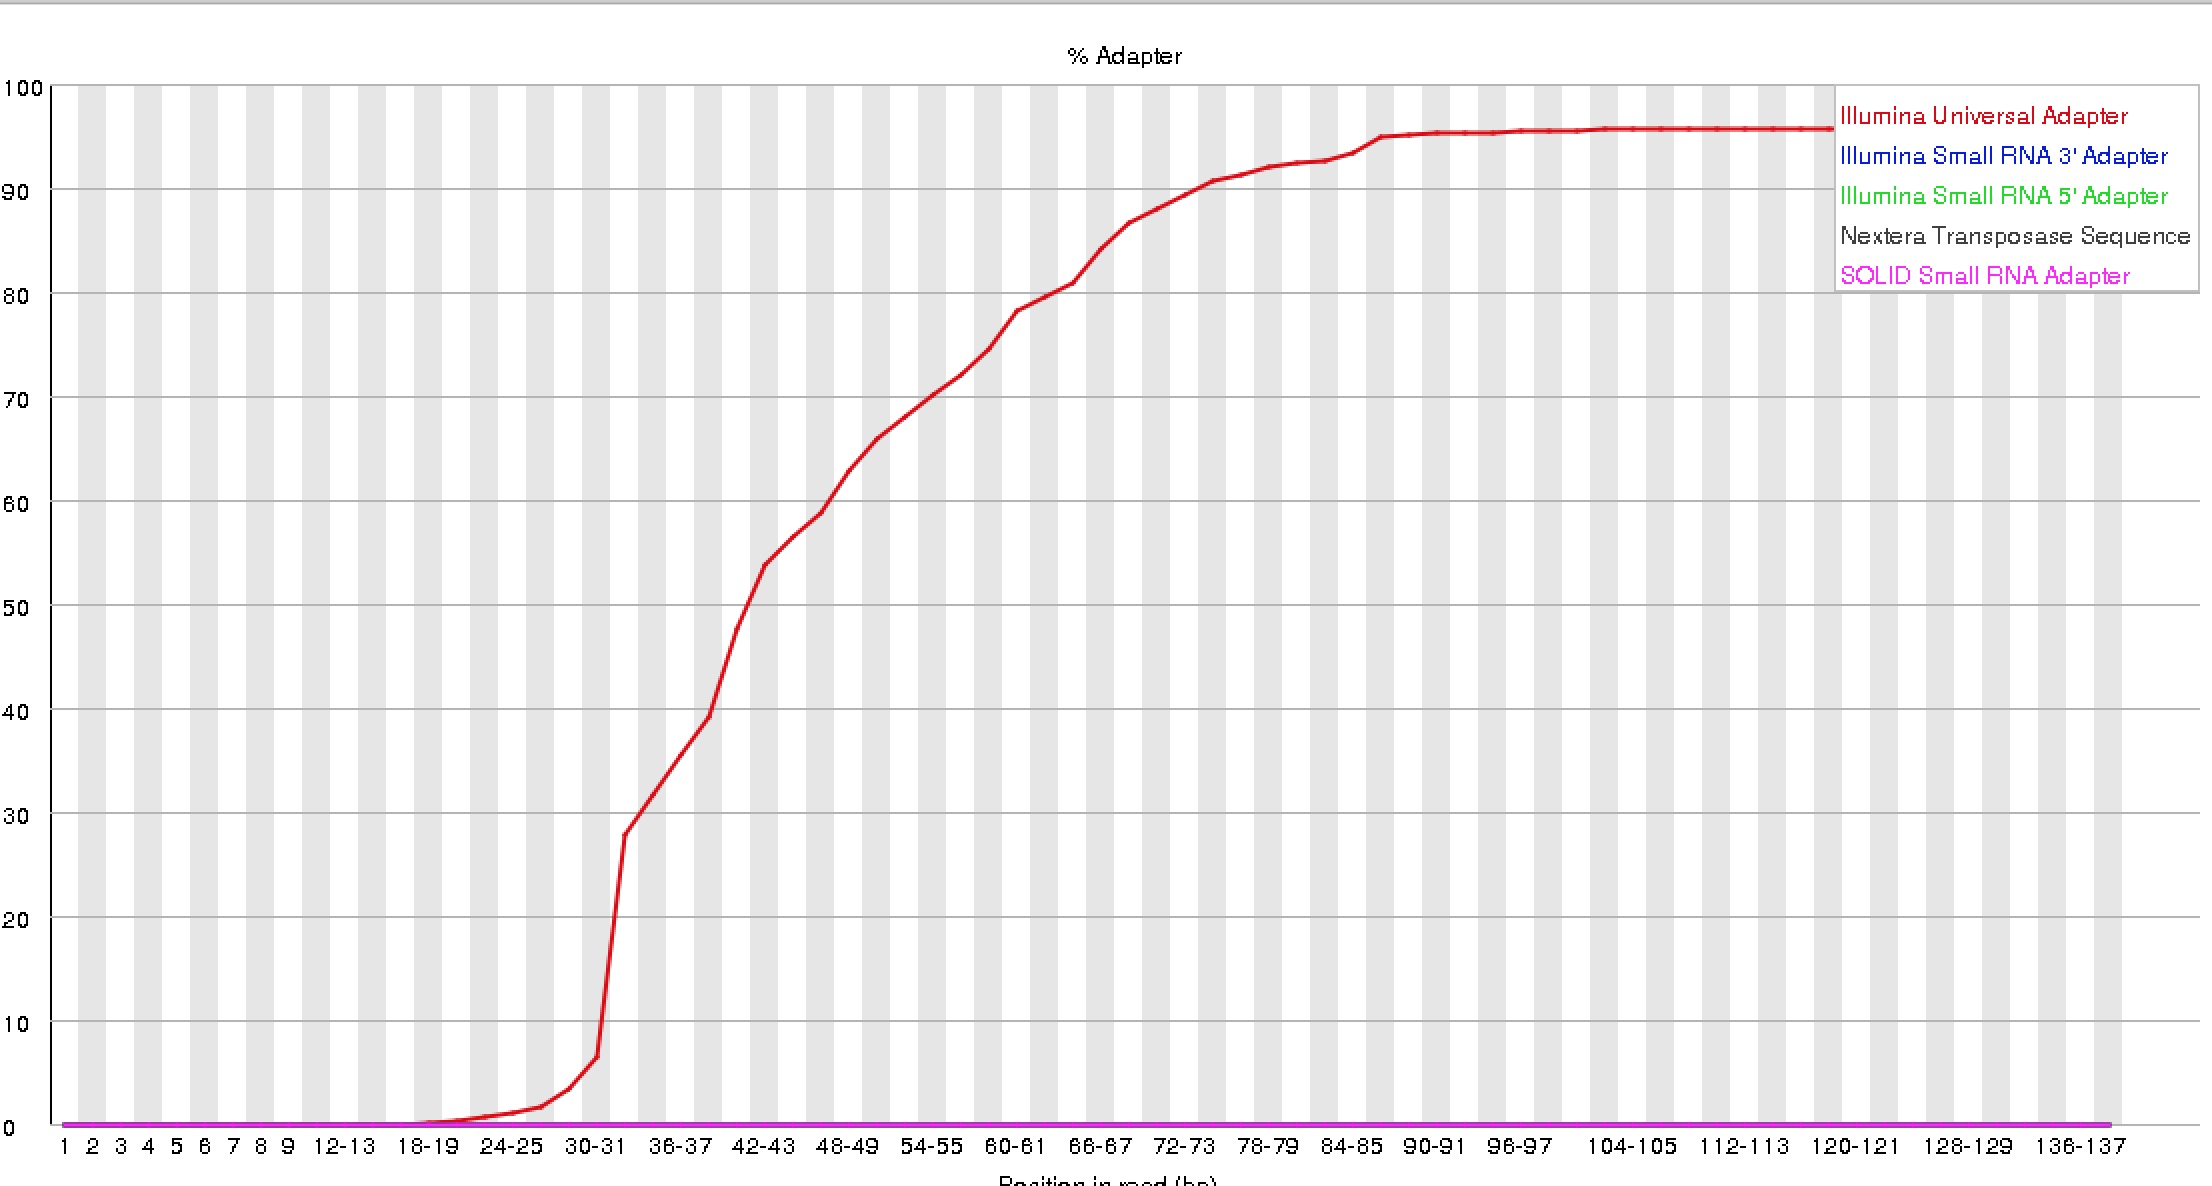
横轴是 read 中的位置,纵轴是相应位置含某种接头序列的 reads 百分比,不同颜色对应不同的通用接头( 图 3.26 、 图 3.27 )。正常文库只有少量 reads 在 3′ 端测穿进入接头;如果 read 后半段接头比例很高(如 图 3.27 ),说明文库插入片段普遍偏短或存在建库问题,必须去除接头才能比对。
统计默认使用的通用接头序列如下(序列中的 * 表示硫代磷酸键修饰,并不是笔误):
Illumina Paired End Adapters (cannot be used for multiplexing)

Top adapter

    5′ ACACTCTTTCCCTACACGACGCTCTTCCGATC*T 3’

Bottom adapter


5′ P-GATCGGAAGAGCGGTTCAGCAGGAATGCCGAG 3’来源:Illumina adapter and primer sequences(CVR 生物信息博客)。如果在运行 FastQC 时没有用 --adapters 选项(旧版本为 -a)指定接头文件,则默认按图例中的通用接头序列统计。
K-mer 含量(Kmer Content)
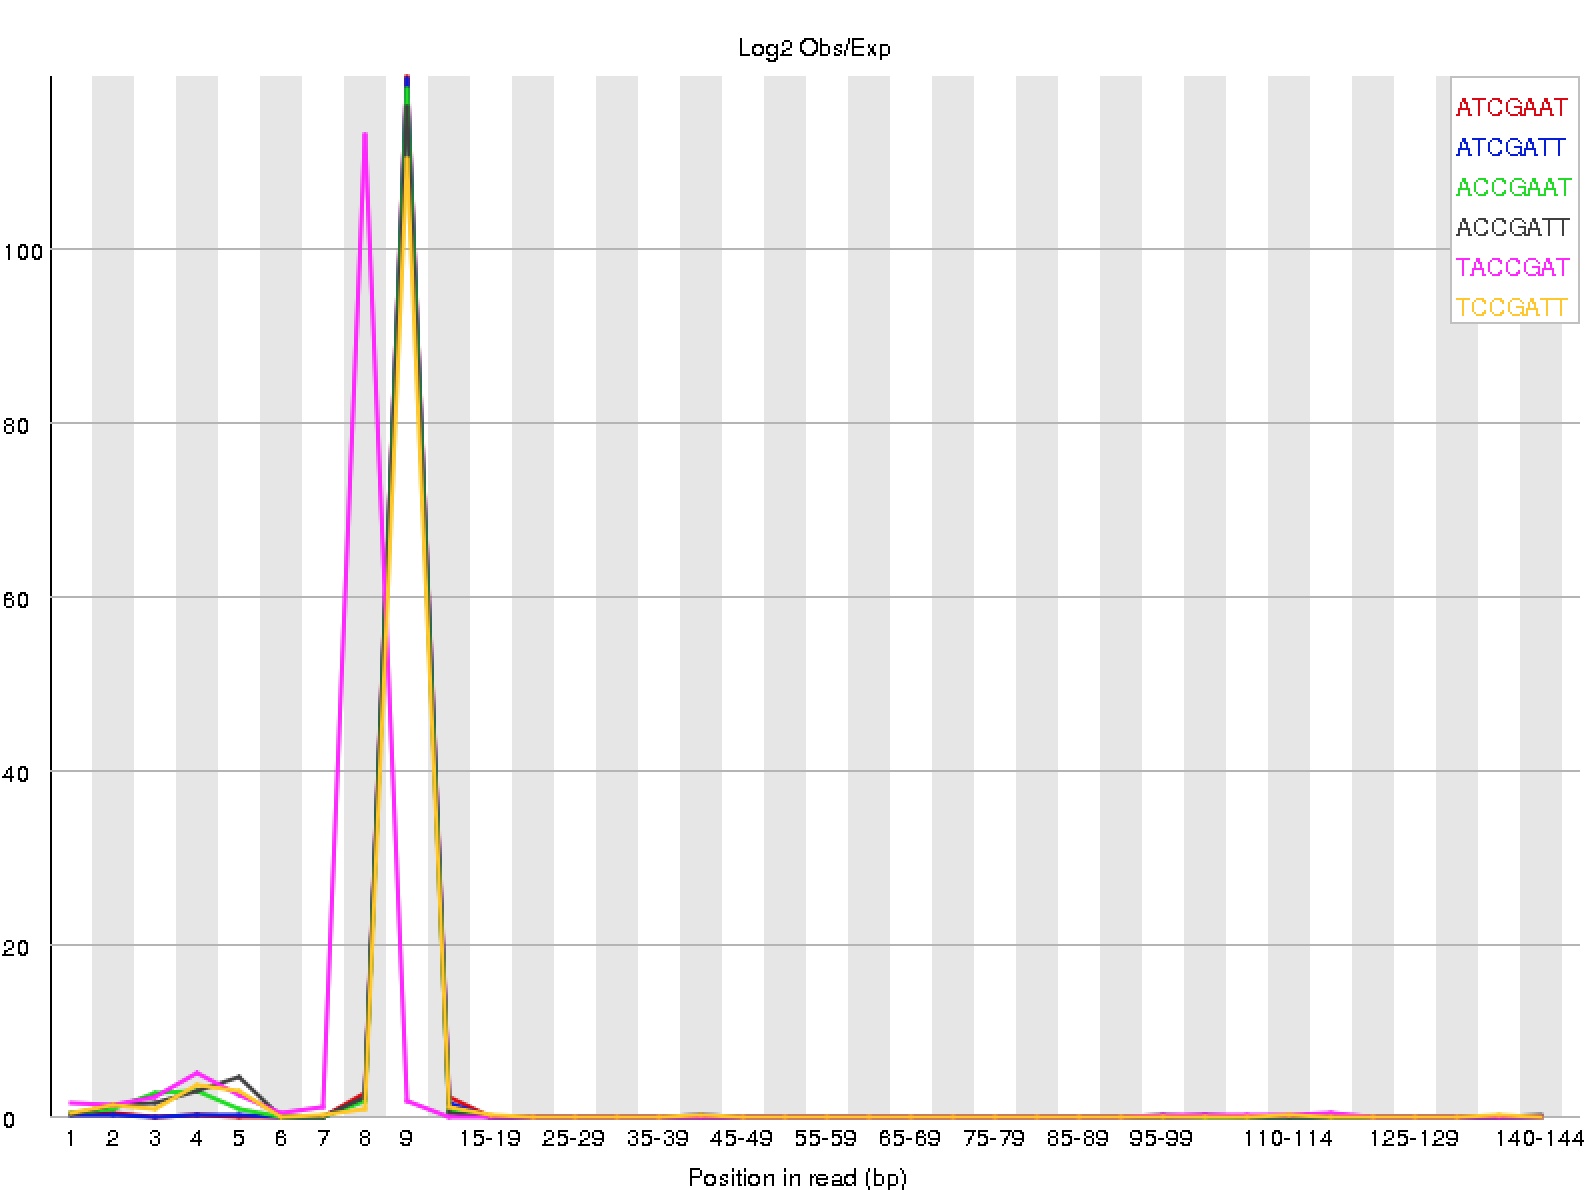
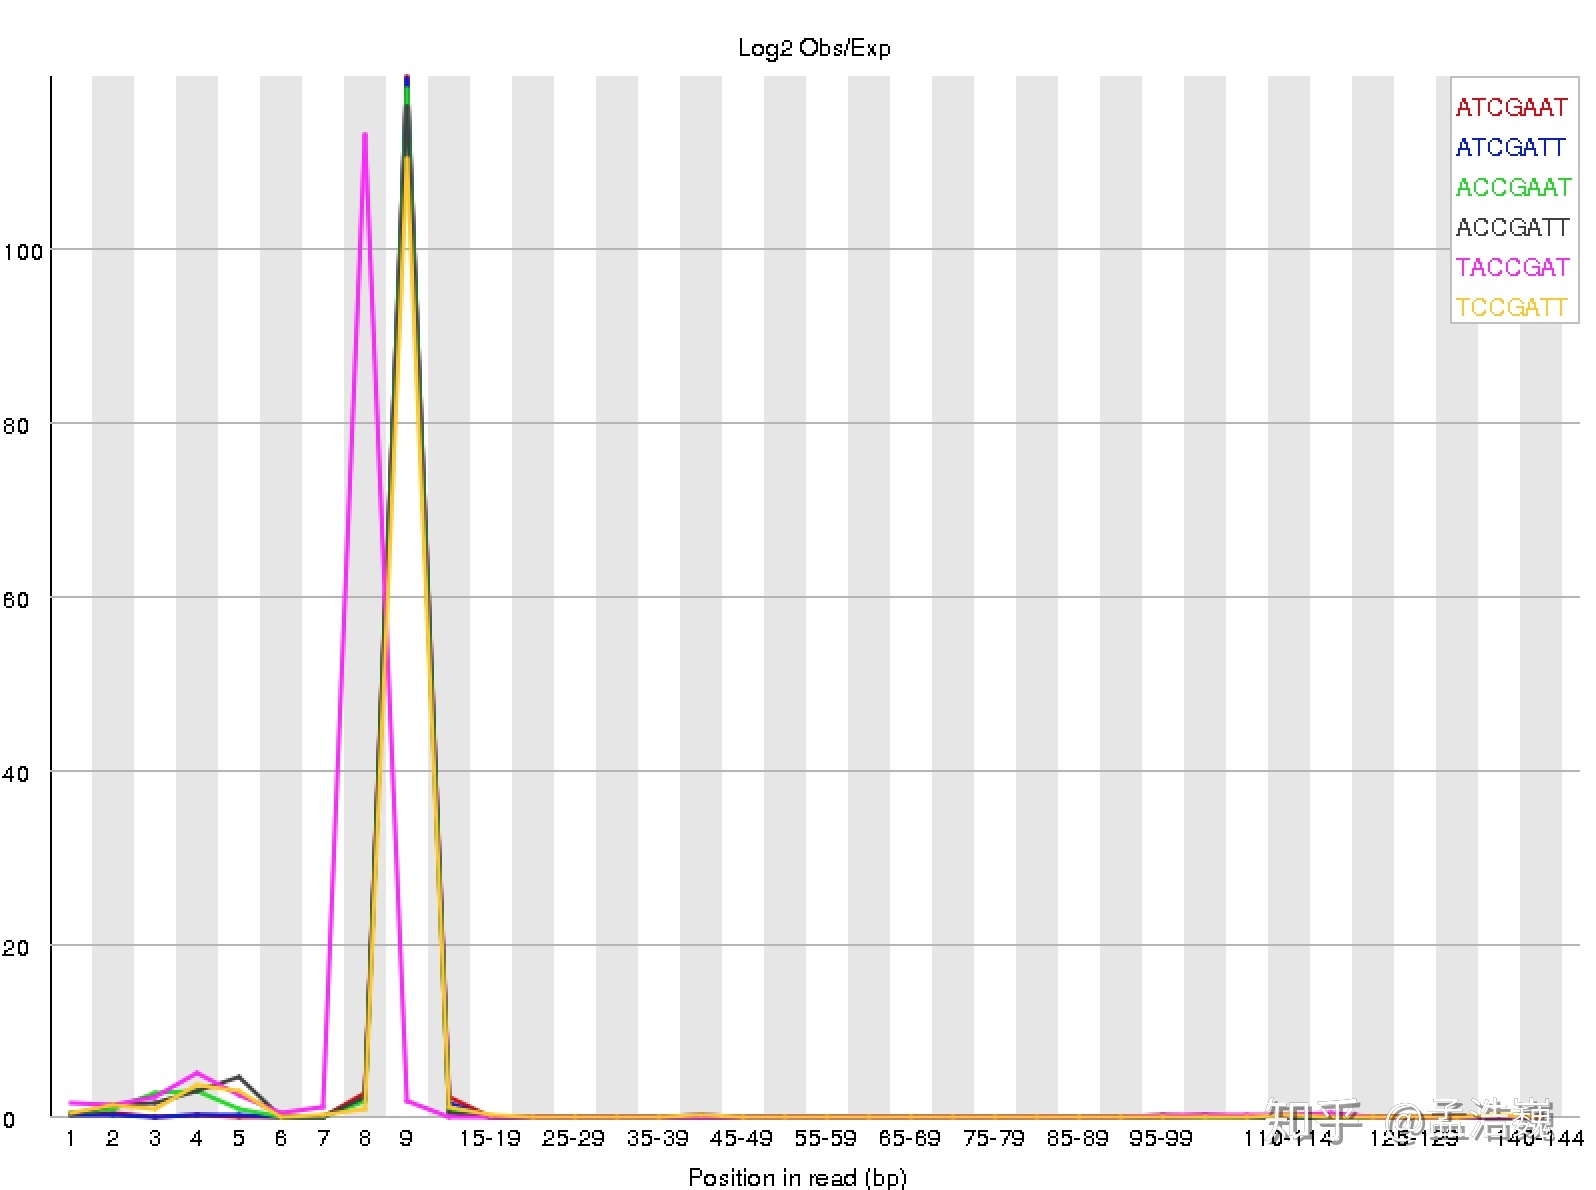
k-mer 指定长的短序列,例如 AATTCCGG 是一个 8-mer。该模块统计每个 7-mer 在 read 各位置的出现频率:横轴是 read 中的位置,纵轴是在对应位置含有该 k-mer 的 reads 百分比,每条线代表一个出现富集的 k-mer( 图 3.29 )。正常文库的短序列不应偏好特定位置;某条线在固定位置明显抬升,说明存在系统性来源——接头、随机引物偏好,或建库时加入的固定序列。
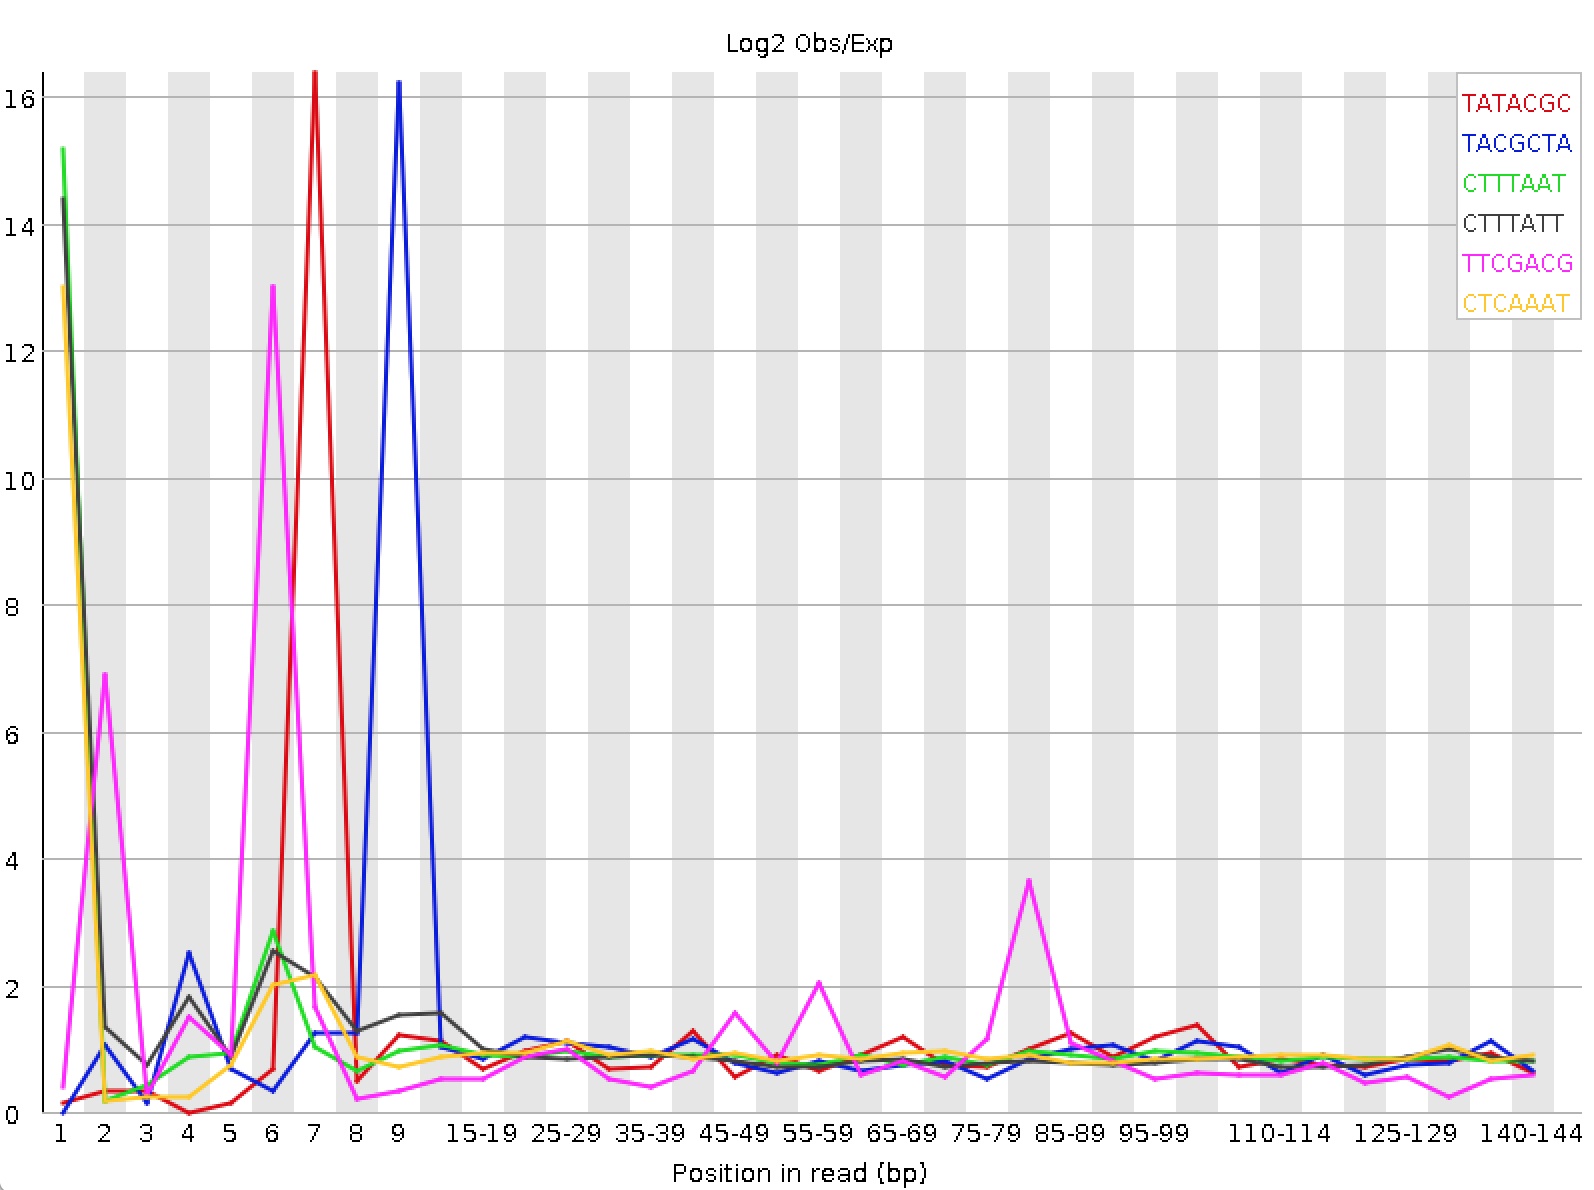
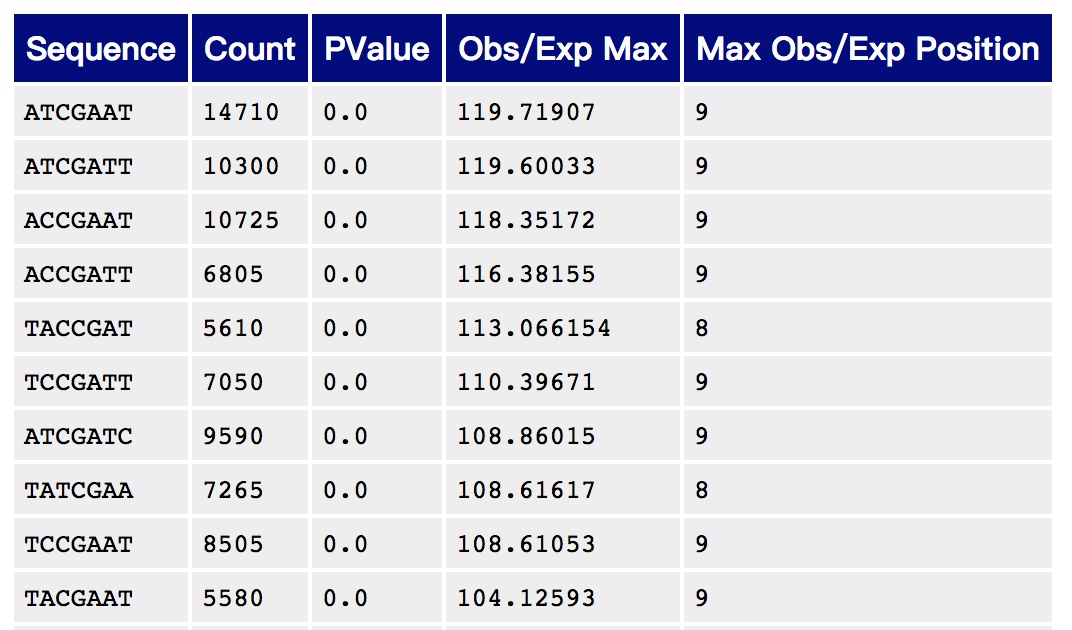
图 3.30 中 kmer 在 read 开头集中富集,原因是建库时在 5′ 端加入了约 10bp 的 random barcode(UMI)——这段固定位置的随机序列本身造成了 kmer 富集,与 图 3.31 的统计表互相印证。表中各列依次是:kmer 序列、该 kmer 在整个文库中被观测到的总次数(Count)、二项分布检验的 P 值、观察值与期望值之比的最大值(Obs/Exp Max)、以及该最大值出现的位置(Max Position)。FastQC 采样约 2% 的 reads 进行统计,序列超过 500bp 时只分析前 500bp。
如何计算 human genome 19(hg19)每一条染色体的 GC 含量?
参考解答:
思路一:从 UCSC 或 Ensembl 下载 hg19 染色体序列,写 Python 程序依次读取每条序列、统计每条染色体的 GC 含量。
思路二:直接使用现成工具按染色体统计碱基组成,再换算 GC 比例。
两种思路都要注意:线粒体染色体(chrM)长度很短且 GC 含量与核染色体差别大,单列统计更容易发现异常。
MultiQC:多样本汇总
实际项目往往一次产出几十上百个样本,逐个打开 FastQC 网页不现实。MultiQC 会扫描指定目录下 FastQC、cutadapt、比对软件等工具的输出,把所有样本的关键指标汇总成可排序的报告表和总览图,例如各样本的数据量、质量趋势、接头比例、mapping rate。常用命令:
multiqc fastqc_result/ -o multiqc_report看报告时,先找出整体比较中异常的样本,再打开相应的 FastQC 报告细看原因。实际项目中,通常将这两种报告配合使用。
3.9 数据清理:去接头与低质量序列
清理数据时,要确定哪些序列需要修剪,保持双端 reads 的配对关系,并检查处理效果。
为什么要清理以及常用工具
质控报告确认数据可用后,进入获取高质量 reads 的步骤。需要清理的内容包括:低质量碱基或 reads、含 N 过多的序列,以及接头序列——用于区分样本的 barcode(index)序列、建库 PCR 扩增所需的引物结合序列,以及与 flowcell 表面寡核苷酸互补配对的序列。这些序列不存在于基因组上,不切除会显著拉低比对率。
常用工具各有侧重。Trimmomatic 的滑动窗口(SLIDINGWINDOW)从 read 一端评估窗口内碱基质量均值,低于阈值时从该处切除后续碱基(配合最低长度参数可丢弃过短 read),还支持接头去除、去除 reads 3′/5′ 端指定长度或低质量碱基。Cutadapt 偏重接头处理:去除 reads 内部或两端的接头,可设置接头错配率、允许接头含 indel、支持通配碱基,也能过滤含 N 过多和低质量的 reads。fastp 把去接头、质量裁剪和报告生成合并为一步完成,是目前快速流程的常见选择。
Fastx-toolkit 与 NGSQC 是早期常用工具,已长期停止维护。本书保留它们的示例,用于理解处理思路和练习。如今的同类操作更常用 Cutadapt、fastp、Trimmomatic(仍在维护)以及 seqtk、seqkit 等。
cutadapt:接头去除的参数
cutadapt 支持单端和双端数据,也支持 gz 格式的自动压缩与解压缩。双端去除接头的常用命令:
cutadapt -a ADAPTER_FWD -A ADAPTER_REV -o out.1.fastq -p out.2.fastq reads.1.fastq reads.2.fastq参数含义:-a 是 read1 3′ 端要去除的接头;-A 是 read2 3′ 端要去除的接头;-o、-p 分别是两端输出文件;最后是两个输入文件。-g/-G 的用法与 -a/-A 类似,但对应 5′ 端接头——常规 Illumina 文库 5′ 端不会测出接头,所以很少用到。
-m 参数指定最小保留长度:切完接头后短于该长度的 read 直接舍弃,因为过短的序列无法可靠比对。-q 参数用于质量裁剪,见下文。
cutadapt:3′ 端质量裁剪的算法
测序中常见 read 的 3′ 端质量较差(例如逐碱基质量图中 3′ 端箱体逐渐下移)。-q 参数可以在去接头的同时切掉低质量末端,例如:
cutadapt -q 10 -o output.fastq input.fastq-q 后的数字是质量阈值,低于该值的碱基将被切除;若文件采用 Phred64 编码,需加 --quality-base=64。
cutadapt 会考虑整个低质量区域,允许其中夹杂质量较好的碱基,再寻找整体最优的切点,并非遇到第一个低质量碱基就停止。以一条 13bp、阈值 10 的 read 为例:
 A   T   G   C   C   G   T   A   C   C   G   G   T
42  42  41  41  40  26  27   8   7  11   4   2   3
第一步,每个质量值减去阈值:
32 32 31 31 30 16 17 -2 -3 1 -6 -8 -7第二步,从 3′ 端向 5′ 端累加,得到每个位置到末尾的累加和:
164 132 100 69 38 8 -8 -25 -23 -20 -21 -15 -7cutadapt 的规则是取累加和最小值(−25)出现的位置——第 8 位——作为裁剪位点,保留其前面的碱基:
A T G C C G T --cut here-- A C C G G T这样处理的好处是可以容忍 3′ 端零星的质量回升,不会因为个别碱基质量突然变好而过早停止裁剪。
3.10 其他常用整理操作
seqkit:FASTQ/FASTA 的多功能工具箱
除了去接头和裁剪,日常还经常需要对 FASTQ/FASTA 做统计、筛选、抽样、截取等整理。seqkit 是一个跨平台、多线程的命令行工具箱,直接读写 gzip 文件,所有子命令共享一致的风格:输入文件作为最后一个参数,-j 指定线程数,-o 指定输出(省略时打印到屏幕,便于先预览再落盘)。下面按常见任务分组介绍代表性用法。
统计与格式转换
最常用的是文件级统计,汇总每个文件的 reads 数、长度、GC 含量和 Q20/Q30 比例,是检查数据概况最快的方式之一:
seqkit stats -a *.fastq.gz想先看看文件内容,可以用 head 取前几条记录。它类似 Linux 的 head,但按序列“条数”而不是文本“行数”计数:
seqkit head -n 4 sample_R1.fastq.gzfx2tab 把序列文件转成制表符分隔的表格,-l 加序列长度、-g 加 GC 含量,便于用 sort、awk 等文本工具继续处理;tab2fx 做反向转换:
seqkit fx2tab -n -l -g genome.fa | head -5按名称或序列筛选
grep 按 ID(-n 按完整名称)或序列匹配提取子集,配合 -f 从文件读取模式列表。FASTA 处理的经典场景——从参考基因组里挑出指定染色体:
seqkit grep -n -p chrM genome.fa -o chrM.fa写一个每行一个名称的 ids.txt(-f ids.txt)即可批量提取;FASTQ 同样适用,例如从大文件中挑出关心的 reads。加 -v 反向排除、-r 启用正则表达式,-C 只显示匹配计数。
截取区间与固定长度
subseq 按坐标截取:-r 1:50 取第 1 到 50 位,-r -12:-1 取末尾 12 位,负数坐标从末尾数起。
seqkit subseq -r 1:50 input.fastq.gz -o trim50.fastq.gz需要统一 reads 长度时(例如某些特定分析流程的输入要求),可以先用质量裁剪,再用 subseq 硬截到固定长度——注意“硬截”不管质量,老一代工具中 fastx_trimmer 也做同样的事。
随机抽样
调试流程或做大数据集的快速预览时,常需要抽取一部分 reads:-p 0.1 按比例抽 10%,-n 100000 按条数抽,-s 是随机种子(固定种子保证可重复):
seqkit sample -p 0.1 -s 11 sample_R1.fastq.gz -o sub_R1.fastq.gz双端数据对 R1、R2 用相同种子分别抽样,即可保持配对关系不变。
序列变换与拆分
seq 对序列本身做变换:-r -p 反向互补、--rna2dna 把 RNA 转成 DNA、-u 统一转大写,建库软件给出的低软遮蔽(小写)序列常需要这一步;-g 去掉比对后序列里的缺口符:
seqkit seq -r -p chrM.fa | seqkit head -n 1需要去重时用专门的 seqkit rmdup(按序列或按名称去除重复记录,-D 统计重复而不删除)。split 把文件拆成多份,-p 4 平均分 4 份,便于并行处理:
seqkit split -p 4 big_R1.fastq.gz综合示例:从参考基因组到 chrM 的 GC 含量
把前面的命令接起来,就可以完成 3.8 节练习里“计算一条染色体 GC 含量”的任务:先用 grep 提取 chrM,再用 fx2tab 输出它的长度与 GC 含量。
seqkit grep -n -p chrM genome.fa | seqkit fx2tab -n -l -g同类工具还有更早的 seqtk(seqtk sample、seqtk trimfq 等)。选择原则是一样的:先明确要做什么,再选工具,用 --help 确认参数含义。
综合练习:等长截取的三步流程
假设你有一个 RNA-Seq 文件需要进行可变剪切分析,要求达到:
- 处理后的 fastq 文件中不包含 adapter 序列;
- 开头 10bp 的 random barcode 需要去掉;
- 最后得到的序列长度完全一致(不满足要求的丢弃)。
输入文件是 input.fastq,系统是 Linux Ubuntu,adapter 序列为 AGATCGGAAGAGCGTCGTGTAGGGAAAGAGTGTAGATCTCGGTGGTCGCCGTATCATT。请参考 cutadapt 与历史工具 fastx_trimmer 的用法,设计处理路线并给出参数。
参考解答: 分三步——先用 FastQC 确认 3′ 端接头与 5′ 端 barcode 的情况;再用 cutadapt 去掉 3′ 端接头并用 -m 保留足够长的序列;最后截掉开头 10bp 并统一到固定长度(fastx_trimmer 的 -f 11 -l 125 表示保留第 11 到 125 位,得到 115bp 的等长序列;现代流程可用 seqkit subseq 完成同样操作):
# step 1, FastQC
fastqc -q -t 3 -o ./FastQC_result ./input.fastq

# step 2, cut adapter
cutadapt -q 25 -m 125 \
-a AGATCGGAAGAGCGTCGTGTAGGGAAAGAGTGTAGATCTCGGTGGTCGCCGTATCATT \
-o input_cutadapt.fq.gz input.fastq

# step 3, trim
zcat input_cutadapt.fq.gz | fastx_trimmer \
-f 11 -l 125 -z -o ./input_cutadapt_trim11_125.fq.gz

# 经过上述 3 个步骤,可以获得长度统一为 115bp 的序列
其中 fastx_trimmer 所属的 fastx_toolkit 是长期停止维护的早期工具,此处保留用于演示流程;实际项目中可用 seqkit subseq -r 11:125 替代第三步。
图片来源:oezratty.net。沿用原稿的来源标注。↩︎
结构依据 US7541444B2,化合物 (18):C5 位经含二硫键的连接子连接 Alexa Fluor 488 的 3′-O-叠氮甲基 dCTP;图中以 Dye 简写染料部分。早期测序循环参见 Bentley DR, et al. Accurate whole human genome sequencing using reversible terminator chemistry. Nature. 2008;456:53–59. DOI。叠氮甲基脱保护的补充说明见 Guo et al. 2008, PNAS;该文采用的混合 SBS 体系与本图专利实例不同。↩︎
图片来源:Huang J. et al. 2017, GigaScience 6(5), doi:10.1093/gigascience/gix024,CC BY 4.0。↩︎
图片来源:Wang Y. et al. 2025, Biosensors 15(1):4, doi:10.3390/bios15010004,CC BY 4.0。↩︎
图片来源:Nova I.C. et al. 2017, PLoS ONE 12(7):e0181599,CC BY 4.0,经 Wikimedia Commons。↩︎